2011计算机学科专业基础综合全卷预览

2011年408真题

2011年408真题完整试卷,包含 40 道选择题和 7 道综合应用题,共 47 题,题目分值合计 152 分。可按目录阅读全卷,展开参考答案解析,或进入对应题目练习。

返回年度练习
47题全卷题目
152分题目分值合计
40题选择题 · 80分
7题综合应用题 · 72分

选择题

40 题 · 共 80 分

第 1 题

数据结构
2 分

设n 是描述问题规模的非负整数,下面程序片段的时间复杂度是( )。

cpp 复制代码
x=2;
while(x<n/2)
	x=2*x;

A. O(log2n)

B. O(n)

C. O(nlog2n)

D. O(n2)

查看答案与解析收起答案与解析

参考答案:A

题目详解:
这段程序的时间复杂度分析如下:

  1. 初始时,x=2 x = 2 ,每次循环 x x 的值变为 2×x 2 \times x ,即 x x 的值按指数增长:2,4,8,16,…,2k 2, 4, 8, 16, \ldots, 2^k 。

  2. 循环的条件是 x<n2 x < \frac{n}{2} ,即当 2k≥n2 2^k \geq \frac{n}{2} 时循环停止。

  3. 解不等式 2k≥n2 2^k \geq \frac{n}{2} ,取对数得:k≥log⁡2(n2)=log⁡2n−1 k \geq \log_2 \left( \frac{n}{2} \right) = \log_2 n - 1 。

  4. 因此,循环的次数 k k 约为 log⁡2n \log_2 n ,时间复杂度为 O(log⁡2n) O(\log_2 n) 。

正确答案:A

进入练习

第 2 题

数据结构
2 分

元素 a, b, c, d, e 依次进入初始为空的栈中,若元素进栈后可停留、可出栈,直到所有元素都出栈,则在所有可能的出栈序列中,以元素d 开头的序列个数是( )。

A. 3

B. 4

C. 5

D. 6

查看答案与解析收起答案与解析

参考答案:B

题目详解:
要计算以 d d 开头的出栈序列个数,首先分析元素 a,b,c,d,e a, b, c, d, e 依次进栈的情况。初始栈为空,元素按顺序 a,b,c,d,e a, b, c, d, e 入栈。

  1. 以 d d 开头的条件:
    元素 d d 必须第一个出栈。这意味着在 d d 出栈时,a,b,c a, b, c 必须已经在栈中(因为它们在 d d 之前入栈),而 e e 尚未入栈(因为 d d 出栈时 e e 还未入栈)。因此,栈的状态为:
    栈内元素=[a,b,c] \text{栈内元素} = [a, b, c] (栈顶为 c c ),d d 刚刚出栈,e e 还未入栈。

  2. 后续出栈的可能性:
    d d 出栈后,栈中剩余 a,b,c a, b, c ,接下来可以执行以下操作:

    • 将 e e 入栈,然后选择出栈顺序。
    • 直接出栈栈中的 a,b,c a, b, c (按栈的顺序出栈)。

    具体步骤如下:

    • d d 出栈后,e e 还未入栈。此时可以选择:
      • 先入栈 e e ,然后 e e 可以随时出栈(只要它在栈顶)。
      • 或者直接出栈 c c (栈顶元素),然后 b b ,最后 a a 。
  3. 计算可能的序列:
    以 d d 开头的出栈序列可以分为以下几种情况:

    • d d 出栈后,立即出栈 c,b,a c, b, a ,然后入栈 e e 并出栈 e e 。序列为:d,c,b,a,e d, c, b, a, e 。
    • d d 出栈后,出栈 c,b c, b ,然后入栈 e e 并出栈 e e ,最后出栈 a a 。序列为:d,c,b,e,a d, c, b, e, a 。
    • d d 出栈后,出栈 c c ,然后入栈 e e 并出栈 e e ,接着出栈 b,a b, a 。序列为:d,c,e,b,a d, c, e, b, a 。
    • d d 出栈后,直接入栈 e e 并出栈 e e ,然后出栈 c,b,a c, b, a 。序列为:d,e,c,b,a d, e, c, b, a 。

    因此,总共有 4 4 种可能的出栈序列以 d d 开头。

正确答案:B

进入练习

第 3 题

数据结构
2 分

已知循环队列存储在一维数组A[0...n-1] 中,且队列非空时front 和rear 分别指向队头元素和队尾元素。若初始时队列为空,且要求第 1 个进入队列的元素存储在 A[0] 处,则初始时 front 和rear 的值分别是( )。

A. 0, 0

B. 0, n-1

C. n-1,0

D. n-1, n-1

查看答案与解析收起答案与解析

参考答案:B

题目详解:
循环队列的初始状态为空时,通常需要满足 front==rear front == rear 。但根据题目要求,第 1 个进入队列的元素必须存储在 A[0] A[0] 处。为了实现这一点,我们需要分析队列的入队操作。

在循环队列中,入队操作通常是将元素放入 rear rear 指向的位置,然后 rear rear 向后移动一位。为了确保第一个元素 A[0] A[0] 被正确放入,rear rear 的初始位置应该满足:(rear+1)mod  n=0 (rear + 1) \mod n = 0 。因此,rear rear 的初始值应为 n−1 n-1 ,因为:

(n−1+1)mod  n=0mod  n=0(n-1 + 1) \mod n = 0 \mod n = 0

而 front front 的初始值应为 0 0 ,因为队列为空时 front front 和 rear rear 的关系需要满足初始条件,且 front front 指向队头元素的位置(此时队列为空,但 front front 的逻辑位置为 0 0 )。

综上,初始时 front front 和 rear rear 的值分别是 0 0 和 n−1 n-1 。

正确答案:B

进入练习

第 4 题

数据结构
2 分

若一棵完全二叉树有 768 个结点,则该二叉树中叶结点的个数是( )。

A. 257

B. 258

C. 384

D. 385

查看答案与解析收起答案与解析

参考答案:C

题目详解:
对于一棵完全二叉树,设其结点总数为 n n ,叶结点数为 L L ,非叶结点数为 N N 。根据完全二叉树的性质,有以下关系:

  1. 对于任意二叉树,结点总数 n=L+N n = L + N 。
  2. 在完全二叉树中,非叶结点数 N N 与叶结点数 L L 的关系为 N=⌊n2⌋ N = \left\lfloor \frac{n}{2} \right\rfloor ,而 L=n−N L = n - N 。

给定 n=768 n = 768 ,计算非叶结点数:
N=⌊7682⌋=384 N = \left\lfloor \frac{768}{2} \right\rfloor = 384

因此,叶结点数为:
L=n−N=768−384=384 L = n - N = 768 - 384 = 384

正确答案是 C。

进入练习

第 5 题

数据结构
2 分

若一棵二叉树的前序遍历序列和后序遍历序列分别为 1, 2, 3, 4 和4, 3, 2, 1, 则该二叉树的中序遍历序列不会是( )。

A. 1, 2, 3, 4

B. 2, 3, 4, 1

C. 3, 2, 4, 1

D. 4, 3, 2, 1

查看答案与解析收起答案与解析

参考答案:C

题目详解:
首先,根据题目给出的前序遍历序列 1,2,3,4 1, 2, 3, 4 和后序遍历序列 4,3,2,1 4, 3, 2, 1 ,我们可以推断出二叉树的结构。

  1. 前序遍历的第一个节点 1 1 是根节点,后序遍历的最后一个节点 1 1 也是根节点。因此,1 1 是二叉树的根节点。
  2. 前序遍历的第二个节点是 2 2 ,说明 2 2 是 1 1 的左子节点或右子节点。
  3. 后序遍历中 2 2 出现在倒数第二个位置,说明 2 2 是 1 1 的左子节点或右子节点中较靠近根节点的部分。

接下来,我们尝试构造可能的二叉树结构:

  • 情况1:1 1 的左子节点是 2 2 ,2 2 的左子节点是 3 3 ,3 3 的左子节点是 4 4 。此时中序遍历为 4,3,2,1 4, 3, 2, 1 (选项D)。
  • 情况2:1 1 的左子节点是 2 2 ,2 2 的右子节点是 3 3 ,3 3 的右子节点是 4 4 。此时中序遍历为 2,3,4,1 2, 3, 4, 1 (选项B)。
  • 情况3:1 1 的右子节点是 2 2 ,2 2 的右子节点是 3 3 ,3 3 的右子节点是 4 4 。此时中序遍历为 1,2,3,4 1, 2, 3, 4 (选项A)。

现在检查选项C 3,2,4,1 3, 2, 4, 1 :

  • 这种中序遍历要求 3 3 在 2 2 的左边,4 4 在 2 2 的右边。但在前序遍历中 2 2 出现在 3 3 之前,说明 2 2 是 3 3 的父节点或祖先节点,无法满足 3 3 在 2 2 的左边且 4 4 在 2 2 的右边的结构。因此,选项C是不可能的。

正确答案:C

进入练习

第 6 题

数据结构
2 分

已知一棵有 2011 个结点的树,其叶结点个数为 116, 该树对应的二叉树中无右孩子的结点个数是( )。

A. 115

B. 116

C. 1895

D. 1896

查看答案与解析收起答案与解析

参考答案:D

题目详解:
正确答案:D

树转化为二叉树时,树中每一个分支结点的所有子结点中的最右子结点无右孩子,根结点转换后也没有右孩子,因此,对应的二叉树中无右孩子的结点个数=分支结点数+1 = 2011-116+1 = 1896。通常本题应采用特殊法解,设题意中的树是如右图所示的结构,则对应的二叉树中仅有前 115 个叶结点有右孩子,故无右孩子的结点个数 = 2011-115 = 1896。

进入练习

第 7 题

数据结构
2 分

对于下列关键字序列,不可能构成某二叉排序树中一条查找路径的序列是( )。

A. 95, 22, 91, 24, 94, 71

C. 21, 89, 77, 29, 36, 38

B. 92, 20, 91, 34, 88, 35

D. 12, 25, 71, 68, 33, 34

查看答案与解析收起答案与解析

参考答案:A

题目详解:
在二叉排序树(BST)中,查找路径必须满足以下性质:对于路径中的任意两个相邻节点 x x 和 y y ,如果 y y 是 x x 的左子树中的节点,则 y<x y < x ;如果 y y 是 x x 的右子树中的节点,则 y>x y > x 。我们需要检查每个选项是否满足这一性质。

选项A:95, 22, 91, 24, 94, 71

  1. 95→22 95 \rightarrow 22 :22<95 22 < 95 ,合法(左子树)。
  2. 22→91 22 \rightarrow 91 :91>22 91 > 22 ,合法(右子树)。
  3. 91→24 91 \rightarrow 24 :24<91 24 < 91 ,合法(左子树)。
  4. 24→94 24 \rightarrow 94 :94>24 94 > 24 ,但 94 94 也大于 91 91 (24 24 是 91 91 的左子树中的节点,因此 94 94 必须小于 91 91 ),矛盾。因此,该序列不合法。

选项B:92, 20, 91, 34, 88, 35

  1. 92→20 92 \rightarrow 20 :20<92 20 < 92 ,合法(左子树)。
  2. 20→91 20 \rightarrow 91 :91>20 91 > 20 ,合法(右子树)。
  3. 91→34 91 \rightarrow 34 :34<91 34 < 91 ,合法(左子树)。
  4. 34→88 34 \rightarrow 88 :88>34 88 > 34 ,合法(右子树)。
  5. 88→35 88 \rightarrow 35 :35<88 35 < 88 ,合法(左子树)。

该序列合法。

选项C:21, 89, 77, 29, 36, 38

  1. 21→89 21 \rightarrow 89 :89>21 89 > 21 ,合法(右子树)。
  2. 89→77 89 \rightarrow 77 :77<89 77 < 89 ,合法(左子树)。
  3. 77→29 77 \rightarrow 29 :29<77 29 < 77 ,合法(左子树)。
  4. 29→36 29 \rightarrow 36 :36>29 36 > 29 ,合法(右子树)。
  5. 36→38 36 \rightarrow 38 :38>36 38 > 36 ,合法(右子树)。

该序列合法。

选项D:12, 25, 71, 68, 33, 34

  1. 12→25 12 \rightarrow 25 :25>12 25 > 12 ,合法(右子树)。
  2. 25→71 25 \rightarrow 71 :71>25 71 > 25 ,合法(右子树)。
  3. 71→68 71 \rightarrow 68 :68<71 68 < 71 ,合法(左子树)。
  4. 68→33 68 \rightarrow 33 :33<68 33 < 68 ,合法(左子树)。
  5. 33→34 33 \rightarrow 34 :34>33 34 > 33 ,合法(右子树)。

该序列合法。

综上所述,只有选项A的序列不满足二叉排序树查找路径的性质。

正确答案:A

进入练习

第 8 题

数据结构
2 分

下列关于图的叙述中,正确的是( )。

I. 回路是简单路径

II. 存储稀疏图,用邻接矩阵比邻接表更省空间

III. 若有向图中存在拓扑序列,则该图不存在回路

A. 仅II

B. 仅I 、II

C. 仅III

D. 仅1 、III

查看答案与解析收起答案与解析

参考答案:C

题目详解:
关于题目中的三个叙述,我们逐一分析:

I. 回路是简单路径:

  • 简单路径的定义是路径中所有顶点互不相同(除了起点和终点可能相同)。
  • 回路是指起点和终点相同的路径。如果回路中除了起点和终点外还有其他顶点重复,则不是简单路径。
  • 因此,回路不一定是简单路径。叙述I是错误的。

II. 存储稀疏图,用邻接矩阵比邻接表更省空间:

  • 邻接矩阵的空间复杂度为 O(n2) O(n^2) ,其中 n n 是顶点数。
  • 邻接表的空间复杂度为 O(n+e) O(n + e) ,其中 e e 是边数。
  • 对于稀疏图( e≪n2 e \ll n^2 ),邻接表显然更省空间。叙述II是错误的。

III. 若有向图中存在拓扑序列,则该图不存在回路:

  • 拓扑排序的前提是图必须是有向无环图(DAG)。
  • 如果图中存在回路,则无法进行拓扑排序。因此,存在拓扑序列意味着图中没有回路。叙述III是正确的。

综上所述,只有叙述III是正确的。

正确答案:C

进入练习

第 9 题

数据结构
2 分

为提高散列(Hash) 表的查找效率,可以采取的正确措施是( )。

I. 增大装填(载)因子

II. 设计冲突(碰撞)少的散列函数

III. 处理冲突(碰撞)时避免产生聚集(堆积)现象

A. 仅I

B. 仅II

C. 仅I、II

D. 仅II、III

查看答案与解析收起答案与解析

参考答案:D

题目详解:
散列(Hash)表的查找效率主要受以下因素影响:

  1. 装填因子(Load Factor):装填因子 α \alpha 定义为表中已存储的元素个数 n n 与散列表大小 m m 的比值,即 α=nm \alpha = \frac{n}{m} 。增大装填因子会导致冲突概率增加,从而降低查找效率。因此,I是错误的。

  2. 散列函数的设计:一个好的散列函数应尽可能均匀分布键值,减少冲突。因此,II是正确的。

  3. 冲突处理方式:聚集(堆积)现象会显著降低查找效率。采用合适的冲突处理方法(如开放寻址法中的双重散列或链地址法)可以避免聚集现象。因此,III是正确的。

综上所述,提高散列表查找效率的正确措施是II和III。

正确答案:D

进入练习

第 10 题

数据结构
2 分

为实现快速排序算法, 待排序序列宜采用的存储方式是( )。

A. 顺序存储

B. 散列存储

C. 链式存储

D. 索引存储

查看答案与解析收起答案与解析

参考答案:A

题目详解:
快速排序算法(Quick Sort)是一种基于分治策略的高效排序算法,其核心操作是 分区(Partition),即通过选取一个基准元素(pivot)将序列划分为两个子序列,使得左边的元素均小于等于基准,右边的元素均大于等于基准。这一过程需要频繁 随机访问 和 交换元素,因此对存储方式有以下要求:

  1. 顺序存储(数组)支持 O(1) O(1) 时间的随机访问,能直接通过下标快速定位元素,满足分区时的高效数据交换需求。例如,若基准选为 arr[low] arr[low] ,算法需从 arr[high] arr[high] 开始逆向比较,顺序存储可立即访问任意位置。

  2. 链式存储(链表)虽然支持动态增删,但访问第 i i 个元素需 O(n) O(n) 时间遍历,交换节点指针的效率远低于数组的直接交换,不适用于快速排序的高效分区要求。

  3. 散列存储 和 索引存储 的设计目标分别是快速查找和辅助检索,而非连续位置的频繁交换,无法满足排序需求。

综上,顺序存储是快速排序的最优选择。
正确答案:A

进入练习

第 11 题

数据结构
2 分

已知序列 25, 13, 10, 12, 9 是大根堆,在序列尾部插入新元素 18,将其再调整为大根堆,调整过程中元素之间进行的比较次数是( )。

A. 1

B. 2

C. 4

D. 5

查看答案与解析收起答案与解析

参考答案:B

题目详解:
初始大根堆序列为:25,13,10,12,9 25, 13, 10, 12, 9 。在尾部插入新元素 18 18 后,序列变为:25,13,10,12,9,18 25, 13, 10, 12, 9, 18 。需要将 18 18 调整到合适的位置以满足大根堆的性质。调整过程如下:

  1. 比较 18 18 与其父节点 12 12 (索引为 ⌊(6−1)/2⌋=2 \lfloor (6-1)/2 \rfloor = 2 ),发现 18>12 18 > 12 ,交换 18 18 和 12 12 ,序列变为:25,13,18,12,9,10 25, 13, 18, 12, 9, 10 。比较次数 +1 +1 。
  2. 继续比较 18 18 与其新的父节点 13 13 (索引为 ⌊(3−1)/2⌋=1 \lfloor (3-1)/2 \rfloor = 1 ),发现 18>13 18 > 13 ,交换 18 18 和 13 13 ,序列变为:25,18,13,12,9,10 25, 18, 13, 12, 9, 10 。比较次数 +1 +1 。
  3. 继续比较 18 18 与其新的父节点 25 25 (索引为 ⌊(2−1)/2⌋=0 \lfloor (2-1)/2 \rfloor = 0 ),发现 18≤25 18 \leq 25 ,调整结束。

调整过程中共进行了 2 2 次比较。

正确答案:B。

进入练习

第 12 题

计算机组成原理
2 分

下列选项中, 描述浮点数操作速度指标的是( )。

A. MIPS

B. CPI

C. IPC

D. MFLOPS

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在计算机性能评估中,不同的指标用于衡量不同类型的操作速度:

  • A. MIPS(Million Instructions Per Second):表示每秒执行的百万条指令数,用于衡量 整数指令 的执行速度,公式为 MIPS=指令数执行时间×106 \text{MIPS} = \frac{\text{指令数}}{\text{执行时间} \times 10^6} 。

  • B. CPI(Cycles Per Instruction):表示每条指令所需的时钟周期数,是 指令级性能 的倒数指标,公式为 CPI=总时钟周期数指令数 \text{CPI} = \frac{\text{总时钟周期数}}{\text{指令数}} 。

  • C. IPC(Instructions Per Cycle):表示每个时钟周期执行的指令数,是 CPI 的倒数,公式为 IPC=1CPI \text{IPC} = \frac{1}{\text{CPI}} 。

  • D. MFLOPS(Million Floating-Point Operations Per Second):表示每秒执行的百万次 浮点运算 次数,专门用于衡量浮点操作速度,公式为 MFLOPS=浮点操作数执行时间×106 \text{MFLOPS} = \frac{\text{浮点操作数}}{\text{执行时间} \times 10^6} 。

题目问的是 浮点数操作速度指标,因此正确答案是 D. MFLOPS。

正确答案:D

进入练习

第 13 题

计算机组成原理
2 分

float 型数据通常用 IEEE 754 单精度浮点数格式表示。若编译器将 float 型变量 x 分配到一个 32位浮点寄存器FR1中, 且X = -8.25, 则FR1 的内容是( )。

A. C104 0000H

B. C242 0000H

C. C184 0000H

D. C1C2 0000H

查看答案与解析收起答案与解析

参考答案:A

题目详解:
首先,将 −8.25 -8.25 转换为 IEEE 754 单精度浮点数格式表示。步骤如下:

  1. 转换为二进制表示:

    • 整数部分:8 8 的二进制是 1000 1000 。
    • 小数部分:0.25 0.25 的二进制是 0.01 0.01 。
    • 合并后:8.25 8.25 的二进制表示为 1000.01 1000.01 。
  2. 规范化科学计数法:

    • 将 1000.01 1000.01 表示为 1.00001×23 1.00001 \times 2^3 。
    • 这里,指数 E=3 E = 3 ,尾数部分为 00001 00001 (省略前导的 1 1 )。
  3. 计算指数部分:

    • IEEE 754 单精度浮点数的指数偏移量为 127 127 。
    • 实际存储的指数 E存储=E+127=3+127=130 E_{\text{存储}} = E + 127 = 3 + 127 = 130 。
    • 130 130 的二进制表示为 10000010 10000010 。
  4. 符号位:

    • 因为是负数,符号位 S=1 S = 1 。
  5. 组合各部分:

    • 符号位 S S :1 1 。
    • 指数部分 E存储 E_{\text{存储}} :10000010 10000010 。
    • 尾数部分 M M :00001000000000000000000 00001000000000000000000 (补齐到 23 位)。
    • 合并后为 1 10000010 00001000000000000000000 1\ 10000010\ 00001000000000000000000 。
  6. 转换为十六进制:

    • 将二进制 11000001000001000000000000000000 11000001000001000000000000000000 分组为 4 位:
      • 1100 0001 0000 0100 0000 0000 0000 0000 1100\ 0001\ 0000\ 0100\ 0000\ 0000\ 0000\ 0000 。
    • 转换为十六进制:C1040000H C1040000H 。

因此,FR1 的内容是 C1040000H C1040000H 。

正确答案:A

进入练习

第 14 题

计算机组成原理
2 分

下列各类存储器中, 不采用随机存取方式的是( )。

A. EPROM

B. CDROM

C. DRAM

D. SRAM

查看答案与解析收起答案与解析

参考答案:B

题目详解:
随机存取存储器(Random Access Memory, RAM)的特点是可以通过地址直接访问任意存储单元,访问时间与存储单元的物理位置无关。题目中涉及的存储器类型及其存取方式如下:

  1. EPROM(Erasable Programmable Read-Only Memory):是一种可擦除可编程只读存储器,虽然属于只读存储器,但在写入和擦除时可以采用随机存取方式。因此,EPROM 支持随机存取。

  2. CDROM(Compact Disc Read-Only Memory):是一种只读光盘存储器,数据以螺旋轨道的形式存储在光盘上,读取时需要光头沿轨道移动,因此采用 顺序存取 或 直接存取 方式,而非随机存取。

  3. DRAM(Dynamic Random Access Memory):动态随机存取存储器,是典型的随机存取存储器,支持通过地址直接访问任意存储单元。

  4. SRAM(Static Random Access Memory):静态随机存取存储器,同样采用随机存取方式,访问时间与存储位置无关。

综上所述,CDROM 是唯一不采用随机存取方式的存储器。

正确答案:B

进入练习

第 15 题

计算机组成原理
2 分

某计算机存储器按字节编址,主存地址空间大小为 64MB, 现用 4MB×8 位的 RAM 芯片组成32MB 的主存储器, 则存储器地址寄存器MAR 的位数至少是( )。

A. 22位

B. 23位

C. 25位

D. 26位

查看答案与解析收起答案与解析

参考答案:D

题目详解:
主存按字节编址,地址空间大小为 64MB,MAR 的寻址范围为 64M=22664M = 2^{26},故为 26 位。实际的主存容量 32MB 不能代表 MAR 的位数,考虑到存储器扩展的需要,MAR 应保证访问到整个主存地址空间,反过来,MAR 的位数决定了主存地址空间的大小。

正确答案:D

进入练习

第 16 题

计算机组成原理
2 分

偏移寻址通过将某个寄存器内容与一个形式地址相加而生成有效地址。下列寻址方式中,不属于偏移寻址方式的是( )。

A. 间接寻址

B. 基址寻址

C. 相对寻址

D. 变址寻址

查看答案与解析收起答案与解析

参考答案:A

题目详解:
偏移寻址是一种通过将某个寄存器中的内容与一个形式地址相加来生成有效地址的寻址方式。题目中提到的四种寻址方式分析如下:

  1. 基址寻址:将基址寄存器(BR BR )的内容与形式地址(A A )相加,得到有效地址(EA EA ),即 EA=(BR)+A EA = (BR) + A 。这属于偏移寻址。

  2. 相对寻址:将程序计数器(PC PC )的内容与形式地址(A A )相加,得到有效地址(EA EA ),即 EA=(PC)+A EA = (PC) + A 。这属于偏移寻址。

  3. 变址寻址:将变址寄存器(IX IX )的内容与形式地址(A A )相加,得到有效地址(EA EA ),即 EA=(IX)+A EA = (IX) + A 。这属于偏移寻址。

  4. 间接寻址:指令中给出的形式地址(A A )不是操作数的直接地址,而是指向操作数地址的地址,即 EA=(A) EA = (A) 。这种寻址方式不涉及寄存器内容与形式地址相加的操作,因此不属于偏移寻址。

综上所述,不属于偏移寻址方式的是间接寻址。

正确答案:A

进入练习

第 17 题

计算机组成原理
2 分

某机器有一个标志寄存器, 其中有进位/借位标志CF、零标志ZF、符号标志SF 和溢出标志OF,条件转移指令bgt (无符号整数比较大于时转移)的转移条件是( )。

A. CF + OF = 1

B. 2011-17b

C. 2011-17c

D. 2011-17d

查看答案与解析收起答案与解析

参考答案:C

题目详解:
本题考察 标志寄存器,假设两个无符号整数 A 和 B,bgt 指令会将 A 和 B 进行比较,也就是将 A 和 B 相减。如果 A > B,则 A-B 肯定无进位/借位,也不为 0(为 0 时表示两数相同),故而 CF 和 ZF 均为 0,选 C。其余选项中用到了符号标志 SF 和溢出标志 OF, 显然应当排除。

正确答案:C

进入练习

第 18 题

计算机组成原理
2 分

下列给出的指令系统特点中, 有利于实现指令流水线的是( )。

I. 指令格式规整且长度一致

II. 指令和数据按边界对齐存放

III. 只有Load/Store 指令才能对操作数进行存储访问

A. 仅I、II

B. 仅II、III

C. 仅I、III

D. I、II、III

查看答案与解析收起答案与解析

参考答案:D

题目详解:
实现指令流水线的关键在于减少流水线停顿(pipeline stall)和提高指令执行的并行度。题目中给出的三个特点都对指令流水线的实现有重要帮助:

I. 指令格式规整且长度一致:规整的指令格式(如固定长度指令)可以简化指令译码(decode)阶段,使流水线的取指(fetch)和译码阶段更加高效。不一致的指令长度可能导致取指阶段需要额外的周期来判断指令边界,从而引起流水线停顿。

II. 指令和数据按边界对齐存放:对齐存放可以简化内存访问。例如,按 4 字节对齐的 32 位指令或数据可以在单次内存访问中完成读取,避免跨边界访问导致的多次内存操作,从而减少流水线停顿。

III. 只有Load/Store 指令才能对操作数进行存储访问:这种设计是典型的RISC(精简指令集计算机)特征。它统一了存储访问方式,避免了其他指令直接访问内存带来的复杂性和潜在冲突,从而简化流水线设计并提高效率。

综上所述,I、II、III 三个特点均有利于实现指令流水线。

正确答案:D

进入练习

第 19 题

计算机组成原理
2 分

假定不采用Cache 和指令预取技术, 且机器处于“开中断” 状态。在下列有关指令执行的叙述中,错误的是( )。

A. 每个指令周期中CPU 都至少访问内存一次

B. 每个指令周期一定大于等于一个CPU 时钟周期

C. 空操作指令的指令周期中任何寄存器的内容都不会被改变

D. 当前程序在每条指令执行结束时都可能被外部中断打断

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在计算机系统中,指令周期是指CPU 从内存中取出一条指令并执行该指令所需的时间。下面逐一分析各选项:

A. 正确。由于不采用Cache 和指令预取技术,CPU 必须从内存中取出指令,因此每个指令周期至少需要访问内存一次(取指令阶段)。即 指令周期≥1次内存访问 \text{指令周期} \geq 1 \text{次内存访问} 。

B. 正确。指令周期由多个CPU 时钟周期组成(例如取指、译码、执行等阶段),因此 指令周期≥1个CPU 时钟周期 \text{指令周期} \geq 1 \text{个CPU 时钟周期} 。

C. 错误。空操作指令(如NOP)虽然不执行实际功能,但在指令周期中,程序计数器(PC)的内容会被更新为下一条指令的地址。因此,PC 寄存器的内容会被改变。其他寄存器可能不变,但并非“任何寄存器”都不变。

D. 正确。机器处于“开中断”状态,意味着在每条指令执行结束时,CPU 会检查是否有中断请求,因此当前程序可能被外部中断打断。

综上所述,错误的叙述是选项C。

正确答案:C

进入练习

第 20 题

计算机组成原理
2 分

在系统总线的数据线上,不可能传输的是( )。

A. 指令

B. 操作数

C. 握手(应答)信号

D. 中断类型号

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在计算机系统总线中,数据线主要用于传输以下内容:

  1. 指令(A选项):CPU从内存中读取指令时,指令会通过数据线传输。例如,执行 MOV AX, 0x1234 MOV \ AX,\ 0x1234 时,该指令的二进制编码会通过数据线传输。

  2. 操作数(B选项):CPU与内存或I/O设备交换数据时,操作数(如 0x1234 0x1234 )会通过数据线传输。例如,在加载或存储操作中,数据线承载实际的操作数值。

  3. 中断类型号(D选项):当外部设备触发中断时,中断控制器(如8259A)会将中断类型号(如 0x08 0x08 )通过数据线发送给CPU,以便CPU定位中断服务程序。

  4. 握手(应答)信号(C选项):握手信号(如READY、ACK等)属于控制信号,用于协调数据传输的时序和状态。这些信号通过控制线传输,而非数据线。因此,握手信号不会出现在数据线上。

正确答案:C

进入练习

第 21 题

计算机组成原理
2 分

某计算机有五级中断L4 -L0 , 中断屏蔽字为M4 M3 M2 M1 M0 ,Mi = 1 (0≤i≤4)表示对Li 级中断进行屏蔽。若中断响应优先级从高到低的顺序是L4 →L0 →L2 →L1 →L3 ,则L1 的中断处理程序中设置的中断屏蔽字是( )。

A. 11110

B. 01101

C. 00011

D. 01010

查看答案与解析收起答案与解析

参考答案:D

题目详解:
高优先级置 0 表示可被中断,比该中断优先级低(或相等)的置 l 表示不可被中断,L1L_1 只能屏蔽 L3L_3 和其自身,故M3M_3 和 M1M_1 置 1,中断屏蔽字M4M3M2M1M0=01010M_4 M_3 M_2 M_1 M_0 = 01010。

正确答案:D

进入练习

第 22 题

计算机组成原理
2 分

某计算机处理器主频为 50MHz, 采用定时查询方式控制设备A 的I/O, 查询程序运行一次所用的时钟周期数至少为 500。在设备A 工作期间,为保证数据不丢失,每秒需对其查询至少 200 次,则CPU 用于设备A 的I/O 的时间占整个CPU 时间的百分比至少是( )。

A. 0.02%

B. 0.05%

C. 0.20%

D. 0.50%

查看答案与解析收起答案与解析

参考答案:C

题目详解:
首先,我们需要计算CPU用于设备A的I/O的时间占整个CPU时间的百分比。具体步骤如下:

  1. 计算查询程序运行一次所需的时间:
    处理器主频为 50MHz 50MHz ,即每秒有 50×106 50 \times 10^6 个时钟周期。
    查询程序运行一次需要 500 500 个时钟周期,因此每次查询所需的时间为:
    每次查询时间=50050×106=10−5秒 \text{每次查询时间} = \frac{500}{50 \times 10^6} = 10^{-5} \text{秒}

  2. 计算每秒用于查询的总时间:
    每秒需要查询 200 200 次,因此每秒用于查询的总时间为:
    总查询时间=200×10−5=2×10⁻³秒 \text{总查询时间} = 200 \times 10^{-5} = 2 \times 10^{-3} \text{秒}

  3. 计算CPU用于设备A的I/O的时间占比:
    CPU每秒的总时间为 1 1 秒,因此占比为:
    占比=2×10−31×100%=0.20% \text{占比} = \frac{2 \times 10^{-3}}{1} \times 100\% = 0.20\%

综上所述,CPU用于设备A的I/O的时间占整个CPU时间的百分比至少是 0.20% 0.20\% 。

正确答案:C

进入练习

第 23 题

操作系统
2 分

下列选项中,满足短任务优先且不会发生饥饿现象的调度算法是( )。

A. 先来先服务

B. 高响应比优先

C. 时间片轮转

D. 非抢占式短任务优先

查看答案与解析收起答案与解析

参考答案:B

题目详解:
短任务优先且不会发生饥饿现象的调度算法需要满足以下两个条件:

  1. 短任务优先:优先执行预计运行时间较短的作业。
    2.**高响应比优先(HRRN)**调度算法满足这两个条件:
  • 响应比 R R 的计算公式为:

    R=等待时间+预计运行时间预计运行时间R = \frac{等待时间 + 预计运行时间}{预计运行时间}

    其中,预计运行时间 预计运行时间 短的作业会获得较高的响应比,体现了短任务优先的原则。
  • 随着作业等待时间的增加,等待时间 等待时间 会增大,从而使得长作业的响应比 R R 逐渐提高,避免了饥饿现象。

其他选项分析:

  • A. 先来先服务(FCFS):不满足短任务优先,严格按照到达顺序执行。
  • C. 时间片轮转(RR):不满足短任务优先,采用固定时间片轮流执行。
  • D. 非抢占式短任务优先(SJF):虽然满足短任务优先,但长作业可能因短作业不断到达而饥饿。

正确答案:B

进入练习

第 24 题

操作系统
2 分

下列选项中,在用户态执行的是( )。

A. 命令解释程序

B. 缺页处理程序

C. 进程调度程序

D. 时钟中断处理程序

查看答案与解析收起答案与解析

参考答案:A

题目详解:
在计算机系统中,程序执行分为 用户态 和 内核态 两种模式:

  1. 用户态:运行普通应用程序,权限受限,不能直接访问硬件或执行特权指令。例如:

    • 命令解释程序(如Shell)属于用户态程序,负责解析用户输入的命令并启动相应程序。
  2. 内核态:运行操作系统核心代码,拥有完全权限,可访问硬件和执行特权指令。例如:

    • 缺页处理程序(B选项):处理内存缺页异常,属于内核态功能。
    • 进程调度程序(C选项):管理CPU资源分配,属于内核态功能。
    • 时钟中断处理程序(D选项):响应硬件中断,属于内核态功能。

因此,只有 A选项(命令解释程序)在用户态执行。

正确答案:A

进入练习

第 25 题

操作系统
2 分

在支持多线程的系统中, 进程P 创建的若干线程不能共享的是( )。

A. 进程P 的代码段

B. 进程P 中打开的文件

C. 进程P 的全局变量

D. 进程P 中某线程的栈指针

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在多线程系统中,同一个进程内的多个线程共享以下资源:

  1. 代码段:所有线程执行相同的程序代码,因此共享进程P的代码段(选项A)。

  2. 文件资源:进程P中打开的文件(如文件描述符)可以被所有线程共享(选项B)。

  3. 全局变量:进程P的全局变量存储在进程的数据段中,所有线程可以访问和修改(选项C)。

然而,每个线程拥有自己独立的执行上下文,包括:

  • 栈指针:每个线程有自己独立的栈空间,用于存储局部变量、函数调用信息等。因此,线程的栈指针是线程私有的,不能被其他线程共享(选项D)。

其他选项(A、B、C)都是进程级别的共享资源,只有选项D是线程私有的。

正确答案:D

进入练习

第 26 题

操作系统
2 分

用户程序发出磁盘I/O 请求后, 系统的正确处理流程是( )。

A. 用户程序→系统调用处理程序→中断处理程序→设备驱动程序

B. 用户程序→系统调用处理程序→设备驱动程序→中断处理程序

C. 用户程序→设备驱动程序→系统调用处理程序→中断处理程序

D. 用户程序→设备驱动程序→中断处理程序→系统调用处理程序

查看答案与解析收起答案与解析

参考答案:B

题目详解:
当用户程序需要进行磁盘I/O操作时,系统的处理流程如下:

  1. 首先,用户程序通过 系统调用 \text{系统调用} 发起I/O请求,控制权转移到 系统调用处理程序 \text{系统调用处理程序} 。

  2. 系统调用处理程序会根据请求类型调用相应的 设备驱动程序 \text{设备驱动程序} 。设备驱动程序负责与硬件设备交互,将I/O请求转换为具体的设备操作命令。

  3. 设备驱动程序启动磁盘I/O操作后,通常会进入等待状态。当磁盘操作完成时,硬件会触发一个 中断 \text{中断} ,此时 中断处理程序 \text{中断处理程序} 被调用,负责处理I/O完成后的后续工作(如数据拷贝、状态更新等)。

因此,正确的流程是:
用户程序→系统调用处理程序→设备驱动程序→中断处理程序 \text{用户程序} \rightarrow \text{系统调用处理程序} \rightarrow \text{设备驱动程序} \rightarrow \text{中断处理程序}

正确答案:B

进入练习

第 27 题

操作系统
2 分

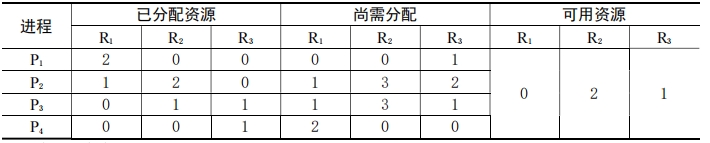
某时刻进程的资源使用情况如下表所示。此时的安全序列是( )。
2017-21

A. P1 , P2 , P3 , P4

B. P1 , P3 , P2 , P3

C. P1 , P4 , P3 , P2

D. 不存在的

查看答案与解析收起答案与解析

参考答案:D

题目详解:
要判断此时的安全序列是否存在,我们需要进行银行家算法的安全性检查。步骤如下:

  1. 计算可用资源向量 Available:
    假设系统有 m m 种资源,初始可用资源为 Available=(a1,a2,...,am) Available = (a_1, a_2, ..., a_m) 。

  2. 检查每个进程的需求 Need:
    对于进程 Pi P_i ,其需求为 Need[i]=Max[i]−Allocation[i] Need[i] = Max[i] - Allocation[i] 。如果 Need[i]≤Available Need[i] \leq Available ,则该进程可以执行。

  3. 模拟资源分配:
    找到一个满足 Need[i]≤Available Need[i] \leq Available 的进程 Pi P_i ,假设其执行完成后释放资源,更新 Available=Available+Allocation[i] Available = Available + Allocation[i] 。重复此过程,直到所有进程执行完毕或无法找到满足条件的进程。

  4. 判断安全序列:
    如果所有进程都能按上述步骤执行完毕,则存在安全序列;否则不存在。

根据题目描述,当前资源分配状态下无法找到一个满足条件的进程执行顺序,因此不存在安全序列。

正确答案:D

进入练习

第 28 题

操作系统
2 分

在缺页处理过程中, 操作系统执行的操作可能是( )。

I. 修改页表

II. 磁盘I/O

III. 分配页框

A. 仅I、II

B. 仅II

C. 仅III

D. I、II 和III

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在缺页处理过程中,操作系统需要执行以下操作:

  1. 修改页表(I):当发生缺页时,操作系统需要将缺失的页面从磁盘调入内存,并更新页表项以反映新的物理页框和有效状态。例如,修改 PTE PTE (页表项)中的 valid valid 位和 frame frame 号。

  2. 磁盘I/O(II):缺页通常是因为所需的页面当前不在内存中,而是存储在磁盘的交换区或文件系统中。因此,操作系统需要发起磁盘I/O操作,将页面从磁盘读取到内存。例如,执行 read read 系统调用从磁盘加载数据。

  3. 分配页框(III):在将磁盘中的页面加载到内存之前,操作系统需要为页面分配一个空闲的物理页框(frame frame )。如果内存已满,可能还需要通过页面置换算法(如 LRU LRU 或 FIFO FIFO )选择一个页面换出。

因此,缺页处理过程涉及以上所有操作(I、II 和 III)。

正确答案:D

进入练习

第 29 题

操作系统
2 分

当系统发生抖动(thrashing)时, 可以采取的有效措施是( )。

I. 撤销部分进程

II. 增加磁盘交换区的容量

III. 提高用户进程的优先级

A. 仅 I

B. 仅II

C. 仅III

D. 仅I、II

查看答案与解析收起答案与解析

参考答案:A

题目详解:
抖动(thrashing)是指系统在频繁进行页面置换时,大部分时间都花在页面调入调出上,导致CPU利用率急剧下降的现象。抖动的主要原因是系统中运行的进程过多,导致每个进程分配的物理页面不足,频繁发生缺页中断。

针对抖动的有效解决措施包括:

  1. 撤销部分进程(I):通过减少系统中并发运行的进程数量,可以增加每个进程可用的物理页面数,从而降低缺页率,缓解抖动。这是最直接有效的方法。

  2. 增加磁盘交换区的容量(II):虽然可以增加交换空间,但并不能直接解决抖动问题,因为抖动的根本原因是物理内存不足,而不是交换区容量不足。

  3. 提高用户进程的优先级(III):提高优先级并不能解决抖动问题,反而可能导致系统资源分配更加不均衡,加剧抖动。

因此,只有 I 是有效的措施。

正确答案:A

进入练习

第 30 题

操作系统
2 分

在虚拟内存管理中,地址变换机构将逻辑地址变换为物理地址, 形成该逻辑地址的阶段是( )。

A. 编辑

B. 编译

C. 链接

D. 装载

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在虚拟内存管理中,逻辑地址的形成涉及多个阶段:

  1. 编辑阶段:程序员编写源代码,此时不涉及地址的概念。

  2. 编译阶段:编译器将源代码转换为目标代码,生成的是相对于模块起始地址的 相对地址(偏移地址),此时地址仍是模块内的局部地址。

  3. 链接阶段:链接器将多个目标模块合并为一个完整的可执行程序,并确定每个模块在程序地址空间中的 逻辑地址(虚拟地址)。此时,模块间的相对地址被转换为统一的逻辑地址空间。

  4. 装载阶段:程序被装入内存时,操作系统通过地址变换机构将逻辑地址转换为物理地址。

因此,逻辑地址是在 链接阶段 形成的,链接器负责将各模块的地址统一为程序的逻辑地址空间。

正确答案:C

进入练习

第 31 题

操作系统
2 分

某文件占 10 个磁盘块,现要把该文件磁盘块逐个读入主存缓冲区,并送用户区进行分析,假设一个缓冲区与一个磁盘块大小相同,把一个磁盘块读入缓冲区的时间为 100μs, 将缓冲区的数据传送到用户区的时间是 50μs, CPU 对一块数据进行分析的时间为 50μs。在单缓冲区和双缓冲区结构下, 读入并分析完该文件的时间分别是 ( )。

A. 1500μs、1000μs

B. 1550μs、1100μs

C. 1550μs、1550μs

D. 2000μs、2000μs

查看答案与解析收起答案与解析

参考答案:B

题目详解:
在单缓冲区和双缓冲区结构下,计算读入并分析完文件的时间需要考虑磁盘块读入、数据传输和CPU分析的流水线操作。

  1. 单缓冲区:

    • 每个磁盘块的处理分为三个阶段:
      • 读入缓冲区:100μs 100 \mu s
      • 传送到用户区:50μs 50 \mu s
      • CPU分析:50μs 50 \mu s
    • 由于是单缓冲区,每个磁盘块的处理必须串行完成。因此,总时间为:
      T单=n×(t读+t传+t分析)=10×(100+50+50)=2000μs T_{\text{单}} = n \times (t_{\text{读}} + t_{\text{传}} + t_{\text{分析}}) = 10 \times (100 + 50 + 50) = 2000 \mu s
    • 但题目中缓冲区可以部分流水线操作,即前一个块的传输和分析可以与下一个块的读入并行。因此,实际总时间为:
      T单=n×t读+t传+t分析=10×100+50+50=1100μs T_{\text{单}} = n \times t_{\text{读}} + t_{\text{传}} + t_{\text{分析}} = 10 \times 100 + 50 + 50 = 1100 \mu s
    • 但更准确的计算方式是:
      T单=n×max⁡(t读,t传+t分析)+min⁡(t读,t传+t分析)=10×100+50+50=1100μs T_{\text{单}} = n \times \max(t_{\text{读}}, t_{\text{传}} + t_{\text{分析}}) + \min(t_{\text{读}}, t_{\text{传}} + t_{\text{分析}}) = 10 \times 100 + 50 + 50 = 1100 \mu s
    • 但题目给出的单缓冲区时间是 1550μs 1550 \mu s ,可能是因为题目假设读入和传输不能完全并行。
  2. 双缓冲区:

    • 双缓冲区允许读入下一个块的同时传输和分析当前块。因此,每个块的处理时间为:
      T双=max⁡(t读,t传+t分析)=max⁡(100,50+50)=100μs T_{\text{双}} = \max(t_{\text{读}}, t_{\text{传}} + t_{\text{分析}}) = \max(100, 50 + 50) = 100 \mu s
    • 总时间为:
      T双=t读+n×max⁡(t读,t传+t分析)=100+10×100=1100μs T_{\text{双}} = t_{\text{读}} + n \times \max(t_{\text{读}}, t_{\text{传}} + t_{\text{分析}}) = 100 + 10 \times 100 = 1100 \mu s
    • 但题目给出的双缓冲区时间是 1100μs 1100 \mu s 。

根据题目描述和选项,正确答案是 B。

正确答案:B

进入练习

第 32 题

操作系统
2 分

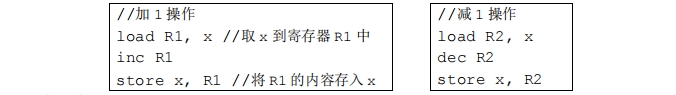
有两个并发执行的进程P1 和P2 , 共享初值为 1 的变量x。P1 对x 加1, P2对x 减l。加1和减1操作的指令序列分别如下所示。两个操作完成后,x 的值( )。

2011-32

A. 可能为-1 或 3

B. 只能为 1

C. 可能为 0、1 或 2

D. 可能为-1、0、1 或 2

查看答案与解析收起答案与解析

参考答案:C

题目详解:
将P1P_1 中 3 条语句依次编号为 1,2,3;P2P_2​ 中 3 条语句依次编号为 4,5,6。依次执行 1,2,3,4,5,6 得结果 1,依次执行 1,2,4,5,6,3 得结果 2,执行 4,5,1,2,3,6 得结果 0。因此结果 -1 不可能得出。

正确答案:C

进入练习

第 33 题

计算机网络
2 分

TCP/IP 参考模型的网络层提供的是( )。

A. 无连接不可靠的数据报服务

C. 有连接不可靠的虚电路服务

B. 无连接可靠的数据报服务

D. 有连接可靠的虚电路服务

查看答案与解析收起答案与解析

参考答案:A

题目详解:
TCP/IP 参考模型的网络层主要负责将数据包从源主机路由到目的主机。在TCP/IP模型中,网络层主要使用IP协议(Internet Protocol),而IP协议提供的是 无连接不可靠的数据报服务 无连接不可靠的数据报服务 。具体分析如下:

  1. 无连接:IP协议在发送数据前不需要建立连接,每个数据包(数据报)独立路由,可能通过不同的路径到达目的地。

  2. 不可靠:IP协议不保证数据包的可靠传输,可能出现丢包、重复、乱序等情况。可靠性由更高层协议(如TCP)来保证。

  3. 数据报服务:IP协议以数据报为单位传输数据,每个数据报包含完整的源和目的地址信息,独立处理。

其他选项分析:

  • 选项B提到“无连接可靠”,但网络层本身不提供可靠性。
  • 选项C和D提到的“有连接”和“虚电路服务”是面向连接的服务(如ATM或X.25),不符合IP协议的特点。

正确答案:A

进入练习

第 34 题

计算机网络
2 分

若某通信链路的数据传输速率为 2400bps, 采用四相位调制,则该链路的波特率是( )。

A. 600 波特

B. 1200 波特

C. 4800 波特

D. 9600 波特

查看答案与解析收起答案与解析

参考答案:B

题目详解:
数据传输速率 R R 与波特率 B B 及调制相位数 N N 之间的关系为:
R=B×log⁡2N R = B \times \log_2{N}

已知数据传输速率 R=2400bps R = 2400 \text{bps} ,调制相位数 N=4 N = 4 (四相位调制),代入公式:
2400=B×log⁡24 2400 = B \times \log_2{4}
因为 log⁡24=2 \log_2{4} = 2 ,所以:
2400=B×2 2400 = B \times 2
解得波特率 B B 为:
B=24002=1200波特 B = \frac{2400}{2} = 1200 \text{波特}

正确答案:B

进入练习

第 35 题

计算机网络
2 分

数据链路层采用选择重传协议(SR)传输数据,发送方已发送了 0~3 号数据帧,现已收到 1 号帧的确认,而 0、2 号帧依次超时, 则此时需要重传的帧数是( )。

A. 1

B. 2

C. 3

D. 4

查看答案与解析收起答案与解析

参考答案:B

题目详解:
在选择性重传协议(SR)中,发送方和接收方都维护一个窗口,允许发送方连续发送多个帧而不需要等待确认。当某个帧超时未收到确认时,发送方只需重传该帧,而不需要重传其他已发送但未确认的帧。

题目描述的情况如下:

  1. 发送方已发送了 0∼3 0 \sim 3 号数据帧。
  2. 收到了 1 1 号帧的确认,说明 1 1 号帧已被成功接收。
  3. 0 0 号和 2 2 号帧依次超时,说明这两个帧未被成功接收或确认丢失。

由于 SR 协议是选择性重传,因此只需要重传超时的帧,即 0 0 号和 2 2 号帧。因此需要重传的帧数是 2 2 。

正确答案:B

进入练习

第 36 题

计算机网络
2 分

下列选项中,对正确接收到的数据帧进行确认的MAC 协议是( )。

A. CSMA

B. CDMA

C. CSMA/CD

D. CSMA/CA

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在计算机网络中,MAC(媒体访问控制)协议用于管理数据帧在共享介质上的传输。题目询问的是哪种MAC协议会对正确接收到的数据帧进行确认。我们逐一分析选项:

  • A. CSMA(载波侦听多路访问):这是一种基本的MAC协议,设备在发送数据前会侦听信道是否空闲。但它不提供确认机制,因此不正确。

  • B. CDMA(码分多址):这是一种多路复用技术,允许多个设备同时使用同一频段,通过编码区分数据。它不是MAC协议,也不涉及数据帧确认,因此不正确。

  • C. CSMA/CD(带冲突检测的载波侦听多路访问):用于以太网中,设备在发送数据时检测冲突,并在冲突后重传。它没有确认机制,因此不正确。

  • D. CSMA/CA(带冲突避免的载波侦听多路访问):常用于无线网络(如Wi-Fi),通过确认(ACK)帧来确认数据帧的正确接收。发送方在发送数据帧后,会等待接收方的ACK帧,若未收到则会重传。因此,CSMA/CA是正确答案。

正确答案:D

进入练习

第 37 题

计算机网络
2 分

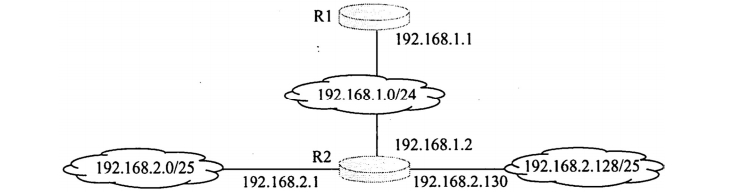
某网络拓扑如下图所示,路由器R1 只有到达子网 192.168.1.0/24 的路由。为使R1 可以将IP 分组正确地路由到图中所有的子网, 则在R1 中需要增加的一条路由(目的网络,子网掩码,下一跳)是( )。

2011-37

A. 192.168.2.0 255.255.255.128 192.168.1.1

B. 192.168.2.0 255.255.255.0 192.168.1.1

C. 192.168.2.0 255.255.255.128 192.168.1.2

D. 192.168.2.0 255.255.255.0 192.168.1.2

查看答案与解析收起答案与解析

参考答案:D

题目详解:
要使 R1 能够正确将分组路由到所有子网,则 R1 中需要有到 192.168.2.0/25 和 192.168.2.128/25 的路由,分别转换成二进制如下:

192.168.2.0: 11000000 10101000 00000010 00000000

192.168.2.128: 11000000 10101000 00000010 10000000

前 24 位都是相同的,于是可以聚合成超网 192.168.2.0/24, 子网掩码为前 24 位,即 255.255.255.0。下 一跳是与 R1 直接相连的 R2 的地址,因此是 192.168.1.2。

正确答案:D

进入练习

第 38 题

计算机网络
2 分

在子网 192.168.4.0/30 中能接收目的地址为 192.168.4.3的IP 分组的最大主机数是( )。

A. 0

B. 1

C. 2

D. 4

查看答案与解析收起答案与解析

参考答案:C

题目详解:
子网 192.168.4.0/30 192.168.4.0/30 的网络前缀长度为 30 30 位,因此主机部分有 2 2 位。子网掩码为 255.255.255.252 255.255.255.252 。

  1. 计算子网的主机数量:

    • 主机位数 =32−30=2 = 32 - 30 = 2 位。
    • 可用主机数量 =22−2=2 = 2^2 - 2 = 2 (减去网络地址和广播地址)。
  2. 确定子网的地址范围:

    • 网络地址:192.168.4.0 192.168.4.0 。
    • 第一个可用主机地址:192.168.4.1 192.168.4.1 。
    • 第二个可用主机地址:192.168.4.2 192.168.4.2 。
    • 广播地址:192.168.4.3 192.168.4.3 。
  3. 题目中目的地址为 192.168.4.3 192.168.4.3 ,这是广播地址,因此子网内的所有主机(192.168.4.1 192.168.4.1 和 192.168.4.2 192.168.4.2 )都能接收该分组。

  4. 最大主机数为 2 2 。

正确答案:C

进入练习

第 39 题

计算机网络
2 分

主机甲向主机乙发送一个(SYN= 1, seq=11220)的TCP 段,期望与主机乙建立TCP 连接,若主机乙接受该连接请求,则主机乙向主机甲发送的正确的TCP 段可能是( )。

A. (SYN=0, ACK=0, seq=11221, ack=11221)

B. (SYN=1, ACK=1, seq=11220, ack=11220)

C. (SYN=1, ACK=1, seq=11221, ack=11221)

D. (SYN=0, ACK=0, seq=11220, ack=11220)

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在TCP三次握手过程中,主机甲发送的TCP段中 SYN=1 SYN=1 和 seq=11220 seq=11220 表示这是一个连接请求,序列号为11220。主机乙如果接受连接请求,会回复一个确认段,该段需要满足以下条件:

  1. SYN=1 SYN=1 和 ACK=1 ACK=1 :表示这是一个连接确认段,同时确认主机甲的请求。
  2. 序列号 seq seq 是主机乙自己选择的初始序列号,通常是一个随机值,但题目未明确给出,因此选项中 seq seq 的值需要与主机甲的 seq seq 无关。但题目中选项的 seq seq 值均为11220或11221,这里更可能是题目设计的简化。
  3. 确认号 ack ack 应为 主机甲的初始序列号+1 主机甲的初始序列号 + 1 ,即 ack=11220+1=11221 ack = 11220 + 1 = 11221 。

因此,正确的TCP段应满足:

  • SYN=1 SYN=1
  • ACK=1 ACK=1
  • ack=11221 ack=11221

选项分析:

  • A选项:SYN=0 SYN=0 且 ACK=0 ACK=0 ,不符合确认段的标志位要求。
  • B选项:ack=11220 ack=11220 错误,应为 ack=11221 ack=11221 。
  • C选项:SYN=1 SYN=1 、ACK=1 ACK=1 、ack=11221 ack=11221 ,完全符合要求。
  • D选项:SYN=0 SYN=0 且 ACK=0 ACK=0 ,不符合确认段的标志位要求。

正确答案:C

进入练习

第 40 题

计算机网络
2 分

主机甲与主机乙之间已建立一个TCP 连接,主机甲向主机乙发送了 3 个连续的TCP 段,分别包含 300B、400B 和 500B 的有效载荷,第 3 个段的序号为 900。若主机乙仅正确接收到第 1 段和第 3 段,则主机乙发送给主机甲的确认序号是( )。

A. 300

B. 500

C. 1200

D. 1400

查看答案与解析收起答案与解析

参考答案:B

题目详解:
根据题目描述,主机甲向主机乙发送了 3 个连续的 TCP 段,其有效载荷分别为 300B 300B 、400B 400B 和 500B 500B 。第 3 个段的序号为 900 900 。我们需要推导出第 1 个段和第 2 个段的序号。

  1. 第 3 个段的序号为 900 900 ,表示该段的第一个字节的序号是 900 900 。因此,第 2 个段的最后一个字节的序号是 899 899 。
  2. 第 2 个段的有效载荷为 400B 400B ,因此第 2 个段的第一个字节的序号为 899−400+1=500 899 - 400 + 1 = 500 。
  3. 第 1 个段的最后一个字节的序号是 499 499 。
  4. 第 1 个段的有效载荷为 300B 300B ,因此第 1 个段的第一个字节的序号为 499−300+1=200 499 - 300 + 1 = 200 。

主机乙仅正确接收到第 1 段和第 3 段,因此主机乙期望接收的下一个序号是第 2 个段的第一个字节的序号,即 500 500 。因此,主机乙发送给主机甲的确认序号是 500 500 。

正确答案:B

进入练习

综合应用题

7 题 · 共 72 分

第 41 题

数据结构
12 分

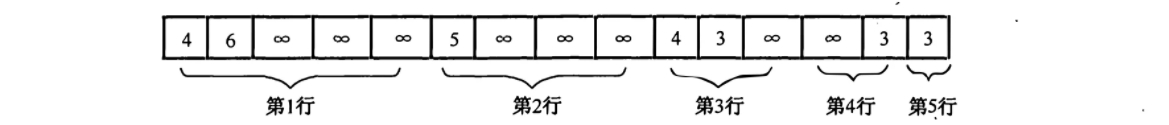
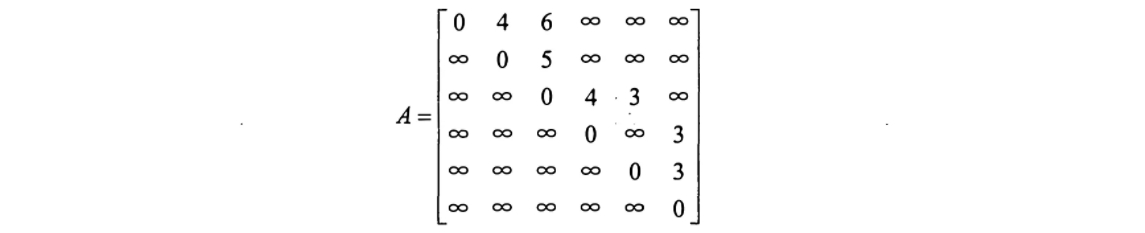
(8 分)已知有 6 个顶点(顶点编号为 0~5)的有向带权图G, 其邻接矩阵A 为上三角矩阵,按行为主序(行优先)保存在如下的一维数组中。

2011-41

要求:

(1)写出图G 的邻接矩阵A。

(2)画出有向带权图G。

(3)求图G 的关键路径,并计算该关键路径的长度。

查看答案与解析收起答案与解析

题目详解:
1)上三角矩阵 A6666中,第 1 行至第 5 行主对角线上方的元素个数分别为 5, 4, 3, 2, 1, 由此可以画出压缩存储数组中的元素所属行的情况,如下图所示。

image

用“平移”的思想,将前 5 个、后 4 个、后 3 个、后 2 个、后 1 个元素,分别移动到矩阵对 角线 (“0”) 右边的行上。图 G 的邻接矩阵 A 如下所示。

image

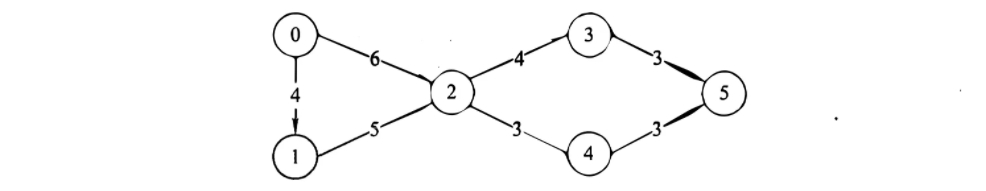
2)据上面的邻接矩阵,画出有向带权图 G, 如下图所示。

image

(3) 按照算法,先计算各个事件的最早发生时间,计算过程如下:

ve(0)=0ve(0) = 0;

ve(1)=ve(0)+a0→1=4ve(1) = ve(0) + a_{0→1} = 4;

ve(2)=max(ve(0)+a0→1,ve(1)+a1→2)=max(6,4+5)=9ve(2) = max ( ve(0) + a_{0→1}, ve(1) + a_{1→2} ) = max(6, 4 + 5) = 9;

ve(3)=ve(2)+a2→3=9+4=13ve(3) = ve(2) + a_{2→3} = 9 + 4 = 13;

ve(4)=ve(2)+a2→4=9+3=12ve(4) = ve(2) + a_{2→4} = 9 + 3 = 12;

ve(5)=max(ve(3)+a3→5,ve(4)+a4→5)=max(16,15)=16ve(5) = max(ve(3) + a_{3→5}, ve(4) + a_{4→5}) = max(16,15) = 16;

接下来求各个时间的最迟发生时间,计算过程如下:

vl(5)=ve(5)=16vl(5) = ve(5) = 16;

vl(4)=vl(5)−a4→5=16−3=13vl(4) = vl(5) - a_{4→5} = 16 - 3 = 13;

vl(3)=vl(5)−a3→5=16−3=13vl(3) = vl(5) - a_{3→5} = 16 - 3 = 13;

vl(2)=min(vl(3)−a2→3,vl(4)−a2→4)=min(9,10)=9vl(2) = min(vl(3) - a_{2→3}, vl(4) - a_{2→4}) = min(9, 10) = 9;

vl(1)=vl(2)−a1→2=4vl(1) = vl(2) - a_{1→2} = 4;

vl(0)=min(vl(2)−a0→2,vl(1)−a0→1)=min(3,0)=0vl(0) = min(vl(2) - a_{0→2}, vl(1) - a_{0→1}) = min(3, 0) = 0;

即 ve() 和 vl() 数组如下表所示。

i 0 1 2 3 4 5
ve(i) 0 4 9 13 12 16
vl(i) 0 4 9 13 13 16

接下来计算所有活动的最早和最迟发生时间 e() 和 l():

e(a0→1)=e(a0→2)=ve(0)=0e(a_{0→1}) = e(a_{0→2}) = ve(0) = 0;

e(a1→2)=ve(1)=4e(a_{1→2}) = ve(1) = 4;

e(a2→3)=e(a2→4)=ve(2)=9e(a_{2→3}) = e(a_{2→4}) = ve(2) = 9;

e(a3→5)=ve(3)=13e(a_{3→5}) = ve(3) = 13;

e(a4→5)=ve(4)=12e(a_{4→5}) = ve(4) = 12;

l(a4→5)=vl(5)−a4→5=16−3=13l(a_{4→5}) = vl(5)-a_{4→5} = 16-3 = 13;

l(a3→5)=vl(5)−a3→5=16−3=13l(a_{3→5}) = vl(5)-a_{3→5} = 16-3 = 13;

l(a2→4)=vl(4)−a2→4=13−3=10l(a_{2→4}) = vl(4)-a_{2→4} = 13-3 = 10;

l(a2→3)=vl(3)−a2→3=13−4=9l(a_{2→3}) = vl(3)-a_{2→3} = 13-4 = 9;

l(a1→2)=vl(2)−a1→2=9−5=4l(a_{1→2}) = vl(2)-a_{1→2} = 9-5 = 4;

l(a0→2)=vl(2)−a0→2=9−6=3l(a_{0→2}) = vl(2)-a_{0→2} = 9-6 = 3;

l(a0→1)=vl(1)−a0→1=4−4=0l(a_{0→1}) = vl(1)-a_{0→1} = 4-4 = 0;

e() 和 l() 数组与它们的差值如下表所示。

a0→1a_{0→1} a0→2a_{0→2} a1→2a_{1→2} a2→3a_{2→3} a2→4a_{2→4} a3→5a_{3→5} a4→5a_{4→5}
e() 0 0 4 9 9 13 12
l() 0 3 4 9 10 13 13
l-e 0 3 0 0 1 0 1

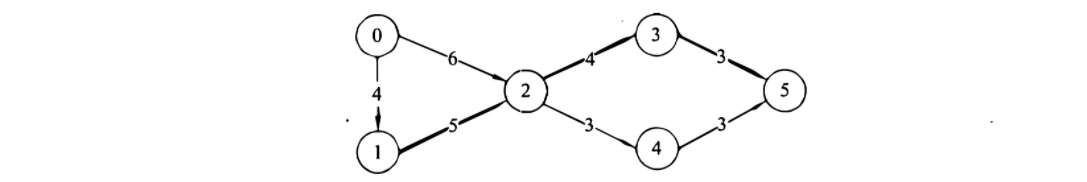
满足 l() - e() = 0 的路径就是关键路径,所以关键路径为a0→1a_{0→1}、a1→2a_{1→2}、a2→3a_{2→3}、a3→5a_{3→5}​,如下图所示(粗线表示),长度为 4+5+4+3=164+5+4+3=16。

image
进入练习

第 42 题

数据结构
13 分

(15 分)一个长度为 L(L≥1)的升序序列 S, 处在第⌊L/2⌉个位置的数称为 S 的中位数。例如,若序列S1= (11, 13, 15, 17, 19),则S1 的中位数是 15, 两个序列的中位数是含它们所有元素的升序序列的中位数。例如,若 S2= (2, 4, 6, 8, 20), 则 S1和S2 的中位数是 11。现在有两个等长升序序列A 和B, 试设计一个在时间和空间两方面都尽可能高效的算法,找出两个序列A 和 B 的中位数。

要求:

(1)给出算法的基本设计思想。

(2)根据设计思想,采用C、C++或Java 语言描述算法,关键之处给出注释。

(3)说明你所设计算法的时间复杂度和空间复杂度。

查看答案与解析收起答案与解析

题目详解:
(1) 求两个序列 A 和 B 的中位数最简单的办法就是将两个升序序列进行归并排序,然后求其中位数。这种解法虽可求解,但在时间和空间两方面都不大符合高效的要求,但也能获得部分分值。

根据题目分析,分别求两个升序序列 A 和 B 的中位数,设为 a 和 b。

① 若 a=ba = b,则 aa 或 bb 即为所求的中位数。

原因:容易验证,如果将两个序列归并排序,则最终序列中,排在子序列 b 前边的元素为先前两个序列中排在 a 和 b 前边的元素;排在子序列 ab 后边的元素为先前两个序列中排在 a 和 b后边的元素。所以子序列 ab 一定位于最终序列的中间,又因为 a=b,显然 a 就是中位数。

②否则(假设a<ba < b),中位数只能出现 (a,b) 范围内。

原因:同样可以用归并排序后的序列来验证,归并排序后必然有形如 ⋯a⋯b⋯\cdots a \cdots b \cdots 的序列出现,中位数必出现在 (a,b) 之间。因此可以做如下处理:舍弃 a 所在序列 A 的较小一半,同时舍弃 b 所在序列 B 的较大一半。在保留两个升序序列中求出新的中位数 a 和 b,重复上述过程,直到两个序列中只含一个元素时为止,则较小者即为所求的中位数。每次总的元素个数变为原来的一半。

算法的基本设计思想如下。

分别求出序列 A 和 B 的中位数,设为 a 和 b,求序列 A 和 B 的中位数过程如下:

① 若 a=ba=b,则 a 或 b 即为所求中位数,算法结束。

② 若a<ba<b,则舍弃序列 A 中较小的一半,同时舍弃序列 B 中较大的一半,要求舍弃的长度 相等。

③ 若 a>ba>b,则舍弃序列 A 中较大的一半,同时舍弃序列 B 中较小的一半,要求舍弃的长度 相等。

在保留的两个升序序列中,重复过程①、②、③,直到两个序列中只含一个元素时为止,较小者即为所求的中位数。

2)算法实现

c 复制代码
float mergeMedian(int a[], int b[], int n) {
  int i = 0;
  int j = 0;
  // n-1 = i+j
  while (i + j < n-1) {
    if (a[i] <= b[j]) {
      i++;
    } else {
      j++;
    }
  }
  // 在归并数组中下标为 n-1, n 的两个元素
  int prev, next;
  if (a[i] <= b[j]) {
    prev = a[i];
    if (i == n-1) {
      next = b[j];
    } else {
      next = min(a[i+1], b[j]);
    }
  } else {
    prev = b[j];
    if (j == n-1) {
      next = a[i];
    } else {
      next = min(b[j+1], a[i]);
    }
  }
  return 1.0 * (prev + next) / 2;
}

3)时间复杂度 O(n),空间复杂度 O(1)。

进入练习

第 43 题

计算机组成原理
12 分

(11 分)假定在一个 8 位字长的计算机中运行如下C 程序段:

cpp 复制代码
usigned int x=134;
unsigned int y=246;
int m=x;
int n=y;
unsigned int z1=x-y;
unsigned int z2=x+y;
int k1=m-n;
int k2=m+n;

若编译器编译时将 8 个 8 位寄存器R1~R8 分别分配给变量x、y、m、n、z1、z2、k1和k2。请回答下列问题。(提示:带符号整数用补码表示。)

(1)执行上述程序段后,寄存器R1、R5和R6 的内容分别是什么(用十六进制表示)?

(2)执行上述程序段后,变量m 和k1 的值分别是多少(用十进制表示)?

(3)上述程序段涉及带符号整数加/减、无符号整数加/减运算,这四种运算能否利用同一个加法器辅助电路实现?简述理由。

(4)计算机内部如何判断带符号整数加/减运算的结果是否发生溢出?上述程序段中,哪些带符号整数运算语句的执行结果会发生溢出?

查看答案与解析收起答案与解析

题目详解:
1)134 = 128 + 6 = 1000 0110B,所以 x 的机器数为 1000 0110B,故 R1 的内容为 86H。

246 = 255 - 9 = 1111 0110B,所以 y 的机器数为 1111 0110B。

x-y: 1000 0110 + 0000 1010 = (0)1001 0000,括弧中为加法器的进位,故 R5 的内容为 90H。

x+y: 1000 0110 + 1111 0110 = (1)0111 1100,括弧中为加法器的进位,故 R6 的内容为 7CH。

2)m 的机器数与 x 的机器数相同,皆为 86H=1000 0110B,解释为带符号整数 m(用补码 表示)时,其值为 -1111010B = -122。

m-n 的机器数与 x-y 的机器数相同,皆为 90H=1001 0000B,解释为带符号整数 k1(用 补码表示)时,其值为 -1110000B = -112。

3)能。n 位加法器实现的是模 2n2^n 无符号整数加法运算。

对于无符号整数 a 和 b,a + b 可以直接用加法器实现,而 a - b 可以通过 a 加上 b 的补数来实现,即 a - b 等价于 a 加上 -b 的补码,结果对 2 的 n 次方取模。因此,n 位无符号整数的加法和减法运算都可以通过 n 位加法器实现。

由于带符号整数使用补码表示,其加减法遵循的公式是:a + b 的补码等于 a 的补码加上 b 的补码,结果对 2 的 n 次方取模;同样,a - b 的补码等于 a 的补码加上 -b 的补码,结果也对 2 的 n 次方取模。因此,n 位带符号整数的加减运算也都可以通过 n 位加法器完成。

4)带符号整数加/减运算的溢出判断规则为:若加法器的两个输入端(加法)的符号相同,且不同于输出端(和)的符号,则结果溢出,或加法器完成加法操作时,若次高位的进位和最高位的进位不同,则结果溢出。

最后一条语句执行时会发生溢出。因为 10000110+11110110=(1)01111100,括弧中为加法器的进位,根据上述溢出判断规则,可知结果溢出。或因为 2 个带符号整数均为负数,它们相加之后,结果小于 8 位二进制所能表示的最小负数。

进入练习

第 44 题

计算机组成原理
11 分

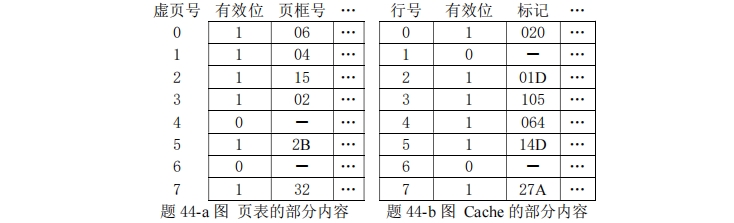
(12 分)某计算机存储器按字节编址, 虚拟(逻辑)地址空间大小为 16MB, 主存(物理)地址空间大小为 1MB, 页面大小为 4KB; Cache 采用直接映射方式,共 8 行;主存与Cache 之间交换的块大小为 32B。系统运行到某一时刻时,页表的部分内容和 Cache 的部分内容分别如题 44-a图、题 44-b 图所示,图中页框号及标记字段的内容为十六进制形式。请回答下列问题。

2011-44

(1)虚拟地址共有几位,哪几位表示虚页号?物理地址共有几位,哪几位表示页框号(物理页号)?

(2)使用物理地址访问Cache 时,物理地址应划分成哪几个字段?要求说明每个字段的位数及在物理地址中的位置。

(3)虚拟地址 001C60H 所在的页面是否在主存中?若在主存中, 则该虚拟地址对应的物理地址是什么?访问该地址时是否Cache 命中?要求说明理由。

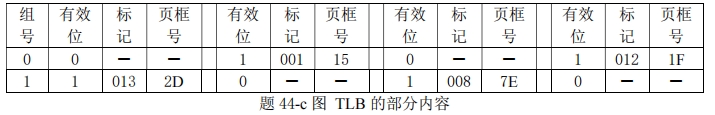
(4)假定为该机配置一个四路组相联的TLB 共可存放 8 个页表项, 若其当前内容(十六进制)如题 44-c 图所示,则此时虚拟地址 024BACH 所在的页面是否存在主存中?要求说明理由。

2011-44a
查看答案与解析收起答案与解析

题目详解:
1)存储器按字节编址,虚拟地址空间大小为 16B=24B,故虚拟地址为 24 位;页面大小为 4KB=212B4KB = 2^{12}B,故高 12 位为虚页号。主存地址空间大小为 1MB=22B1MB = 22B,故物理地址为 20 位;由于页内地址为 12 位,故高 8 位为页框号。

2)由于 Cache 采用直接映射方式,所以物理地址各字段的划分如下。

| Tag 标记 | Cache 行号 | 块内偏移 |

块大小为 32B,所以块内偏移为 5 位;Cache 共 8 行,故 Cache 行号为 3 位,标记字段为 20-5-3=12 位。

3)虚拟地址 001C60H 的前 12 位为虚页号,即 001H,查看 001H 处的页表项,其对应的效位为 1,故虚拟地址 001C60H 所在的页面在主存中。页表 001H 处的页框号为 04H,与页内偏移(虚拟地址后 12 位)拼接成物理地址为 04C60H.物理地址 04C60H=00000100110001100000B,主存块只能映射到 Cache 的第 3 行(即第 011B 行),由于该行的有效位=1,标记(值为 105H) ≠ 04CH(物理地址高 12 位),故不命中。

4)由于 TLB 采用四路组相联,故 TLB 被分为 8/4=2 个组,因此虚页号中高 11 位为 TLB 标记、最低 1 位为 TLB 组号。虚拟地址 024BACH=000000100100101110101100B,虚页号为 000000100100B,TLB 标记为 00000010010B(即 012H),TLB 组号为 0B,因此,该虚拟地址所对应物理页面只可能映射到 TLB 的第 0 组。组 0 中存在有效位=1、标记=012H 的项,因此访问 TLB 命中,即虚拟地址 024BACH 所在的页面在主存中。

进入练习

第 45 题

操作系统
8 分

(8 分)某银行提供 1 个服务窗口和 10 个供顾客等待的座位。顾客到达银行时,若有空座位,则到取号机上领取一个号,等待叫号。取号机每次仅允许一位顾客使用。当营业员空闲时,通过叫号选取一位顾客, 并为其服务。顾客和营业员的活动过程描述如下:

cpp 复制代码
    cobegin
    {
    	process 顾客i
        {
            从取号机获取一个号码;
            等待叫号;
            获取服务;
        }
        process 营业员
        {
            while (TRUE)
            {
                叫号;
                为客户服务
            }
        }
    }coend

请添加必要的信号量和P、V (或wait()、signal())操作,实现上述过程中的互斥与同步。要求写出完整的过程,说明信号量的含义并赋初值。

查看答案与解析收起答案与解析

题目详解:
1)互斥资源:取号机(一次只一位顾客领号),因此设一个互斥信号量 mutex。

2)同步问题:顾客需要获得空座位等待叫号,当营业员空闲时,将选取一位顾客并为其服务。空座位的有、无影响等待顾客数量,顾客的有、无决定了营业员是否能开始服务,故分别设置信号量 empty 和 full 来实现这一同步关系。另外,顾客获得空座位后,需要等待叫号和被服务。这样,顾客与营业员就服务何时开始又构成了一个同步关系,定义信号量 service 来完成这一同步过程。

复制代码
semaphore empty   = 10;       // 空座位的数量
semaphore mutex   = 1;        // 互斥使用取号机
semaphore full    = 0;        // 已占座位的数量
semaphore service = 0;        // 等待叫号

process 顾客 i {
    P(empty);                 // 等空位
    P(mutex);                 // 申请使用取号机
    从取号机上取号;
    V(mutex);                 // 取号完毕
    V(fu11);                  // 通知营业员有新顾客
    P(service);               // 等待营业员叫号
    接受服务;
}

process 营业员 {
    while(True) (
        P(fu11);              // 没有顾客则休息
        V(empty);             // 离开座位
        V(service);           // 叫号
        为顾客服务;
    }
}
进入练习

第 46 题

操作系统
7 分

(7分)某文件系统为一级目录结构,文件的数据一次性写入磁盘,已写入的文件不可修改,但可多次创建新文件。请回答如下问题。

(1)在连续、链式、索引三种文件的数据块组织方式中,哪种更合适?要求说明理由。为定位文件数据块,需要FCB 中设计哪些相关描述字段?

(2)为快速找到文件,对于 FCB, 是集中存储好,还是与对应的文件数据块连续存储好?要求说明理由。

查看答案与解析收起答案与解析

题目详解:
1)在磁盘中连续存放(采取连续结构),磁盘寻道时间更短,文件随机访问效率更高;在 FCB 中加入的字段为:<起始块号,块数> 或者 <起始块号,结束块号>。

2)将所有的 FCB 集中存放,文件数据集中存放。这样在随机查找文件名时,只需访问 FCB 对应的块,可减少磁头移动和磁盘 I/O 访问次数。

进入练习

第 47 题

计算机网络
9 分

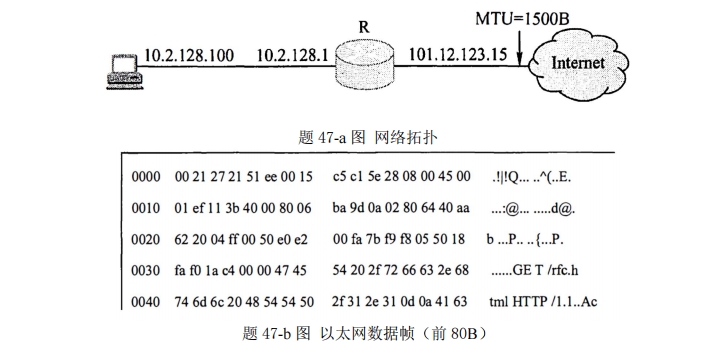
(9 分)某主机的MAC 地址为 00-15-C5-C1-5E-28, IP 地址为 10.2.128.100 (私有地址)。题 47-a 图是网络拓扑,题 47-b 图是该主机进行 Web 请求的 1 个以太网数据帧前 80B 的十六进制及ASCII 码内容。请参考图中的数据回答以下问题。

2011-47

(1)Web 服务器的IP 地址是什么?该主机的默认网关的MAC 地址是什么?

(2)该主机在构造题 47-b 图的数据帧时,使用什么协议确定目的MAC 地址?封装该协议请求报文的以太网帧的目的MAC 地址是什么?

(3)假设HTTP/1.1 协议以持续的非流水线方式工作,一次请求-响应时间为RTT , rfc.html 页面引用了 5 个JPEG 小图像,则从发出题 47-b 图中的Web 请求开始到浏览器收到全部内容为止,需要多少个RTT?

(4)该帧所封装的IP 分组经过路由器R 转发时,需修改IP 分组头中的哪些字段?

查看答案与解析收起答案与解析

题目详解:
1)以太网帧的数据部分是 IP 数据报,只要数出相应字段所在的字节即可。由图可知以太网帧头部有 6+6+2=14 字节,IP 数据报首部的目的 IP 地址字段前有 4×4=16 字节,从帧的第 1 字节开始数 14+16=30 字节,得目的 IP 地址 40.aa.62.20(十六进制),转换成十进制为 64.170.98.32。可知以太网帧的前 6 字节 00-21-27-21-51-ee 是的 MAC 地址,即为主机的默认网关 10.2.128.1 端口的 MAC 地址。

2)ARP 协议 于解决 IP 地址到 MAC 地址的映射问题。主机的 ARP 进程在本以太网以广播的形式发送 ARP 请求分组,在以太网上广播时,以太网帧的目的地址为全 1,即 FF-FF-FF-FF-FF-FF。

3)HTTP/1.1 协议以持续的 非流水线 方式工作时,服务器在发送响应后仍然在一段时间内保持这段连接,客户机在收到前一个请求的响应后才能发出下一个请求。第一个 RTT 用于请求 Web 页面,客户机收到第一个请求的响应后(还有五个请求未发送),每访问一次对象就用去一个 RTT。故共需 1+5=6 个 RTT 后浏览器收到全部内容。

4)源 IP 地址 0a.02.80.64 改为 65.0c.b7.0f;生存时间(TTL)减 1;校验和字段重新计算。私有地址和 Internet 的主机通信时,须由 NAT路由器进行网络地址转换,把 IP 数据报的源 IP 地址(本题为私有地址 10.2.128.100)转换为 NAT 路由器的一个全球 IP 地址(本题为 101.12.123.15)因此,源 IP 地址字段 0a 02 80 64 变为 65 0c 7b 0f。IP 数据报每经过一个路由器,生存时间 TTL 值就减 1,并重新计算首部校验和。若 IP 分组的长度超过输出链路的 MTU,则总长度字段、标志字段、片偏移字段也要发生变化。

注意:题 47-b 图中每行前 4bit 是数据帧的字节计数,不属于以太网数据帧的内容。

【评分说明】若考生解答时将所有 IP 头中的字段进行罗列,不给分,其他情况的情给分。

进入练习