2018计算机学科专业基础综合全卷预览

2018年408真题

2018年408真题完整试卷,包含 40 道选择题和 7 道综合应用题,共 47 题,题目分值合计 160 分。可按目录阅读全卷,展开参考答案解析,或进入对应题目练习。

返回年度练习
47题全卷题目
160分题目分值合计
40题选择题 · 80分
7题综合应用题 · 80分

选择题

40 题 · 共 80 分

第 1 题

数据结构
2 分

若栈S1 中保存整数,栈S2 中保存运算符,函数F()依次执行下述各步操作( )。

(1)从S1中依次弹出两个操作数a 和b;

(2)从S2中弹出一个运算符op:

(3)执行相应的运算b op a;

(4)将运算结果压入S1中。

假定S1中的操作数依次是 5, 8, 3, 2(2 在栈顶),S2 中的运算符依次是*, –, +(+在栈顶)。调用 3次F()后,S1栈顶保存的值是( )。

A. -15

B. 15

C. -20

D. 20

查看答案与解析收起答案与解析

参考答案:B

题目详解:
首先,我们需要明确栈 S1 S_1 和栈 S2 S_2 的初始状态以及函数 F() F() 的执行步骤。

初始状态:

  • 栈 S1 S_1 中的操作数依次是 5,8,3,2 5, 8, 3, 2 (2 2 在栈顶),即栈从顶到底为 2,3,8,5 2, 3, 8, 5 。
  • 栈 S2 S_2 中的运算符依次是 ∗,−,+ *, -, + (+ + 在栈顶),即栈从顶到底为 +,−,∗ +, -, * 。

函数 F() F() 的执行步骤如下:

  1. 从 S1 S_1 中依次弹出两个操作数 a a 和 b b (a a 是第一个弹出的,b b 是第二个弹出的)。
  2. 从 S2 S_2 中弹出一个运算符 op op 。
  3. 执行相应的运算 b op a b \ op \ a 。
  4. 将运算结果压入 S1 S_1 中。

调用 3 3 次 F() F() 的过程如下:

第一次调用 F() F() :

  1. 弹出 a=2 a = 2 和 b=3 b = 3 。
  2. 弹出 op=+ op = + 。
  3. 计算 3+2=5 3 + 2 = 5 。
  4. 将 5 5 压入 S1 S_1 。
    此时 S1 S_1 的状态为 5,8,5 5, 8, 5 (从顶到底)。
    S2 S_2 的状态为 −,∗ -, * 。

第二次调用 F() F() :

  1. 弹出 a=5 a = 5 和 b=8 b = 8 。
  2. 弹出 op=− op = - 。
  3. 计算 8−5=3 8 - 5 = 3 。
  4. 将 3 3 压入 S1 S_1 。
    此时 S1 S_1 的状态为 3,5 3, 5 (从顶到底)。
    S2 S_2 的状态为 ∗ * 。

第三次调用 F() F() :

  1. 弹出 a=3 a = 3 和 b=5 b = 5 。
  2. 弹出 op=∗ op = * 。
  3. 计算 5∗3=15 5 * 3 = 15 。
  4. 将 15 15 压入 S1 S_1 。
    此时 S1 S_1 的状态为 15 15 (从顶到底)。
    S2 S_2 的状态为空。

调用 3 3 次 F() F() 后,S1 S_1 栈顶保存的值是 15 15 。

正确答案:B

进入练习

第 2 题

数据结构
2 分

现有队列Q 与栈S,初始时Q 中的元素依次是 1, 2, 3, 4, 5, 6(1 在队头),S 为空。若仅允许下列3 种操作:①出队并输出出队元素:②出队并将出队元素入栈:③出栈并输出出栈元素,则不能得到的输出序列是( )。

A. 1, 2, 5, 6, 4, 3

B. 2, 3, 4, 5, 6, 1

C. 3, 4, 5, 6, 1, 2

D. 6, 5, 4, 3, 2, 1

查看答案与解析收起答案与解析

参考答案:C

题目详解:
初始时,队列 Q Q 中的元素为 1,2,3,4,5,6 1, 2, 3, 4, 5, 6 ( 1 1 在队头),栈 S S 为空。我们需要验证每个选项是否可以通过给定的操作序列得到。

选项A: 1,2,5,6,4,3 1, 2, 5, 6, 4, 3

  1. 操作①:出队并输出 1 1 , Q Q 变为 2,3,4,5,6 2, 3, 4, 5, 6 。

  2. 操作①:出队并输出 2 2 , Q Q 变为 3,4,5,6 3, 4, 5, 6 。

  3. 操作②:出队并将 3 3 入栈, Q Q 变为 4,5,6 4, 5, 6 , S S 为 3 3 。

  4. 操作②:出队并将 4 4 入栈, Q Q 变为 5,6 5, 6 , S S 为 4,3 4, 3 。

  5. 操作①:出队并输出 5 5 , Q Q 变为 6 6 。

  6. 操作①:出队并输出 6 6 , Q Q 为空。

  7. 操作③:出栈并输出 4 4 , S S 为 3 3 。

  8. 操作③:出栈并输出 3 3 , S S 为空。

    输出序列为 1,2,5,6,4,3 1, 2, 5, 6, 4, 3 ,与选项A一致。因此,选项A是可以得到的。

选项B: 2,3,4,5,6,1 2, 3, 4, 5, 6, 1

  1. 操作②:出队并将 1 1 入栈, Q Q 变为 2,3,4,5,6 2, 3, 4, 5, 6 , S S 为 1 1 。

  2. 操作①:出队并输出 2 2 , Q Q 变为 3,4,5,6 3, 4, 5, 6 。

  3. 操作①:出队并输出 3 3 , Q Q 变为 4,5,6 4, 5, 6 。

  4. 操作①:出队并输出 4 4 , Q Q 变为 5,6 5, 6 。

  5. 操作①:出队并输出 5 5 , Q Q 变为 6 6 。

  6. 操作①:出队并输出 6 6 , Q Q 为空。

  7. 操作③:出栈并输出 1 1 , S S 为空。

    输出序列为 2,3,4,5,6,1 2, 3, 4, 5, 6, 1 ,与选项B一致。因此,选项B是可以得到的。

选项C: 3,4,5,6,1,2 3, 4, 5, 6, 1, 2

  1. 要输出 3 3 作为第一个元素,必须先将 1 1 和 2 2 入栈:

    • 操作②:出队并将 1 1 入栈, Q Q 变为 2,3,4,5,6 2, 3, 4, 5, 6 , S S 为 1 1 。
    • 操作②:出队并将 2 2 入栈, Q Q 变为 3,4,5,6 3, 4, 5, 6 , S S 为 2,1 2, 1 。
    • 操作①:出队并输出 3 3 , Q Q 变为 4,5,6 4, 5, 6 。
  2. 接下来输出 4,5,6 4, 5, 6 :

    • 操作①:出队并输出 4 4 , Q Q 变为 5,6 5, 6 。
    • 操作①:出队并输出 5 5 , Q Q 变为 6 6 。
    • 操作①:出队并输出 6 6 , Q Q 为空。
  3. 最后需要输出 1,2 1, 2 ,但栈 S S 的顺序是 2,1 2, 1 ,因此只能先输出 2 2 再输出 1 1 ,无法得到 1,2 1, 2 的顺序。

    因此,选项C是无法得到的。

选项D: 6,5,4,3,2,1 6, 5, 4, 3, 2, 1

  1. 将所有元素入栈:

    • 操作②:出队并将 1 1 入栈, Q Q 变为 2,3,4,5,6 2, 3, 4, 5, 6 , S S 为 1 1 。
    • 操作②:出队并将 2 2 入栈, Q Q 变为 3,4,5,6 3, 4, 5, 6 , S S 为 2,1 2, 1 。
    • 操作②:出队并将 3 3 入栈, Q Q 变为 4,5,6 4, 5, 6 , S S 为 3,2,1 3, 2, 1 。
    • 操作②:出队并将 4 4 入栈, Q Q 变为 5,6 5, 6 , S S 为 4,3,2,1 4, 3, 2, 1 。
    • 操作②:出队并将 5 5 入栈, Q Q 变为 6 6 , S S 为 5,4,3,2,1 5, 4, 3, 2, 1 。
    • 操作②:出队并将 6 6 入栈, Q Q 为空, S S 为 6,5,4,3,2,1 6, 5, 4, 3, 2, 1 。
  2. 依次出栈并输出:

    • 操作③:出栈并输出 6 6 , S S 为 5,4,3,2,1 5, 4, 3, 2, 1 。
    • 操作③:出栈并输出 5 5 , S S 为 4,3,2,1 4, 3, 2, 1 。
    • 操作③:出栈并输出 4 4 , S S 为 3,2,1 3, 2, 1 。
    • 操作③:出栈并输出 3 3 , S S 为 2,1 2, 1 。
    • 操作③:出栈并输出 2 2 , S S 为 1 1 。
    • 操作③:出栈并输出 1 1 , S S 为空。

    输出序列为 6,5,4,3,2,1 6, 5, 4, 3, 2, 1 ,与选项D一致。因此,选项D是可以得到的。

综上所述,不能得到的输出序列是选项C。

正确答案:C

进入练习

第 3 题

数据结构
2 分

设有一个 12×12 的对称矩阵M,将其上三角部分的元素mij(1≤i≤j≤12)按行优先存入C 语言的一维数组N 中,元素m6, 6在N 中的下标是( )。

A. 50

B. 51

C. 55

D. 66

查看答案与解析收起答案与解析

参考答案:A

题目详解:
对称矩阵 M M 的上三角部分(包括对角线)共有 n(n+1)2 \frac{n(n+1)}{2} 个元素,其中 n=12 n = 12 。因此,上三角部分总共有 12×132=78 \frac{12 \times 13}{2} = 78 个元素。

在行优先存储方式下,上三角部分的元素按行依次存入一维数组 N N 中。我们需要计算元素 m6,6 m_{6,6} 在 N N 中的下标。

  1. 首先计算前 5 5 行(i=1 i = 1 到 i=5 i = 5 )的元素总数:

    • 第 1 1 行有 12 12 个元素(j=1 j = 1 到 j=12 j = 12 )。
    • 第 2 2 行有 11 11 个元素(j=2 j = 2 到 j=12 j = 12 )。
    • ...
    • 第 5 5 行有 8 8 个元素(j=5 j = 5 到 j=12 j = 12 )。

    前 5 5 行的元素总数为:
    12+11+10+9+8=50 12 + 11 + 10 + 9 + 8 = 50

  2. 元素 m6,6 m_{6,6} 是第 6 6 行的第 1 1 个元素(因为 j j 从 6 6 开始),所以它在 N N 中的下标为前 5 5 行的元素总数加上 0 0 (因为是第 1 1 个元素),即 50+0=50 50 + 0 = 50 。

因此,m6,6 m_{6,6} 在 N N 中的下标是 50 50 。

正确答案:A

进入练习

第 4 题

数据结构
2 分

设一棵非空完全二叉树T 的所有叶结点均位于同一层,且每个非叶结点都有 2 个子结点。若T 有k 个叶结点,则T 的结点总数是( )。

A. 2k – 1

B. 2k

C. k2

D. 2k – 1

查看答案与解析收起答案与解析

参考答案:A

题目详解:
根据题目描述,这是一棵非空完全二叉树,且所有叶结点均位于同一层,每个非叶结点都有 2 个子结点。这种树的结构是一个满二叉树。

在满二叉树中,叶结点的数量 k k 与树的高度 h h 满足关系:
k=2h−1 k = 2^{h-1}
其中 h h 是树的高度(根结点的高度为 1)。

满二叉树的总结点数 N N 可以通过以下公式计算:
N=2h−1 N = 2^h - 1

将 k=2h−1 k = 2^{h-1} 代入 N N 的公式中:
N=2×2h−1−1=2k−1 N = 2 \times 2^{h-1} - 1 = 2k - 1

因此,T 的结点总数是 2k−1 2k - 1 。

正确答案:A

进入练习

第 5 题

数据结构
2 分

已知字符集{a, b, c, d, e, f},若各字符出现的次数分别为 6, 3, 8, 2, 10, 4,则对应字符集中各字符的哈夫曼编码可能是( )。

A. 00, 1011, 01, 1010, 11, 100

B. 00, 100, 110, 000, 0010, 01

C. 10, 1011, 11, 0011, 00, 010

D. 0011, 10, 11, 0010, 01, 000

查看答案与解析收起答案与解析

参考答案:A

题目详解:
首先,我们需要根据字符出现的频率构建哈夫曼树。步骤如下:

  1. 将字符及其频率按升序排列:

    • d:2 d: 2
    • b:3 b: 3
    • f:4 f: 4
    • a:6 a: 6
    • c:8 c: 8
    • e:10 e: 10
  2. 每次选择频率最小的两个节点合并,直到形成完整的哈夫曼树:

    • 合并 d d 和 b b ,得到新节点 db:5 db: 5 (2+3 2 + 3 )。
    • 合并 f f 和 db db ,得到新节点 fdb:9 fdb: 9 (4+5 4 + 5 )。
    • 合并 a a 和 c c ,得到新节点 ac:14 ac: 14 (6+8 6 + 8 )。
    • 合并 fdb fdb 和 e e ,得到新节点 fdbe:19 fdbe: 19 (9+10 9 + 10 )。
    • 最后合并 ac ac 和 fdbe fdbe ,得到根节点 acfdbe:33 acfdbe: 33 (14+19 14 + 19 )。
  3. 根据哈夫曼树为每个字符分配编码:

    • 从根节点出发,左分支为 0 0 ,右分支为 1 1 。
    • e e 的编码为 11 11 (出现频率最高,路径最短)。
    • c c 的编码为 01 01 。
    • a a 的编码为 00 00 。
    • f f 的编码为 100 100 。
    • b b 的编码为 1011 1011 。
    • d d 的编码为 1010 1010 。
  4. 将编码与选项对比:

    • A 选项中的编码顺序为 a:00 a:00 , b:1011 b:1011 , c:01 c:01 , d:1010 d:1010 , e:11 e:11 , f:100 f:100 ,与我们的结果一致。
    • 其他选项的编码不符合哈夫曼编码规则。

正确答案:A

进入练习

第 6 题

数据结构
2 分

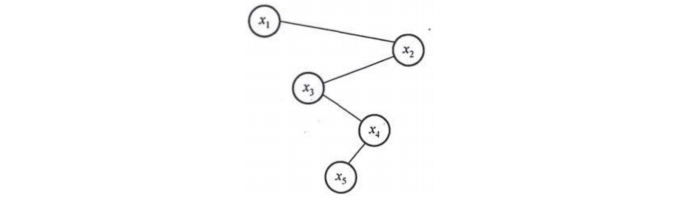
己知二叉排序树如下图所示,元素之间应满足的大小关系是( )。

2018-6

A. x1 < x2 < x4

B. x1 < x4 < x5

C. x3 < x5 < x4

D. x4 < x3 < x5

查看答案与解析收起答案与解析

参考答案:C

题目详解:

根据二叉排序树的特性:中序遍历(LNR)得到的是一个递增序列。图中二叉排序树的中序遍历序列为 xi,x3,x5,x4,x2x_i, x_3, x_5, x_4, x_2,可知 x3<x5<x4x_3 < x_5 < x_4。

正确答案: C

进入练习

第 7 题

数据结构
2 分

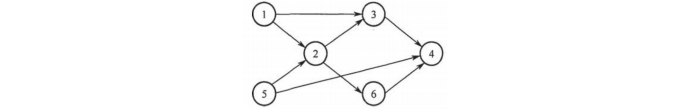
下列选项中,不是如下有向图的拓扑序列的是( )。

2018-7

A. 1, 5, 2, 3, 6, 4

B. 5, 1, 2, 6, 3, 4

C. 5, 1, 2, 3, 6, 4

D. 5, 2, 1, 6, 3, 4

查看答案与解析收起答案与解析

参考答案:D

题目详解:

拓扑排序每次选取入度为 0 的结点输出,经观察不难发现拓扑序列前两位一定是 1,5 或 5,1(因为只有 1 和 5 的入度均为 0,且其他结点都不满足仅有 1 或仅有 5 作为前驱)。因此 D 显然错误。

正确答案:D

进入练习

第 8 题

数据结构
2 分

高度为5的3阶B 树含有的关键字个数至少是( )。

A. 15

B. 31

C. 62

D. 242

查看答案与解析收起答案与解析

参考答案:B

题目详解:
一个 m m 阶B树的最小关键字个数可以通过以下方式计算:

  1. B树的最小关键字个数公式:对于高度为 h h 的 m m 阶B树,最小关键字个数为 2⋅⌈m/2⌉h−1−2 2 \cdot \lceil m/2 \rceil^{h-1} - 2 。

  2. 题目参数:

    • 阶数 m=3 m = 3 ,因此 ⌈m/2⌉=⌈3/2⌉=2 \lceil m/2 \rceil = \lceil 3/2 \rceil = 2 。
    • 高度 h=5 h = 5 。
  3. 代入计算:
    2⋅25−1−2=2⋅24−2=2⋅16−2=32−2=30 2 \cdot 2^{5-1} - 2 = 2 \cdot 2^{4} - 2 = 2 \cdot 16 - 2 = 32 - 2 = 30
    然而,这个公式计算的是最小关键字个数的下限,更准确的最小关键字个数可以通过递归方式计算:

    • 根结点至少有 1 1 个关键字。
    • 其他非叶子结点至少有 ⌈m/2⌉−1=1 \lceil m/2 \rceil - 1 = 1 个关键字。
    • 每个非叶子结点(除根外)至少有 2 2 个子结点。
    • 高度为 5 5 的B树的最小关键字总数为:
      1+2⋅(1+2⋅(1+2⋅(1+2⋅1)))=1+2⋅(1+2⋅(1+2⋅3))=1+2⋅(1+2⋅7)=1+2⋅15=31 1 + 2 \cdot (1 + 2 \cdot (1 + 2 \cdot (1 + 2 \cdot 1))) = 1 + 2 \cdot (1 + 2 \cdot (1 + 2 \cdot 3)) = 1 + 2 \cdot (1 + 2 \cdot 7) = 1 + 2 \cdot 15 = 31

因此,高度为 5 5 的 3 3 阶B树的最小关键字个数为 31 31 。

正确答案:B

进入练习

第 9 题

数据结构
2 分

现有长度为 7、初始为空的散列表HT,散列函数:H(k) = k % 7,用线性探测再散列法解决冲突。将关键字 22, 43, 15 依次插入到HT 后,查找成功的平均查找长度是( )。

A. 1.5

B. 1.6

C. 2

D. 3

查看答案与解析收起答案与解析

参考答案:C

题目详解:
首先,我们有一个长度为 7 7 的散列表 HT HT ,初始为空。散列函数为 H(k)=k%7 H(k) = k \% 7 ,并使用线性探测再散列法解决冲突。

  1. 插入关键字 22 22 :

    • 计算散列值:H(22)=22%7=1 H(22) = 22 \% 7 = 1 。
    • HT[1] HT[1] 为空,直接插入 22 22 。
    • 查找长度为 1 1 。
  2. 插入关键字 43 43 :

    • 计算散列值:H(43)=43%7=1 H(43) = 43 \% 7 = 1 。
    • HT[1] HT[1] 已被 22 22 占用,发生冲突。
    • 使用线性探测法,检查下一个位置 HT[2] HT[2] ,为空,插入 43 43 。
    • 查找长度为 2 2 。
  3. 插入关键字 15 15 :

    • 计算散列值:H(15)=15%7=1 H(15) = 15 \% 7 = 1 。
    • HT[1] HT[1] 被 22 22 占用,发生冲突。
    • 检查 HT[2] HT[2] ,被 43 43 占用,继续检查 HT[3] HT[3] ,为空,插入 15 15 。
    • 查找长度为 3 3 。

查找成功的平均查找长度(ASL)计算公式为:

ASL=所有关键字的查找长度之和关键字数量ASL = \frac{\text{所有关键字的查找长度之和}}{\text{关键字数量}}

这里所有关键字的查找长度之和为 1+2+3=6 1 + 2 + 3 = 6 ,关键字数量为 3 3 ,因此:

ASL=63=2ASL = \frac{6}{3} = 2

正确答案:C

进入练习

第 10 题

数据结构
2 分

对初始数据序列(8, 3, 9, 11, 2, 1, 4, 7, 5, 10, 6)进行希尔排序。若第一趟排序结果为(1, 3, 7, 5,2, 6, 4, 9, 11, 10, 8),第二趟排序结果为(1, 2, 6, 4, 3, 7, 5, 8, 11, 10, 9),则两趟排序采用的增量(间隔)依次是( )。

A. 3, 1

B. 3, 2

C. 5, 2

D. 5, 3

查看答案与解析收起答案与解析

参考答案:D

题目详解:
希尔排序的增量序列决定了每次排序的子序列间隔。我们需要根据给定的排序结果反推出增量。

  1. 初始序列:(8,3,9,11,2,1,4,7,5,10,6) (8, 3, 9, 11, 2, 1, 4, 7, 5, 10, 6)

  2. 第一趟排序结果:(1,3,7,5,2,6,4,9,11,10,8) (1, 3, 7, 5, 2, 6, 4, 9, 11, 10, 8)

    • 假设增量为 d1 d_1 ,将初始序列分为 d1 d_1 个子序列,每个子序列进行插入排序。
    • 观察第一趟结果,1 1 移动到了最前面,说明 d1 d_1 较大。尝试 d1=5 d_1 = 5 :
      • 子序列为:(8,1,6) (8, 1, 6) 、(3,4,10) (3, 4, 10) 、(9,7) (9, 7) 、(11,5) (11, 5) 、(2,6) (2, 6) 。
      • 对子序列排序后合并,与第一趟结果一致,因此 d1=5 d_1 = 5 。
  3. 第二趟排序结果:(1,2,6,4,3,7,5,8,11,10,9) (1, 2, 6, 4, 3, 7, 5, 8, 11, 10, 9)

    • 在第一趟结果的基础上,假设增量为 d2 d_2 。
    • 观察第二趟结果,2 2 和 3 3 等元素移动,说明 d2 d_2 较小。尝试 d2=3 d_2 = 3 :
      • 子序列为:(1,4,5,10) (1, 4, 5, 10) 、(3,2,7,8,9) (3, 2, 7, 8, 9) 、(7,6,11) (7, 6, 11) 。
      • 对子序列排序后合并,与第二趟结果一致,因此 d2=3 d_2 = 3 。

因此,两趟排序采用的增量依次是 5,3 5, 3 。

正确答案:D

进入练习

第 11 题

数据结构
2 分

在将数据序列(6, 1, 5, 9, 8, 4, 7)建成大根堆时,正确的序列变化过程是( )。

A. 6, 1, 7, 9, 8, 4, 5→6, 9, 7, 1, 8, 4, 5→9, 6, 7, 1, 8, 4, 5→9, 8, 7, 1, 6, 4, 5

B. 6, 9, 5, 1, 8, 4, 7→6, 9, 7, 1, 8, 4, 5→9, 6, 7, 1, 8, 4, 5→9, 8, 7, 1, 6, 4, 5

C. 6, 9, 5, 1, 8, 4, 7→9, 6, 5, 1, 8, 4, 7→9, 6, 7, 1, 8, 4, 5→9, 8, 7, 1, 6, 4, 5

D. 6, 1, 7, 9, 8, 4, 5→7, 1, 6, 9, 8, 4, 5→7, 9, 6, 1, 8, 4, 5→9, 7, 6, 1, 8, 4, 5→9, 8, 6, 1, 7, 4, 5

查看答案与解析收起答案与解析

参考答案:A

题目详解:
大根堆的构建过程是从最后一个非叶子节点开始,依次向上调整,使得每个子树都满足大根堆的性质(父节点的值大于等于子节点的值)。初始序列为 (6,1,5,9,8,4,7) (6, 1, 5, 9, 8, 4, 7) 。

  1. 第一步调整:最后一个非叶子节点是索引 2 2 (值为 5 5 ),比较其子节点 4 4 (左)和 7 7 (右),7 7 更大,交换 5 5 和 7 7 ,序列变为 (6,1,7,9,8,4,5) (6, 1, 7, 9, 8, 4, 5) 。

  2. 第二步调整:调整索引 1 1 (值为 1 1 ),其子节点为 9 9 (左)和 8 8 (右),9 9 更大,交换 1 1 和 9 9 ,序列变为 (6,9,7,1,8,4,5) (6, 9, 7, 1, 8, 4, 5) 。

  3. 第三步调整:调整索引 0 0 (值为 6 6 ),其子节点为 9 9 (左)和 7 7 (右),9 9 更大,交换 6 6 和 9 9 ,序列变为 (9,6,7,1,8,4,5) (9, 6, 7, 1, 8, 4, 5) 。此时需要检查交换后的子树(6 6 为根),其子节点为 1 1 和 8 8 ,8 8 更大,交换 6 6 和 8 8 ,最终序列变为 (9,8,7,1,6,4,5) (9, 8, 7, 1, 6, 4, 5) 。

因此,正确的序列变化过程是选项 A 的步骤:
6,1,7,9,8,4,5→6,9,7,1,8,4,5→9,6,7,1,8,4,5→9,8,7,1,6,4,5 6, 1, 7, 9, 8, 4, 5 \rightarrow 6, 9, 7, 1, 8, 4, 5 \rightarrow 9, 6, 7, 1, 8, 4, 5 \rightarrow 9, 8, 7, 1, 6, 4, 5 。

正确答案:A

进入练习

第 12 题

计算机组成原理
2 分

冯·诺依曼结构计算机中数据采用二进制编码表示,其主要原因是( )。

I. 二进制的运算规则简单

II. 制造两个稳态的物理器件较容易

III. 便于用逻辑门电路实现算术运算

A. 仅I、II

B. 仅I、III

C. 仅II、III

D. I、II 和III

查看答案与解析收起答案与解析

参考答案:D

题目详解:
冯·诺依曼结构计算机采用二进制编码表示数据的主要原因包括以下几点:

  1. 二进制的运算规则简单(I):二进制只有 0 0 和 1 1 两个数码,其运算规则比十进制简单得多。例如,加法规则仅有 0+0=0 0 + 0 = 0 、0+1=1 0 + 1 = 1 、1+0=1 1 + 0 = 1 和 1+1=10 1 + 1 = 10 (进位),这使得硬件实现更加高效。

  2. 制造两个稳态的物理器件较容易(II):二进制只需要物理器件具有两个稳定的状态(如高电平和低电平、开关的导通和截止等),这种设计在工程上更容易实现,且抗干扰能力强。例如,晶体管可以很容易地表示 0 0 和 1 1 两种状态。

  3. 便于用逻辑门电路实现算术运算(III):二进制与逻辑门电路(如与门、或门、非门等)天然契合,可以方便地通过逻辑电路实现算术和逻辑运算。例如,加法器可以通过组合逻辑门直接实现二进制加法。

综上所述,I、II 和 III 都是冯·诺依曼结构计算机采用二进制编码的主要原因。

正确答案:D

进入练习

第 13 题

计算机组成原理
2 分

假定带符号整数采用补码表示,若int 型变量x 和y 的机器数分别是FFFF FFDFH 和 00000041H,则x、y 的值以及x – y 的机器数分别是( )。

A. x = -65, y = 41, x – y 的机器数溢出

B. x = -33, y = 65, x – y 的机器数为FFFF FF9DH

C. x = -33, y = 65, x – y 的机器数为FFFF FF9EH

D. x = -65, y = 41, x – y 的机器数为FFFF FF96H

查看答案与解析收起答案与解析

参考答案:C

题目详解:
首先,我们需要将给定的十六进制机器数转换为对应的十进制值,并计算 x−y x - y 的机器数。

  1. 转换 x x 的机器数 FFFF FFDFH:

    • 这是一个补码表示的负数。补码转换为原码的方法是:取反加 1。
    • 取反:FFFF FFDFH \text{FFFF FFDFH} 取反得到 00000020H 0000 0020H 。
    • 加 1:00000020H+1=00000021H 0000 0020H + 1 = 0000 0021H 。
    • 转换为十进制:00000021H=33 0000 0021H = 33 ,所以 x=−33 x = -33 。
  2. 转换 y y 的机器数 0000 0041H:

    • 这是一个正数,直接转换为十进制:00000041H=65 0000 0041H = 65 ,所以 y=65 y = 65 。
  3. 计算 x−y x - y 的机器数:

    • x−y=−33−65=−98 x - y = -33 - 65 = -98 。
    • 将 −98-98 转换为补码表示:
      • 绝对值的二进制表示:98=62H=00000062H 98 = 62H = 0000 0062H 。
      • 取反:00000062H 0000 0062H 取反得到 FFFFFF9DH FFFF FF9DH 。
      • 加 1:FFFFFF9DH+1=FFFFFF9EH FFFF FF9DH + 1 = FFFF FF9EH 。
    • 因此,x−y x - y 的机器数为 FFFF FF9EH \text{FFFF FF9EH} 。

综上所述,x=−33 x = -33 ,y=65 y = 65 ,x−y x - y 的机器数为 FFFF FF9EH \text{FFFF FF9EH} 。

正确答案:C

进入练习

第 14 题

计算机组成原理
2 分

IEEE 754 单精度浮点格式表示的数中,最小的规格化正数是( )。

A. 1.0×2-126

B. 1.0×2-127

C. 1.0×2-128

D. 1.0×2-149

查看答案与解析收起答案与解析

参考答案:A

题目详解:
IEEE 754 单精度浮点数的格式由 1 位符号位 S S 、8 位阶码 E E 和 23 位尾数 M M 组成。规格化数的阶码 E E 范围为 1≤E≤254 1 \leq E \leq 254 (全 0 和全 1 有特殊用途),对应的指数 e e 计算为 e=E−127 e = E - 127 ,因此指数的范围为 −126≤e≤127 -126 \leq e \leq 127 。

规格化数的尾数部分隐含最高位为 1,因此其实际值为 1.M 1.M 。最小的规格化正数出现在 E=1 E = 1 (即 e=−126 e = -126 )且尾数 M=0 M = 0 时,其值为:
1.0×2−126 1.0 \times 2^{-126}

其他选项分析:

  • 选项 B 1.0×2−127 1.0 \times 2^{-127} :对应的阶码 E=0 E = 0 ,此时表示的是非规格化数或零,不是规格化数。
  • 选项 C 1.0×2−128 1.0 \times 2^{-128} :阶码 E=−1 E = -1 ,超出单精度浮点数的表示范围。
  • 选项 D 1.0×2−149 1.0 \times 2^{-149} :这是最小的非规格化正数,而非规格化数。

因此,最小的规格化正数是 1.0×2−126 1.0 \times 2^{-126} 。

正确答案:A

进入练习

第 15 题

计算机组成原理
2 分

某 32 位计算机按字节编址,采用小端(Little Endian)方式。若语句“int i = 0; ”对应指令的机器代码为“C745FC 00 00 00 00”,则语句“int i = -64; ”对应指令的机器代码是( )。

A. C745FC C0FF FF FF

B. C745FC 0C FF FF FF

C. C745FC FF FF FF C0

D. C745FC FF FF FF 0C

查看答案与解析收起答案与解析

参考答案:A

题目详解:
在32位计算机中,int类型通常占用4个字节(32位)。题目中采用小端(Little Endian)方式存储数据,即低字节存储在低地址,高字节存储在高地址。

  1. 首先分析语句 int i = 0; 的机器代码为 C745FC 00 00 00 00:

    • C745FC 是操作码部分,表示将数据存储到某个地址。
    • 00 00 00 00 是数据部分,表示 i = 0 的32位补码表示。
  2. 现在分析 int i = -64; 的机器代码:

    • -64 的32位补码表示:
      • 64的二进制表示为 00000000 00000000 00000000 01000000 00000000\ 00000000\ 00000000\ 01000000 。
      • 取反后为 11111111 11111111 11111111 10111111 11111111\ 11111111\ 11111111\ 10111111 。
      • 加1后得到补码 11111111 11111111 11111111 11000000 11111111\ 11111111\ 11111111\ 11000000 ,即十六进制 FF FF FF C0。
    • 由于是小端存储,字节顺序为从低到高,因此数据部分应为 C0 FF FF FF。
    • 完整的机器代码为操作码 C745FC 加上数据部分 C0 FF FF FF,即 C745FC C0 FF FF FF。
  3. 对比选项:

    • A选项 C745FC C0 FF FF FF 符合计算结果。
    • B、C、D选项的字节顺序或数据值不正确。

正确答案:A

进入练习

第 16 题

计算机组成原理
2 分

整数x 的机器数为 1101 1000,分别对x 进行逻辑右移 1 位和算术右移 1 位操作,得到的机器数分别是( )。

A. 1110 1100,1110 1100

B. 0110 1100,1110 1100

C. 1110 1100,0110 1100

D. 0110 1100,0110 1100

查看答案与解析收起答案与解析

参考答案:B

题目详解:
逻辑右移和算术右移的区别在于对最高位(符号位)的处理方式:

  1. 逻辑右移:无论最高位是 0 0 还是 1 1 ,右移后最高位补 0 0 。右移 1 1 位时,所有位向右移动一位,最左边补 0 0 。

    • 原始机器数:1101 1000 1101\ 1000
    • 逻辑右移 1 1 位后:0110 1100 0110\ 1100
  2. 算术右移:最高位(符号位)保持不变,右移后最高位补原来的符号位。右移 1 1 位时,所有位向右移动一位,最左边补原来的符号位 1 1 。

    • 原始机器数:1101 1000 1101\ 1000
    • 算术右移 1 1 位后:1110 1100 1110\ 1100

因此,逻辑右移 1 1 位得到 0110 1100 0110\ 1100 ,算术右移 1 1 位得到 1110 1100 1110\ 1100 。

正确答案:B

进入练习

第 17 题

计算机组成原理
2 分

假定DRAM 芯片中存储阵列的行数为r、列数为c,对于一个 2K×1 位的DRAM 芯片,为保证其地址引脚数最少,并尽量减少刷新开销,则r、c 的取值分别是( )。

A. 2048、1

B. 64、32

C. 32、64

D. 1、2048

查看答案与解析收起答案与解析

参考答案:C

题目详解:
对于一个 2K×1 2K \times 1 位的DRAM芯片,其总容量为 211=2048 2^{11} = 2048 个存储单元。为了减少地址引脚数,DRAM通常采用行列地址复用的方式,因此需要将地址分为行地址和列地址两部分。设行数为 r r ,列数为 c c ,则有 r×c=2048 r \times c = 2048 。

为了尽量减少刷新开销,应该尽量减少行数 r r ,因为DRAM的刷新是按行进行的,行数越少,刷新开销越小。因此,我们需要将 r r 和 c c 的取值尽可能均衡,同时让 r r 尽可能小。

将 2048 2048 分解为 r×c r \times c 的形式,有以下几种可能:

  • r=32 r = 32 ,c=64 c = 64 (32×64=2048 32 \times 64 = 2048 )
  • r=64 r = 64 ,c=32 c = 32 (64×32=2048 64 \times 32 = 2048 )
  • r=2048 r = 2048 ,c=1 c = 1 (2048×1=2048 2048 \times 1 = 2048 )
  • r=1 r = 1 ,c=2048 c = 2048 (1×2048=2048 1 \times 2048 = 2048 )

其中,r=32 r = 32 和 r=64 r = 64 是较优的选择,但为了进一步减少刷新开销,应选择行数 r r 更小的方案,即 r=32 r = 32 ,c=64 c = 64 。

因此,正确答案是选项C。

正确答案:C

进入练习

第 18 题

计算机组成原理
2 分

按字节编址的计算机中,某double 型数组A 的首地址为 2000H,使用变址寻址和循环结构访问数组A,保存数组下标的变址寄存器初值为0,每次循环取一个数组元素,其偏移地址为变址值乘以sizeof(double),取完后变址寄存器内容自动加 1。若某次循环所取元素的地址为 2100H,则进入该次循环时变址寄存器的内容是( )。

A. 25

B. 32

C. 64

D. 100

查看答案与解析收起答案与解析

参考答案:B

题目详解:
根据题目描述,数组 A A 的首地址为 2000H 2000H ,每次循环取一个数组元素时,偏移地址为变址值乘以 sizeof(double) \text{sizeof(double)} 。在大多数系统中,sizeof(double) \text{sizeof(double)} 为 8 8 字节。

设进入循环时变址寄存器的内容为 x x ,则本次循环所取元素的地址为:2000H+x×8 2000H + x \times 8

题目给出本次循环所取元素的地址为 2100H 2100H ,因此可以列出方程:2000H+x×8=2100H 2000H + x \times 8 = 2100H

将十六进制转换为十进制计算:2000H=819210 2000H = 8192_{10} ,2100H=844810, 2100H = 8448_{10}

代入方程:
8192+8x=8448 8192 + 8x = 8448
8x=8448−8192 8x = 8448 - 8192
8x=256 8x = 256
x=2568 x = \frac{256}{8}
x=32 x = 32

因此,进入该次循环时变址寄存器的内容是 32 32 。

正确答案:B

进入练习

第 19 题

计算机组成原理
2 分

减法指令“sub R1, R2, R3”的功能为“(R1) – (R2)→R3”,该指令执行后将生成进位/借位标志CF和溢出标志OF。若(R1)=FFFF FFFFH,(R2)=FFFF FFF0H,则该减法指令执行后,CF 与OF 分别为( )。

A. CF = 0, OF = 0

B. CF=1,OF = 0

C. CF = 0,OF = 1

D. CF = 1,OF = 1

查看答案与解析收起答案与解析

参考答案:A

题目详解:
首先,我们需要理解减法指令的执行过程以及CF(进位/借位标志)和OF(溢出标志)的定义。

  1. 减法操作:

    • 指令“sub R1, R2, R3”的功能是 (R1)−(R2)→R3 (R1) - (R2) \rightarrow R3 。
    • 给定的寄存器值为:
      • (R1)=FFFF FFFFH=232−1 (R1) = \text{FFFF FFFFH} = 2^{32} - 1
      • (R2)=FFFF FFF0H=232−16 (R2) = \text{FFFF FFF0H} = 2^{32} - 16
    • 计算差值:
      • (R1)−(R2)=(232−1)−(232−16)=15 (R1) - (R2) = (2^{32} - 1) - (2^{32} - 16) = 15
      • 结果 R3=15 R3 = 15 ,即 0000 000FH \text{0000 000FH} 。
  2. CF(进位/借位标志):

    • CF 在减法中表示借位。如果被减数小于减数,则 CF=1 CF = 1 ,否则 CF=0 CF = 0 。
    • 这里 (R1)=FFFF FFFFH (R1) = \text{FFFF FFFFH} 和 (R2)=FFFF FFF0H (R2) = \text{FFFF FFF0H} ,显然 (R1)>(R2) (R1) > (R2) ,因此 CF=0 CF = 0 。
  3. OF(溢出标志):

    • OF 表示有符号数的溢出。对于减法 a−b a - b ,OF 的计算公式为:
      • OF=(an∧¬bn∧¬rn)∨(¬an∧bn∧rn) OF = (a_{n} \land \neg b_{n} \land \neg r_{n}) \lor (\neg a_{n} \land b_{n} \land r_{n})
      • 其中 an a_{n} 、bn b_{n} 和 rn r_{n} 分别是 a a 、b b 和结果 r r 的最高位(符号位)。
    • 将 (R1) (R1) 和 (R2) (R2) 视为有符号数:
      • (R1)=FFFF FFFFH (R1) = \text{FFFF FFFFH} 是 −1-1(符号位为1)。
      • (R2)=FFFF FFF0H (R2) = \text{FFFF FFF0H} 是 −16-16(符号位为1)。
      • 结果 R3=15 R3 = 15 是 +15+15(符号位为0)。
    • 计算OF:
      • an=1 a_{n} = 1 ,bn=1 b_{n} = 1 ,rn=0 r_{n} = 0 。
      • OF=(1∧¬1∧¬0)∨(¬1∧1∧0)=(1∧0∧1)∨(0∧1∧0)=0∨0=0 OF = (1 \land \neg 1 \land \neg 0) \lor (\neg 1 \land 1 \land 0) = (1 \land 0 \land 1) \lor (0 \land 1 \land 0) = 0 \lor 0 = 0 。

综上,CF=0 CF = 0 且 OF=0 OF = 0 。

正确答案:A

进入练习

第 20 题

计算机组成原理
2 分

若某计算机最复杂指令的执行需要完成 5 个子功能,分别由功能部件A~E 实现,各功能部件所需时间分别为 80ps、50ps、50ps、70ps 和 50ps,采用流水线方式执行指令,流水段寄存器延时为20ps,则CPU 时钟周期至少为( )。

A. 60ps

B. 70ps

C. 80ps

D. 100ps

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在流水线设计中,CPU 时钟周期的确定需要满足以下条件:时钟周期必须不小于所有流水段中最慢的那个段的总时间(包括功能部件时间和流水段寄存器延时)。具体步骤如下:

  1. 首先计算每个功能部件加上流水段寄存器延时的总时间:

    • 部件A:80 ps+20 ps=100 ps 80\,\text{ps} + 20\,\text{ps} = 100\,\text{ps}
    • 部件B:50 ps+20 ps=70 ps 50\,\text{ps} + 20\,\text{ps} = 70\,\text{ps}
    • 部件C:50 ps+20 ps=70 ps 50\,\text{ps} + 20\,\text{ps} = 70\,\text{ps}
    • 部件D:70 ps+20 ps=90 ps 70\,\text{ps} + 20\,\text{ps} = 90\,\text{ps}
    • 部件E:50 ps+20 ps=70 ps 50\,\text{ps} + 20\,\text{ps} = 70\,\text{ps}
  2. 找出所有段中的最大值:

    • 最大值是 100 ps 100\,\text{ps} (来自部件A)。
  3. 因此,CPU 时钟周期至少为 100 ps 100\,\text{ps} 。

正确答案:D

进入练习

第 21 题

计算机组成原理
2 分

下列选项中,可提高同步总线数据传输率的是( )。

I. 增加总线宽度

II. 提高总线工作频率

IV. 采用地址/数据线复用

III. 支持突发传输

A. 仅I、II

B. 仅I、II、III

C. 仅III、IV

D. I、II、III 和IV

查看答案与解析收起答案与解析

参考答案:B

题目详解:
同步总线数据传输率的提升可以通过以下几种方式实现:

  1. 增加总线宽度(I):总线宽度增加意味着每次传输可以携带更多数据。数据传输率 R R 可以表示为 R=总线宽度×总线频率 R = \text{总线宽度} \times \text{总线频率} 。因此,增加总线宽度可以直接提高数据传输率。

  2. 提高总线工作频率(II):总线工作频率的提高会缩短每个时钟周期的时间,从而在单位时间内完成更多数据传输。数据传输率 R R 与总线频率成正比。

  3. 支持突发传输(III):突发传输允许在一次地址周期后连续传输多个数据,减少了地址传输的开销,从而有效提高了数据传输率。

  4. 采用地址/数据线复用(IV):这种方式虽然可以减少总线引脚数量,但需要通过分时复用传输地址和数据,增加了控制复杂度,且可能降低数据传输率,因此不会直接提高数据传输率。

综上所述,能够提高同步总线数据传输率的选项是 I、II、III。

正确答案:B

进入练习

第 22 题

计算机组成原理
2 分

下列关于外部I/O 中断的叙述中,正确的是( )。

A. 中断控制器按所接收中断请求的先后次序进行中断优先级排队

B. CPU 响应中断时,通过执行中断隐指令完成通用寄存器的保护

C. CPU 只有在处于中断允许状态时,才能响应外部设备的中断请求

D. 有中断请求时,CPU 立即暂停当前指令执行,转去执行中断服务程序

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在计算机系统中,外部I/O 中断的处理涉及多个关键机制,下面逐项分析:

选项A:中断控制器通常根据预先设定的中断优先级(如固定优先级或可编程优先级)来决定响应顺序,而不是简单地按照请求的先后次序。例如,IRQ0 IRQ_0 可能比 IRQ1 IRQ_1 具有更高的固定优先级。因此该选项错误。

选项B:CPU 响应中断时,中断隐指令负责完成程序计数器(PC PC )和程序状态字(PSW PSW )的保护,而通用寄存器的保护是由中断服务程序通过压栈指令(如 PUSH PUSH )完成的。因此该选项错误。

选项C:CPU 通过中断允许触发器(如 IF IF 标志位)控制中断响应。只有当 IF=1 IF = 1 (中断允许状态)时,CPU 才会响应可屏蔽中断请求。这是正确的叙述。

选项D:CPU 仅在当前指令执行结束后才会检查中断请求(除非是异常或不可屏蔽中断)。现代流水线架构中,还可能等待流水线排空。立即暂停当前指令的说法不准确,因此该选项错误。

正确答案:C

进入练习

第 23 题

操作系统
2 分

下列关于多任务操作系统的叙述,正确的是( )。

I. 具有并发和并行的特点

II. 需要实现对共享资源的保护

III. 需要运行在多CPU 的硬件平台上

A. 仅 I

B. 仅II

C. 仅I、II

D. I、II、III

查看答案与解析收起答案与解析

参考答案:C

题目详解:
多任务操作系统是指能够同时管理和执行多个任务的系统。其核心特点和相关需求分析如下:

  1. 并发和并行(I):

    • 并发:指系统通过任务切换在单个 CPU CPU 上交替执行多个任务,宏观上表现为“同时运行”。
    • 并行:指在多 CPU CPU 硬件上真正同时执行多个任务。多任务操作系统通常支持并发,若硬件支持多 CPU CPU ,则可实现并行。因此,I 正确。
  2. 共享资源保护(II):

    • 多任务环境下,多个任务可能访问同一资源(如内存、文件),需通过同步机制(如信号量、锁)避免冲突,确保数据一致性。因此,II 正确。
  3. 多 CPU CPU 硬件需求(III):

    • 多任务操作系统可在单 CPU CPU 或多 CPU CPU 平台上运行。多 CPU CPU 能提升并行能力,但非必需条件。因此,III 错误。

综上,仅 I 和 II 正确。

正确答案:C

进入练习

第 24 题

操作系统
2 分

某系统采用基于优先权的非抢占式进程调度策略,完成一次进程调度和进程切换的系统时间开销为 1μs。在T 时刻就绪队列中有 3 个进程 P1P1 、P2P2 和 P3P3 ,其在就绪队列中的等待时间、需要的CPU时间和优先权如下表所示。

进程 等待时间 需要的 CPU 时间 优先级
P1 30us 12us 10
P2 15us 24us 30
P3 18us 36us 20

若优先权值大的进程优先获得CPU,从T 时刻起系统开始进程调度,系统的平均周转时间为( )。

A. 54μs

B. 73μs

C. 74μs

D. 75μs

查看答案与解析收起答案与解析

参考答案:D

题目详解:
本题考察非抢占式优先级调度,由优先权可知,进程的执行顺序为 P2 → P3 → P1。

P2 的周转时间:1 +15+24= 40μs

P3 的周转时间:18+1+24+1 +36= 80μs

P1 的周转时间:30+1+24 +1 +36+1 +12=105μs

平均周转时间: (40+80+105) /3= 225/3= 75μs, 故选 D。

正确答案:D

进入练习

第 25 题

操作系统
2 分

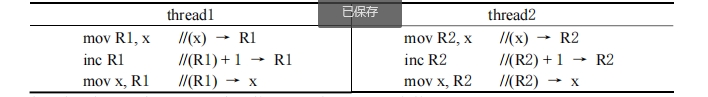
属于同一进程的两个线程thread1和thread2 并发执行,共享初值为 0 的全局变量x。thread1和thread2 实现对全局变量x 加 1 的机器级代码描述如下。

2018-25

在所有可能的指令执行序列中,使x 的值为 2 的序列个数是( )。

A. 1

B. 2

C. 3

D. 4

查看答案与解析收起答案与解析

参考答案:B

题目详解:
仔细阅读两个线程代码可知,threadl 和 thread2 均是对 x 进行加 1 操作,x 初始值为 0,若要使得最终 x = 2,只有先执行 thread1 再执行 thread2,或先执行 thread2 再执行 threadl,故只有 2 种可能,选 B。

进入练习

第 26 题

操作系统
2 分

假设系统中有 4 个同类资源,进程P1 , P2 和P3 需要的资源数分别为 4, 3和 1,P1 , P2 和P3 已申请到的资源数分别为 2, 1 和 0,则执行安全性检测算法的结果是( )。

A. 不存在安全序列,系统处于不安全状态

B. 存在多个安全序列,系统处于安全状态

C. 存在唯一安全序列P1 , P2 , P3 ,系统处于安全状态

D. 存在唯一安全序列P1 , P2 , P3,系统处于安全状态

查看答案与解析收起答案与解析

参考答案:A

题目详解:
首先,我们整理题目中的已知信息:

  1. 总资源数: 4 4
  2. 进程资源需求:
    • P1 P_1 需要 4 4 个资源,已分配 2 2 个,还需求 4−2=2 4 - 2 = 2 个。
    • P2 P_2 需要 3 3 个资源,已分配 1 1 个,还需求 3−1=2 3 - 1 = 2 个。
    • P3 P_3 需要 1 1 个资源,已分配 0 0 个,还需求 1−0=1 1 - 0 = 1 个。
  3. 已分配资源总数: 2(P1)+1(P2)+0(P3)=3 2 (P_1) + 1 (P_2) + 0 (P_3) = 3 个。
  4. 可用资源数: 4−3=1 4 - 3 = 1 个。

接下来,我们尝试找到一个安全序列:

  • 第一步:检查当前可用资源 1 1 是否能满足某个进程的需求:
    • P3 P_3 需要 1 1 个资源,可以满足。假设执行 P3 P_3 ,释放 1 1 个资源,此时可用资源变为 1+1=2 1 + 1 = 2 个。
  • 第二步:检查剩余进程 P1 P_1 和 P2 P_2 的需求:
    • P1 P_1 需要 2 2 个资源,P2 P_2 需要 2 2 个资源。当前可用资源 2 2 只能满足其中一个进程的需求,但无论选择哪个,另一个进程的需求都无法满足。

因此,系统无法找到一个安全序列,导致系统处于不安全状态。

正确答案:A

进入练习

第 27 题

操作系统
2 分

下列选项中,可能导致当前进程P 阻塞的事件是( )。

I. 进程P 申请临界资源

II. 进程P 从磁盘读数据

III. 系统将CPU 分配给高优先权的进程

A. 仅 I

B. 仅II

C. 仅I、II

D. I、II、III

查看答案与解析收起答案与解析

参考答案:C

题目详解:
进程阻塞是指进程在等待某个事件发生时,暂时无法继续执行,此时操作系统会将其状态从运行态改为阻塞态,并分配CPU给其他进程。下面分析每个选项:

I. 进程P 申请临界资源:
当进程P 申请临界资源时,如果该资源已被其他进程占用,则P 会被阻塞,直到资源可用。因此,I 会导致进程P 阻塞。

II. 进程P 从磁盘读数据:
磁盘I/O 操作速度较慢,当进程P 从磁盘读数据时,需要等待数据传输完成,此时P 会被阻塞。因此,II 会导致进程P 阻塞。

III. 系统将CPU 分配给高优先权的进程:
这是由操作系统调度决定的抢占行为,进程P 会从运行态转为就绪态,而非阻塞态。因此,III 不会导致进程P 阻塞。

综上所述,仅 I 和 II 会导致进程P 阻塞。

正确答案:C

进入练习

第 28 题

操作系统
2 分

若x 是管程内的条件变量,则当进程执行x.wait()时所做的工作是( )。

A. 实现对变量x 的互斥访问

B. 唤醒一个在x 上阻塞的进程

C. 根据x 的值判断该进程是否进入阻塞状态 D. 阻塞该进程,并将之插入x 的阻塞队列中

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在管程中,条件变量 x x 用于进程间的同步。当进程执行 x.wait() x.wait() 操作时,会进行以下步骤:

  1. 该进程会释放管程的互斥锁,允许其他进程进入管程。
  2. 该进程会被阻塞,并插入到条件变量 x x 的阻塞队列中等待。
  3. 进程会一直处于阻塞状态,直到其他进程执行 x.signal() x.signal() 操作将其唤醒。

选项分析:

  • A 错误:x.wait() x.wait() 并不直接实现对变量 x x 的互斥访问,互斥访问是由管程的互斥锁保证的。
  • B 错误:唤醒操作是通过 x.signal() x.signal() 实现的,而不是 x.wait() x.wait() 。
  • C 错误:x.wait() x.wait() 不会根据 x x 的值判断是否阻塞,而是直接阻塞进程。
  • D 正确:x.wait() x.wait() 会阻塞当前进程,并将其插入 x x 的阻塞队列中。

正确答案:D

进入练习

第 29 题

操作系统
2 分

当定时器产生时钟中断后,由时钟中断服务程序更新的部分内容是( )。

I. 内核中时钟变量的值

II. 当前进程占用CPU 的时间

III. 当前进程在时间片内的剩余执行时间

A. 仅I、II

B. 仅II、III

C. 仅I、III

D. I、II、III

查看答案与解析收起答案与解析

参考答案:D

题目详解:
当定时器产生时钟中断后,时钟中断服务程序会更新以下内容:

  1. 内核中时钟变量的值(I):时钟中断服务程序会维护内核中的时钟变量,例如 jiffies 或 ticks,用于记录系统启动以来的时钟中断次数。每次中断发生时,该值会递增。公式上可以表示为: jiffies=jiffies+1 jiffies = jiffies + 1 。

  2. 当前进程占用CPU 的时间(II):时钟中断服务程序会更新当前进程的CPU时间统计信息,例如 task_struct 中的 utime 或 stime 字段。每次中断发生时,当前进程的时间会计量增加一个时间单位,例如: utime=utime+Δt utime = utime + \Delta t 。

  3. 当前进程在时间片内的剩余执行时间(III):时钟中断服务程序会检查当前进程的时间片剩余量(例如 task_struct 中的 time_slice 字段),并递减其值: time_slice=time_slice−1 time\_slice = time\_slice - 1 。如果时间片用完,则会触发调度。

因此,I、II、III 三项内容都会被时钟中断服务程序更新。

正确答案:D

进入练习

第 30 题

操作系统
2 分

系统总是访问磁盘的某个磁道而不响应对其他磁道的访问请求,这种现象称为磁臂黏着。下列磁盘调度算法中,不会导致磁臂黏着的是( )。

A. 先来先服务(FCFS)

C. 扫描算法(SCAN)

B. 最短寻道时间优先(SSTF)

D. 循环扫描算法(CSCAN)

查看答案与解析收起答案与解析

参考答案:A

题目详解:
磁臂黏着是指磁盘调度算法在某些情况下导致磁头长时间停留在某个磁道附近,无法响应其他磁道的访问请求。分析各选项的算法特性:

  1. 先来先服务(FCFS):
    按照请求到达的顺序依次处理,磁头移动无规律,不会优先处理某个磁道的请求,因此 不会导致磁臂黏着。

  2. 最短寻道时间优先(SSTF):
    优先处理距离当前磁头位置最近的请求。若某个磁道频繁有请求,磁头会反复停留在该磁道附近, 可能导致磁臂黏着。

  3. 扫描算法(SCAN):
    磁头按固定方向移动,处理路径上的请求,到达磁盘一端后反向移动。若某个磁道频繁有请求且位于移动路径上, 可能导致磁臂黏着。

  4. 循环扫描算法(CSCAN):
    类似SCAN,但磁头到达一端后立即返回起点。若某个磁道频繁有请求且位于移动路径上, 可能导致磁臂黏着。

综上,FCFS是唯一不会导致磁臂黏着的算法。

正确答案:A

进入练习

第 31 题

操作系统
2 分

下列优化方法中,可以提高文件访问速度的是( )。

I. 提前读

II. 为文件分配连续的簇

I V. 采用磁盘高速缓存

III. 延迟写

A. 仅I、II

B. 仅II、III

C. 仅I、III、IV

D. I、II、III、IV

查看答案与解析收起答案与解析

参考答案:D

题目详解:
文件访问速度的优化可以通过多种方法实现,题目中提到的四种方法分别如下:

  1. 提前读(I):在读取当前数据块时,预先将后续可能需要的块读入缓存。这利用了程序的局部性原理,减少了后续访问的等待时间。公式表示为:Taccess=Tseek+Trotation+Ttransfer T_{access} = T_{seek} + T_{rotation} + T_{transfer} ,通过提前读可以减少 Tseek T_{seek} 和 Trotation T_{rotation} 的开销。

  2. 为文件分配连续的簇(II):文件存储在连续的磁盘簇上时,磁头移动距离减少,从而降低寻道时间 Tseek T_{seek} 。连续分配的文件访问时间可以表示为:Tcontiguous=Tseek_initial+n×Ttransfer T_{contiguous} = T_{seek\_initial} + n \times T_{transfer} ,而非连续分配时还需加上额外的寻道时间。

  3. 采用磁盘高速缓存(IV):将频繁访问的数据缓存在高速内存中,直接从内存读取数据比从磁盘读取快得多。缓存命中率 H H 对平均访问时间的影响为:Tavg=H×Tcache+(1−H)×Tdisk T_{avg} = H \times T_{cache} + (1-H) \times T_{disk} 。

  4. 延迟写(III):将写操作暂存于缓存中,待系统空闲时再写入磁盘。这减少了用户等待时间,并通过批量写入优化磁盘 I/O 效率。延迟写的响应时间为:Tresponse=Tcache_write T_{response} = T_{cache\_write} ,而非实时写入的 Tresponse=Tdisk_write T_{response} = T_{disk\_write} 。

综上所述,四种方法均能提高文件访问速度,因此正确答案是 D。

正确答案:D

进入练习

第 32 题

操作系统
2 分

下列同步机制中,可以实现让权等待的是( )。

A. Peterson 方法

B. swap 指令

C. 信号量方法

D. TestAndSet 指令

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在操作系统中,同步机制用于协调多个进程或线程对共享资源的访问。题目中提到的"让权等待"(也称为"忙等待避免")是指当进程无法获取所需资源时,会主动释放CPU并进入阻塞状态,而不是持续占用CPU进行忙等待。下面分析各选项:

A. Peterson 方法:这是一种软件实现的同步算法,适用于两个进程。它通过共享变量 flag[2] flag[2] 和 turn turn 来实现互斥,但进程在等待时会持续检查条件(忙等待),不满足让权等待的要求。

B. swap 指令:这是一种硬件实现的同步原语,通过原子性地交换内存和寄存器的值来实现互斥。但它在等待时同样会陷入忙等待循环(例如 while(swap(&lock, 1) == 1);),不释放CPU。

C. 信号量方法:信号量通过 P() P() (wait)和 V() V() (signal)操作管理资源。当进程执行 P() P() 发现信号量 S≤0 S \leq 0 时,会被阻塞并加入等待队列,此时CPU可调度其他进程,完美符合让权等待的特性。

D. TestAndSet 指令:这是另一种硬件同步原语,通过原子性地测试并设置内存值实现互斥。但它的典型实现方式也是忙等待(例如 while(TestAndSet(&lock);),不会主动让出CPU。

因此,只有 信号量方法 在无法获取资源时会将进程阻塞,实现真正的让权等待。

正确答案:C

进入练习

第 33 题

计算机网络
2 分

下列TCP/IP 应用层协议中,可以使用传输层无连接服务的是( )。

A. FTP

B. DNS

C. SMTP

D. HTTP

查看答案与解析收起答案与解析

参考答案:B

题目详解:
在TCP/IP协议栈中,应用层协议可以选择使用传输层的两种服务:面向连接的TCP服务或无连接的UDP服务。题目要求找出可以使用传输层无连接服务(即UDP)的应用层协议。我们逐一分析选项:

  1. FTP (A选项):文件传输协议,需要可靠的数据传输,因此使用面向连接的TCP服务(默认端口21),不支持UDP。

  2. DNS (B选项):域名系统,通常使用UDP协议(端口53)进行域名解析查询,因为UDP的无连接特性适合快速的小数据包传输。虽然DNS也可以使用TCP,但主要场景仍是无连接的UDP。

  3. SMTP (C选项):简单邮件传输协议,依赖TCP(端口25)确保邮件可靠传输,不支持UDP。

  4. HTTP (D选项):超文本传输协议,基于TCP(端口80/443)保证数据完整性,不支持UDP。

因此,只有 DNS 是主要依赖无连接服务的协议。

正确答案:B

进入练习

第 34 题

计算机网络
2 分

下列选项中,不属于物理层接口规范定义范畴的是( )。

A. 接口形状

B. 引脚功能

C. 物理地址

D. 信号电平

查看答案与解析收起答案与解析

参考答案:C

题目详解:
物理层接口规范主要定义了与物理介质连接相关的机械、电气、功能和规程特性。具体包括:

  1. 机械特性:涉及接口的物理结构,如 接口形状 接口形状 、尺寸、引脚排列等(对应选项 A A )。

  2. 电气特性:规定信号的 信号电平 信号电平 、阻抗、传输速率等电气参数(对应选项 D D )。

  3. 功能特性:定义各 引脚功能 引脚功能 ,如数据线、控制线、地线等(对应选项 B B )。

  4. 规程特性:描述接口的操作时序或流程。

物理地址 物理地址 (如MAC地址)是数据链路层的概念,用于标识网络中的设备,不属于物理层接口规范的范畴(对应选项 C C )。

正确答案:C

进入练习

第 35 题

计算机网络
2 分

IEEE 802.11 无线局域网的MAC 协议CSMA/CA 进行信道预约的方法是( )。

A. 发送确认帧

B. 采用二进制指数退避

C. 使用多个MAC 地址

D. 交换RTS 与CTS 帧

查看答案与解析收起答案与解析

参考答案:D

题目详解:
IEEE 802.11 无线局域网使用的MAC协议是CSMA/CA(载波监听多路访问/冲突避免)。为了减少隐藏终端问题带来的冲突,CSMA/CA采用了信道预约机制,具体方法是通过交换 RTS RTS (Request to Send)和 CTS CTS (Clear to Send)帧来实现。

具体过程如下:

  1. 发送方首先向接收方发送一个 RTS RTS 帧,请求发送数据。
  2. 接收方收到 RTS RTS 后,如果信道空闲,会回复一个 CTS CTS 帧作为响应。
  3. 周围的节点监听到 RTS RTS 或 CTS CTS 帧后,会在一段时间内避免发送数据,从而为当前通信预留信道。

其他选项分析:

  • A. 发送确认帧(ACK)用于确认数据帧的正确接收,但不是信道预约的方法。
  • B. 二进制指数退避用于冲突后的重传延迟计算,与信道预约无关。
  • C. 使用多个MAC地址与信道预约无关。

正确答案:D

进入练习

第 36 题

计算机网络
2 分

主机甲采用停–等协议向主机乙发送数据,数据传输速率是 3kbps,单向传播延时是 200ms,忽略确认帧的传输延时。当信道利用率等于 40%时,数据帧的长度为( )。

A. 240 比特

B. 400 比特

C. 480 比特

D. 800 比特

查看答案与解析收起答案与解析

参考答案:D

题目详解:
信道利用率= 传输帧的有效时间/传输帧的周期。假设帧的长度为 x 比特。对于有效时间,应该用帧的大小除以数据传输速率,即 x/3kbps。对于帧的传输周期,应包含 4 个部分:帧在发送端的发送时延、帧从发送端到接收端的单程传播时延、确认帧在接收端的发送时延、确认帧从接收端到发送端的单程传播时延。这 4 个时延中,由于题目中说“忽略确认帧的传输延时”,因此不计算确认帧的发送时延(注意传输时延和传播时延的区别,传输时延也称发送时延,和传播时延只有一字之差)。所以帧的传输周期由三部分组成:首先是帧在发送端的发送时延 x/3kbps,其次是帧从发送端到接收端的单程传播时延 200ms,最后是确认帧从接收端到发送端的单程传播时延 200ms,三者相加可得其周期应为 x/3kbps + 400ms。代入信道利用率的公式,求出 x = 800bit。答案选 D。

正确答案:D

进入练习

第 37 题

计算机网络
2 分

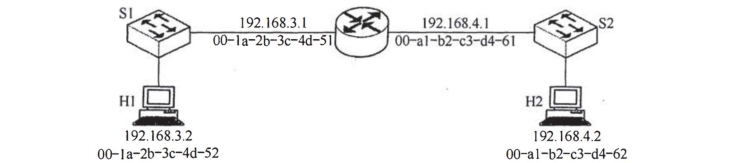
路由器R 通过以太网交换机S1和S2 连接两个网络,R 的接口、主机H1和H2的IP 地址与MAC 地址如下图所示。若H1向H2发送1个IP 分组P,则H1 发出的封装P 的以太网帧的目的MAC 地址、H2 收到的封装P 的以太网帧的源MAC 地址分别是( )。

2018-37

A. 00-a1-b2-c3-d4-62, 00-1a-2b-3c-4d-52

B. 00-a1-b2-c3-d4-62, 00-a1-b2-c3-d4-61

C. 00-1a-2b-3c-4d-51, 00-1a-2b-3c-4d-52

D. 00-1a-2b-3c-4d-51, 00-a1-b2-c3-d4-61

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在网络的信息传递中,会经常用到两个地址:MAC 地址和 IP 地址。其中,MAC 地址会随着信息被发往不同的网络而改变,但 IP 地址当且仅当信息在私人网络中传递时才会改变。分组 P 在如题图所示的网络中传递时,首先由主机 H1 将分组发往路由器 R,此时源 MAC 地址为 1 主机本身的 MAC 地址,即 00-1a-2b-3c-4d-52,目的 MAC 地址 为路由器 R 的 MAC 地址,即 00-1a-2b-3c-4d-51。当路由器 R 收到分组 P 后,根据分组 P 的目的 IP 地址,得知应将分组从另一个端口转发出去,于是会给分组 P 更换新的 MAC 地址,此时由于从另外的端口转发出去,因此 P 的新源 MAC 地址变为负责转发的端口 MAC 地址,即 00-a1-b2-c3-d4-61, 目的 MAC 地址应为主机 H2 的 MAC 地址,即 00-a1-b2-c3-d4-62。根据分析过程,题目所问的 MAC 地址应为路由器 R 两个端口的 MAC 地址,故选 D。

正确答案:D

进入练习

第 38 题

计算机网络
2 分

某路由表中有转发接口相同的 4 条路由表项,其目的网络地址分别为 35.230.32.0/21,35.230.40.0/21,35.230.48.0/21 和 35.230.56.0/21,将该 4 条路由聚合后的目的网络地址为( )。

A. 35.230.0.0/19

B. 35.230.0.0/20

C. 35.230.32.0/19

D. 35.230.32.0/20

查看答案与解析收起答案与解析

参考答案:C

题目详解:
首先,我们需要将给定的 4 个网络地址转换为二进制形式,以便找到它们的共同前缀:

  1. 35.230.32.0/21 35.230.32.0/21 的二进制形式:

    • 35.230.32.0 的二进制:00100011.11100110.00100000.00000000 00100011.11100110.00100000.00000000
    • 前 21 位:00100011.11100110.00100 00100011.11100110.00100
  2. 35.230.40.0/21 35.230.40.0/21 的二进制形式:

    • 35.230.40.0 的二进制:00100011.11100110.00101000.00000000 00100011.11100110.00101000.00000000
    • 前 21 位:00100011.11100110.00101 00100011.11100110.00101
  3. 35.230.48.0/21 35.230.48.0/21 的二进制形式:

    • 35.230.48.0 的二进制:00100011.11100110.00110000.00000000 00100011.11100110.00110000.00000000
    • 前 21 位:00100011.11100110.00110 00100011.11100110.00110
  4. 35.230.56.0/21 35.230.56.0/21 的二进制形式:

    • 35.230.56.0 的二进制:00100011.11100110.00111000.00000000 00100011.11100110.00111000.00000000
    • 前 21 位:00100011.11100110.00111 00100011.11100110.00111

接下来,我们需要找到这些地址的最长共同前缀。观察前 21 位,可以发现前 19 位是相同的:

00100011.11100110.001 00100011.11100110.001

因此,聚合后的网络地址的前缀长度为 19 位。将前 19 位转换为十进制:

  • 前 19 位:00100011.11100110.001 00100011.11100110.001
  • 对应的十进制:35.230.32.0 35.230.32.0

所以,聚合后的网络地址是 35.230.32.0/19 35.230.32.0/19 。

正确答案:C

进入练习

第 39 题

计算机网络
2 分

UDP 协议实现分用(demultiplexing)时所依据的头部字段是( )。

A. 源端口号

B. 目的端口号

C. 长度

D. 校验和

查看答案与解析收起答案与解析

参考答案:B

题目详解:
UDP 协议实现分用(demultiplexing)时,需要通过头部字段来确定将接收到的数据报交付给哪个应用进程。分用的关键依据是 UDP 头部中的 目的端口号 目的端口号 字段,因为该字段标识了目标应用程序所监听的端口号。以下是 UDP 头部的主要字段及其作用:

  1. 源端口号 源端口号 :标识发送方的端口号,主要用于回复数据时使用,但不是分用的依据。
  2. 目的端口号 目的端口号 :标识接收方的端口号,是分用的核心依据,接收方根据该字段将数据报交给对应的应用进程。
  3. 长度 长度 :表示 UDP 数据报的总长度(包括头部和数据),与分用无关。
  4. 校验和 校验和 :用于检测数据传输中的错误,与分用无关。

因此,UDP 协议实现分用时,依据的头部字段是 目的端口号 目的端口号 。

正确答案:B

进入练习

第 40 题

计算机网络
2 分

无须转换即可由SMTP 协议直接传输的内容是( )。

A. JPEG 图像

B. MPEG 视频

C. EXE 文件

D. ASCII 文本

查看答案与解析收起答案与解析

参考答案:D

题目详解:
SMTP(Simple Mail Transfer Protocol)是一种用于发送电子邮件的协议,它最初设计用于传输7位的 ASCII ASCII 文本。SMTP 协议在传输过程中默认只能处理 ASCII ASCII 字符,不支持直接传输二进制数据(如 JPEG JPEG 图像、MPEG MPEG 视频或 EXE EXE 文件)。如果需要在电子邮件中传输非 ASCII ASCII 内容(如二进制文件),必须通过编码方式(如 Base64 Base64 )将其转换为 ASCII ASCII 文本格式。

选项分析:

  • A. JPEG JPEG 图像:二进制文件,需要编码后才能传输。
  • B. MPEG MPEG 视频:二进制文件,需要编码后才能传输。
  • C. EXE EXE 文件:二进制文件,需要编码后才能传输。
  • D. ASCII ASCII 文本:SMTP 协议原生支持,可直接传输。

因此,正确答案是 D。

进入练习

综合应用题

7 题 · 共 80 分

第 41 题

数据结构
15 分

(13 分)给定一个含n(n≥1)个整数的数组,请设计一个在时间上尽可能高效的算法,找出数组中未出现的最小正整数。例如,数组{-5, 3, 2, 3}中未出现的最小正整数是 1;数组{1, 2, 3}中未出现的最小正整数是 4。要求:

(1)给出算法的基本设计思想。

(2)根据设计思想,采用C 或C++语言描述算法,关键之处给出注释。

(3)说明你所设计算法的时间复杂度和空间复杂度。

查看答案与解析收起答案与解析

题目详解:
1)题目要求算法时间上尽可能高效,因此采用空间换时间的办法。分配一个用于标记的数组 B[n]B[n],用来记录 AA 中是否出现了 1∼n1 \sim n 中的正整数,B[0]B[0] 对应正整数 11,B[n−1]B[n-1] 对应正整数 nn,初始化 BB 中全部为 00。由于 AA 中含有 nn 个整数,因此可能返回的值是 1∼n+11 \sim n+1,当 AA 中 nn 个数恰好为 1∼n1 \sim n 时返回 n+1n+1。当数组 AA 中出现了小于等于 00 或大于 nn 的值时,会导致 1∼n1 \sim n 中出现空余位置,返回结果必然在 1∼n1 \sim n 中,因此对于 AA 中出现了小于等于 00 或大于 nn 的值可以不采取任何操作。

经过以上分析可以得出算法流程:从 A[0]A[0] 开始遍历 AA,若 0<A[i]≤n0 < A[i] \le n,则令 B[A[i]−1]=1B[A[i]-1]=1;否则不进行操作。对 AA 遍历结束后,开始遍历数组 BB,若能查找到第一个满足 B[i]=0B[i]=0 的下标 ii,返回 i+1i+1 即为结果,此时说明 AA 中未出现的最小正整数在 1∼n1 \sim n 之间。若 B[i]B[i] 全部不为 00,返回 i+1i+1(跳出循环时 i=ni=n,i+1i+1 等于 n+1n+1),此时说明 AA 中未出现的最小正整数是 n+1n+1。

2)算法实现

c 复制代码
int findMissMin(int a[], int n) {
  // 来记录 1 ~ n 是否出现过
  int vis[n];
  for (int i = 0; i < n; i++) {
    vis[i] = 0;
  }
  // 在 vis 数组中记录哪些正整数出现过
  for (int i = 0; i < n; i++) {
    int num = a[i];
    if (num > 0 && num <= n) {
      vis[num-1] = 1;
    }
  }
  // 遍历 vis 来找到最小消失的正整数
  for (int i = 0; i < n; i++) {
    if (vis[i] == 0) {
      return i+1;
    }
  }
  return n+1;
}

3)时间复杂度:遍历 AA 一次,遍历 BB 一次,两次循环内操作步骤为 O(1)O(1) 量级,因此时间复杂度为 O(n)O(n)。空间复杂度:额外分配了 B[n]B[n],空间复杂度为 O(n)O(n)。

进入练习

第 42 题

数据结构
15 分

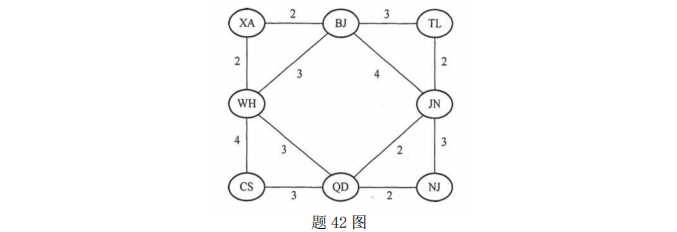
(12 分)拟建设一个光通信骨干网络连通BJ、CS、XA、QD、JN、NJ、TL 和WH 等8个城市,题 42 图中无向边上的权值表示两个城市间备选光纤的铺设费用。

2018-42

请回答下列问题。

(1)仅从铺设费用角度出发,给出所有可能的最经济的光纤铺设方案(用带权图表示),并计算相应方案的总费用。

(2)题 42 图可采用图的哪种存储结构?给出求解问题(1)所使用的算法名称。

(3)假设每个城市采用一个路由器按(1)中得到的最经济方案组网,主机HI 直接连接在TL的路由器上,主机H2 直接连接在BJ 的路由器上。若H1向H2 发送一个TTL=5的IP 分组,则H2 是否可以收到该IP 分组?

查看答案与解析收起答案与解析

题目详解:
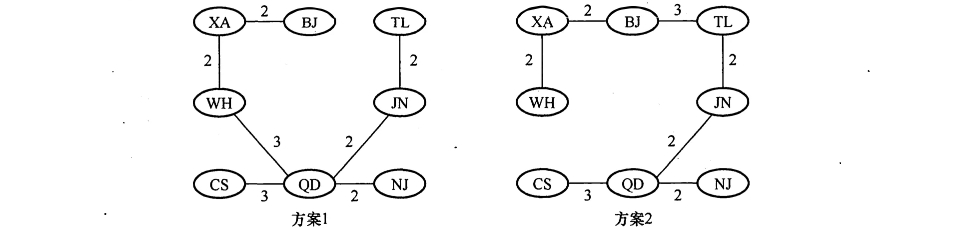
1)为了求解最经济的方案,可以把问题抽象为求无向带权图的最小生成树。可以采用手动 Prim 算法或 Kruskal 算法作图。注意本题最小生成树有两种构造,如下图所示。

image

方案的总费用为 16。

2)存储题中的图可以采用邻接矩阵(或邻接表)。构造最小生成树采用 Prim 算法(或 Kruskal 算法)。

3)TTL= 5,即 IP 分组的生存时间(最大传递距离)为 5,方案 1 中 TL 和 BJ 的距离过远,TTL = 5 不足以让 IP 分组从 H1 传送到 H2,因此 H2 不能收到 IP 分组。而方案 2 中 TL 和 BJ 邻近,H2 可以收到 IP 分组。

进入练习

第 43 题

计算机组成原理
11 分

(8 分)假定计算机的主频为 500MHz,CPI 为 4。现有设备A 和B,其数据传输率分别为2MB/s 和 40MB/s,对应I/O 接口中各有一个 32 位数据缓冲寄存器。请回答下列问题,要求给出计算过程。

(1)若设备A 采用定时查询I/O 方式,每次输入/输出都至少执行 10 条指令。设备A 最多间隔多长时间查询一次才能不丢失数据?CPU 用于设备A 输入/输出的时间占CPU 总时间的百分比至少是多少?

(2)在中断I/O 方式下,若每次中断响应和中断处理的总时钟周期数至少为 400,则设备B 能否采用中断I/O 方式?为什么?

(3)若设备B 采用DMA 方式,每次DMA 传送的数据块大小为 1000B,CPU 用于DMA 预处理和后处理的总时钟周期数为 500,则CPU 用于设备B 输入/输出的时间占CPU 总时间的百分比最多是多少?

查看答案与解析收起答案与解析

题目详解:
1)程序定时向缓存端口查询数据,由于缓存端口大小有限,必须在传输完端口大小的数据时访问端口,以防止部分数据未被及时读取而丢失。设备 A 准备 32 位数据所用的时间为 4B/2MB=2μs4B/2MB=2\mu s,所以最多每隔 2μs2\mu s 必须查询一次,每秒的查询次数至少是 1s/2μs=5×1051s / 2\mu s = 5 \times 10^5,每秒 CPU 用于设备 A 输入/输出的时间至少为 5×105×10×4=2×1075 \times 10^5 \times 10 \times 4 = 2 \times 10^7 个时钟周期,占整个 CPU 时间的百分比至少是 2×10⁷/500M=4%2 \times 10^7 / 500M = 4\%。

2)中断响应和中断处理的时间为 400×(1/500M)=0.8μs400 \times (1/500M) = 0.8\mu s,这时只需判断设备 B 准备 32 位数据要多久,如果准备数据的时间小于中断响应和中断处理的时间,那么数据就会被刷新,造成丢失。经过计算,设备 B 准备 32 位数据所用的时间为 4B/40MB=0.1μs4B/40MB = 0.1\mu s,因此设备 B 不适合采用中断 I/O 方式。

3)在 DMA 方式中,只有预处理和后处理需要 CPU 处理,数据的传送过程是由 DMA 控制的。设备 B 每秒的 DMA 次数最多为 40MB/1000B=4000040MB/1000B = 40000,CPU 用于设备 B 输入/输出的时间最多为 40000×500=2×10740000 \times 500 = 2 \times 10^7 个时钟周期,占 CPU 总时间的百分比最多为 2×10⁷/500M=4%2 \times 10^7 / 500M = 4\%。

进入练习

第 44 题

计算机组成原理
14 分

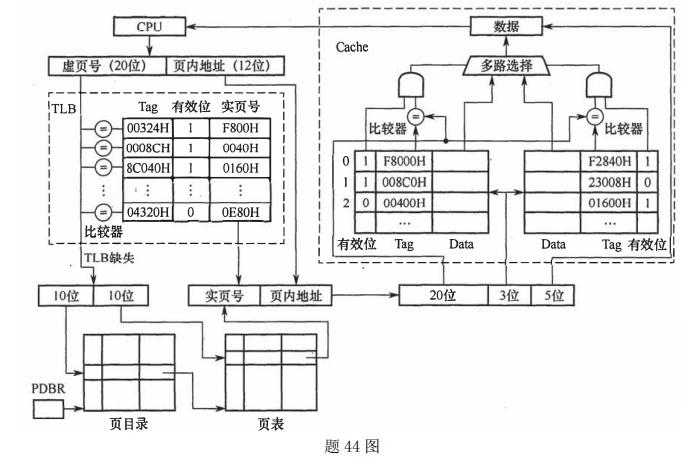
(15 分)某计算机采用页式虚拟存储管理方式,按字节编址。CPU 进行存储访问的过程如题 44图所示。根据题 44 图回答下列问题。

2018-44

(1)主存物理地址占多少位?

(2)TLB 采用什么映射方式?TLB 是用SRAM 还是用DRAM 实现?

(3)Cache 采用什么映射方式?若Cache 采用LRU 替换算法和回写(Write Back)策略,则Cache 每行中除数据(Data)、Tag 和有效位外,还应有哪些附加位?Cache 的总容量是多少?Cache 中有效位的作用是什么?

(4)若CPU 给出的虚拟地址为 0008C040H,则对应的物理地址是多少?是否在Cache 中命中?说明理由。若CPU 给出的虚拟地址为 0007C260H,则该地址所在主存块映射到的Cache 组号是多少?

查看答案与解析收起答案与解析

题目详解:
1)物理地址由实页号和页内地址拼接,因此其位数为 16+12=2816+12=28 或直接可得 20+3+5=2820+3+5=28。

2)TLB采用全相联映射,可以把页表内容调入任一块空 TLB 项中,TLB 中每项都有一个比较器,没有映射规则,只要空闲就行。TLB 采用静态存储器 SRAM,读写速度快,但成本高,多用于容量较小的高速缓冲存储器。

3)从图中可以看到,Cache 中每组有两行,故采用 2 路组相联映射。因为是 2 路组相联并采用 LRU 替换算法,所以每行(或每组)需要 1 位 LRU 位;因为采用回写策略,所以每行有 1 位修改位(脏位),根据脏位判断数据是否被更新,若脏位为 1 则需要写回内存。

28 位物理地址中 Tag 字段占 20 位,组索引字段占 3 位,块内偏移地址占 5 位,故 Cache 共有 23=82^{3} = 8 组,每组 2 行,每行有 25=322^{5}=32 B,故 Cache 总容量为 8×2×(20+1+1+32×8)=44648 \times 2 \times (20 + 1 + 1 + 32 \times 8) = 4464 位 =558= 558 字节。

Cache 中有效位用来指出所在 Cache 行中的信息是否有效。

4)虚拟地址分为两部分:虚页号、页内地址;物理地址分为两部分:实页号、页内地址。利用虚拟地址的虚页号部分去查找 TLB 表(缺失时从页表调入),将实页号取出后和虚拟地址的页内地址拼接,就形成了物理地址。虚页号 008CH 恰好在 TLB 表中对应实页号 0040H(有效位为 1,说明存在),虚拟地址的后 3 位为页内地址 040H,则对应的物理地址是 0040040H。

物理地址为 0040040H,其中高 20 位 00400H 为标志字段,低 5 位 00000B 为块内偏移量,中间 3 位 010B 为组号 2,因此将 00400H 与 Cache 中的第 2 组两行中的标志字段同时比较,可以看出,虽然有一个 Cache 行中的标志字段与 00400H 相等,但对应的有效位为 0,而另一 Cache 行的标志字段与 00400H 不相等,故访问 Cache 不命中。

因为物理地址的低 12 位与虚拟地址低 12 位相同,即为 001001100000B。根据物理地址的结构,物理地址的后八位 01100000B 的前三位 011B 是组号,因此该地址所在的主存映射到 Cache 的组号为 3。

进入练习

第 45 题

操作系统
8 分

(8 分)请根据题 44 图给出的虚拟存储管理方式,回答下列问题。

(1)某虚拟地址对应的页目录号为 6,在相应的页表中对应的页号为 6,页内偏移量为 8,该虚拟地址的十六进制表示是什么?

(2)寄存器PDBR 用于保存当前进程的页目录起始地址,该地址是物理地址还是虚拟地址?进程切换时,PDBR 的内容是否会变化?说明理由。同一进程的线程切换时,PDBR 的内容是否会变化?说明理由。

(3)为了支持改进型CLOCK 置换算法,需要在页表项中设置哪些字段?

查看答案与解析收起答案与解析

题目详解:
1)由图可知,地址总长度为 32 位,高 20 位为虚页号,低 12 位为页内地址,且虚页号高 10 位为页目录号,低 10 位为页号。十六进制表示为 01806008H01806008H。

2)PDBR 为页目录基址地址寄存器(Page-Directory Base Register),其存储页目录表物理内存基地址。进程切换时,PDBR 的内容会变化;同一进程的线程切换时,PDBR 的内容不会变化。每个进程的地址空间、页目录和 PDBR 的内容存在一一对应的关系。进程切换时,地址空间发生了变化,对应的页目录及其起始地址也相应变化,因此需要用进程切换后当前进程的页目录起始地址刷新 PDBR。同一进程中的线程共享该进程的地址空间,其线程发生切换时,地址空间不变,线程使用的页目录不变,因此 PDBR 的内容也不变。

3)改进型 Clock 置换算法需要用到使用位和修改位,故需要设置访问字段(使用位)和修改字段(脏位)。

进入练习

第 46 题

操作系统
8 分

(7 分)某文件系统采用索引节点存放文件的属性和地址信息,簇大小为 4KB。每个文件索引节点占 64B,有 11 个地址项,其中直接地址项 8 个,一级、二级和三级间接地址项各 1 个,每个地址项长度为 4B。请回答下列问题。

(1)该文件系统能支持的最大文件长度是多少?(给出计算表达式即可。)

(2)文件系统用 1M(1M = 220)个簇存放文件索引节点,用 512M 个簇存放文件数据。若一个图像文件的大小为 5600B,则该文件系统最多能存放多少个图像文件?

(3)若文件F1 的大小为 6KB,文件F2 的大小为 40KB,则该文系统获取F1和F2 最后一个簇的簇号需要的时间是否相同?为什么?

查看答案与解析收起答案与解析

题目详解:
1)簇大小为 4KB,每个地址项长度为 4B,故每簇有 4KB/4B=10244KB/4B = 1024 个地址项。最大文件的物理块数可达 8+1×1024+1×10242+1×102438 + 1 \times 1024 + 1 \times 1024^{2} + 1 \times 1024^{3},每个物理块(簇)大小为 4KB,故最大文件长度为 (8+1×1024+1×10242+1×10243)×4KB=32KB+4MB+4GB+4TB(8 + 1 \times 1024 + 1 \times 1024^{2} + 1 \times 1024^{3}) \times 4KB = 32KB + 4MB + 4GB + 4TB。

2)文件索引节点总个数为 1M×4KB/64B=64M1M \times 4KB / 64B = 64M,5600B 的文件占 2 个簇,512M 个簇可存放的文件总个数为 512M/2=256M512M / 2 = 256M。可表示的文件总个数受限于文件索引节点总个数,故能存储 64M 个大小为 5600B 的图像文件。

3)文件 F1 的大小为 6KB<4KB×8=32KB6KB \lt 4KB \times 8 = 32KB,故获取文件 F1 的最后一个簇的簇号只需要访问索引节点的直接地址项。文件 F2 的大小为 40KB,4KB×8<40KB<4KB×8+4KB×10244KB \times 8 \lt 40KB \lt 4KB \times 8 + 4KB \times 1024,故获取 F2 的最后一个簇的簇号还需要读一级索引表。综上,需要的时间不相同。

进入练习

第 47 题

计算机网络
9 分

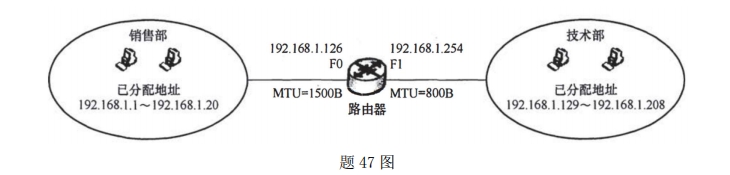
(7 分)某公司的网络如题 47 图所示。IP 地址空间 192.168.1.0/24 被均分给销售部和技术部两个子网,并已分别为部分主机和路由器接口分配了IP 地址,销售部子网的MTU = 1500B,技术部子网的MTU = 800B。请回答下列问题。

2018-47

(1)销售部子网的广播地址是什么?技术部子网的子网地址是什么?若每个主机仅分配一个IP地址,则技术部子网还可以连接多少台主机?

(2)假设主机 192.168.1.1 向主机 192.168.1.208 发送一个总长度为 1500B 的IP 分组,IP 分组的头部长度为 20B,路由器在通过接口F1 转发该IP 分组时进行了分片。若分片时尽可能分为最大片,则一个最大IP 分片封装数据的字节数是多少?至少需要分为几个分片?每个分片的片偏移量是多少?

查看答案与解析收起答案与解析

题目详解:
1)广播地址是网络地址中主机号全 1 的地址(主机号全 0 的地址代表网络本身)。销售部和技术部均分配了 192.168.1.0/24 的 IP 地址空间,IP 地址的前 24 位为子网的网络号。于是在后 8 位中划分部门的子网,选择前 1 位作为部门子网的网络号。令销售部子网的网络号为 0,技术部子网的网络号为 1,则技术部子网的完整地址为 192.168.1.128;令销售部子网的主机号全 1,可以得到该部门的广播地址为 192.168.1.127。

每个主机仅分配一个 IP 地址,计算目前还可以分配的主机数,用技术部可以分配的主机数减去已分配的主机数,技术部总共可以分配给计算机的主机数为 27−2=1262^7 - 2 = 126(减去全 0 和全 1 的主机号)。已经分配了 208−129+1=80208 - 129 + 1 = 80 个,此外还有 1 个 IP 地址分配给了路由器的端口(192.168.1.254),因此还可以分配 126−80−1=45126 - 80 - 1 = 45 台。

2)判断分片的大小,需要考虑各个网段的 MTU,而且注意分片的数据长度必须是 8B 的整数倍。由题可知,在技术部子网内,MTU = 800B,IP 分组头部长 20B,最大 IP 分片封装数据的字节数为 ⌊(800−20)/8⌋×8=776\lfloor (800 - 20) / 8 \rfloor \times 8 = 776。至少需要的分片数为 ⌈(1500−20)/776⌉=2\lceil (1500 - 20) / 776 \rceil = 2。第 1 个分片的偏移量为 0;第 2 个分片的偏移量为 776/8=97776 / 8 = 97。

进入练习