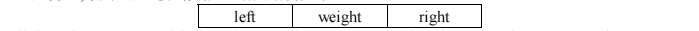2014计算机学科专业基础综合全卷预览

2014年408真题

2014年408真题完整试卷,包含 40 道选择题和 7 道综合应用题,共 47 题,题目分值合计 153 分。可按目录阅读全卷,展开参考答案解析,或进入对应题目练习。

返回年度练习
47题全卷题目
153分题目分值合计
40题选择题 · 80分
7题综合应用题 · 73分

选择题

40 题 · 共 80 分

第 1 题

数据结构
2 分

下列程序段的时间复杂度是( )。

复制代码
count=0;
for (k=1; k<=n;k\*=2)
	for (j=1; j<=n; j++)
		count++;

A. O(log2n)

B. O(n)

C. O(nlog2n)

D. O(n2)

查看答案与解析收起答案与解析

参考答案:C

题目详解:
这段程序的时间复杂度分析如下:

  1. 外层循环:for (k=1; k<=n; k*=2)

    • 变量 k k 每次乘以 2 2 ,直到 k k 超过 n n 。
    • 循环次数为 log⁡2n \log_2 n 次。
  2. 内层循环:for (j=1; j<=n; j++)

    • 变量 j j 从 1 1 到 n n ,每次递增 1 1 。
    • 循环次数为 n n 次。
  3. 总时间复杂度:

    • 由于内层循环在外层循环的每次迭代中都会执行,因此总的时间复杂度是两者的乘积。
    • 即 O(log⁡2n×n)=O(nlog⁡2n) O(\log_2 n \times n) = O(n \log_2 n) 。

正确答案:C

进入练习

第 2 题

数据结构
2 分

假设栈初始为空,将中缀表达式a/b+(c*d-e*f)/g 转换为等价的后缀表达式的过程中,当扫描到 f 时,栈中的元素依次是( )。

A. + ( * -

B. + ( - *

C. / + ( * - *

D. / + - *

查看答案与解析收起答案与解析

参考答案:B

题目详解:
要将中缀表达式 a/b+(c∗d-e∗f)/g a/b+(c*d-e*f)/g 转换为后缀表达式,我们需要使用栈来跟踪运算符。转换过程遵循以下规则:

  1. 从左到右扫描中缀表达式。
  2. 遇到操作数(如 a,b,c a, b, c 等)直接输出。
  3. 遇到运算符时,将其与栈顶运算符比较优先级:
    • 如果栈为空或栈顶是 ( ( ,直接入栈。
    • 如果当前运算符优先级高于栈顶运算符,直接入栈。
    • 否则,弹出栈顶运算符并输出,直到满足上述条件后再入栈。
  4. 遇到 ( ( 直接入栈,遇到 ) ) 则弹出栈内运算符直到 ( ( 并弹出 ( ( 。
  5. 表达式扫描完毕后,弹出栈内所有运算符。

具体步骤到扫描到 f f 时的栈状态如下:

  1. 扫描 a :输出 a ,栈:[\ ] 。
  2. 扫描 / :栈为空,入栈,栈:[/] 。
  3. 扫描 b :输出 b ,栈:[/] 。
  4. 扫描 + :+ 优先级低于 / ,弹出 / 并输出,入栈 + ,栈:[+] 。
  5. 扫描 ( :直接入栈,栈:[+, (] 。
  6. 扫描 c :输出 c ,栈:[+, (] 。
  7. 扫描 * :栈顶是 ( ,直接入栈,栈:[+, (, *] 。
  8. 扫描 d :输出 d ,栈:[+, (, *] 。
  9. 扫描 - :- 优先级低于 * ,弹出 * 并输出,入栈 - ,栈:[+, (, -] 。
  10. 扫描 e :输出 e ,栈:[+, (, -] 。
  11. 扫描 * :* 优先级高于 - ,直接入栈,栈:[+, (, -, *] 。
  12. 扫描 f :输出 f ,栈:[+, (, -, *] 。

此时栈中的元素依次是 +,(,-,∗ +, (, -, * ,对应选项 B 。

正确答案:B

进入练习

第 3 题

数据结构
2 分

循环队列放在一维数组A[0…M-1]中,end1 指向队头元素,end2 指向队尾元素的后一个位置。假设队列两端均可进行入队和出队操作,队列中最多能容纳M-1 个元素。初始时为空。下列判断队空和队满的条件中,正确的是( )。

A. 队空:end1== end2; 队满:end1== (end2+ 1) mod M

B. 队空:end1== end2; 队满:end2== (end1+ 1) mod (M-1)

C. 队空:end2== (end1+ 1) mod M; 队满:end1== (end2+ 1) mod M

D. 队空:end1== (end2+ 1) mod M; 队满:end2== (end1+ 1) mod (M-1)

查看答案与解析收起答案与解析

参考答案:A

题目详解:
循环队列是一种线性数据结构,使用一维数组 A[0…M−1] A[0 \ldots M-1] 实现。队列的两端(队头和队尾)都可以进行入队和出队操作。队列中最多能容纳 M−1 M-1 个元素,这是为了区分队空和队满的条件。

  1. 队空条件:当队列为空时,队头指针 end1 end1 和队尾指针 end2 end2 指向同一个位置。因此,队空的条件为:

    end1==end2end1 == end2

  2. 队满条件:当队列满时,队尾指针 end2 end2 的下一个位置是队头指针 end1 end1 。由于是循环队列,需要使用模运算 mod  M \mod M 来计算下一个位置。因此,队满的条件为:

    end1==(end2+1)mod  Mend1 == (end2 + 1) \mod M

选项分析:

  • A:队空条件 end1==end2 end1 == end2 和队满条件 end1==(end2+1)mod  M end1 == (end2 + 1) \mod M 完全符合上述分析。
  • B:队满条件错误地使用了 mod  (M−1) \mod (M-1) ,这是不正确的。
  • C:队空条件错误地使用了 end2==(end1+1)mod  M end2 == (end1 + 1) \mod M ,这是队满的条件。
  • D:队空和队满条件均错误。
进入练习

第 4 题

数据结构
2 分

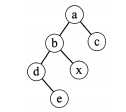
若对如下的二叉树进行中序线索化,则结点x 的左、右线索指向的结点分别是( )。

2014-4

A. e、c

B. e、a

C. d、c

D. b、a

查看答案与解析收起答案与解析

参考答案:D

题目详解:
线索二叉树的线索实际上指向的是相应遍历序列特定结点的前驱结点和后继结点,所以先写出二叉树的中序遍历序列 debxac, 中序遍历中在 x 左边和右边的字符,就是它在中序线索化的左、右线索,即 b、a, 选 D。

正确答案:D

进入练习

第 5 题

数据结构
2 分

将森林F 转换为对应的二叉树T,F 中叶结点的个数等于( )。

A. T 中叶结点的个数

B. T 中度为 1 的结点个数

C. T 中左孩子指针为空的结点个数

D. T 中右孩子指针为空的结点个数

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在将森林 F F 转换为对应的二叉树 T T 时,转换规则如下:

  1. 森林中的每个树转换为二叉树时,树的根结点作为二叉树的根结点,且根结点的右子树为空。
  2. 树中某结点的第一个子结点(最左子结点)作为该结点在二叉树中的左孩子。
  3. 树中某结点的兄弟结点(右侧相邻的兄弟)作为该结点在二叉树中的右孩子。

根据这些规则,可以得出以下结论:

  • 森林 F F 中的叶结点在二叉树 T T 中表现为 左孩子指针为空 的结点。因为叶结点没有子结点,所以其左孩子指针必然为空。
  • 森林 F F 中非叶结点的其他情况(如度为 1 或度为 2 的结点)在二叉树 T T 中可能表现为左孩子或右孩子不为空。

因此,森林 F F 中叶结点的个数等于二叉树 T T 中 左孩子指针为空 的结点个数。

正确答案:C

进入练习

第 6 题

数据结构
2 分

5 个字符有如下 4 种编码方案,不是前缀编码的是( )。

A. 01, 0000, 0001, 001, 1

B. 011, 000, 001, 010, 1

C. 000, 001, 010, 011, 100

D. 0, 100, 110, 1110, 1100

查看答案与解析收起答案与解析

参考答案:D

题目详解:
前缀编码是指任何一个字符的编码都不是另一个字符编码的前缀。我们需要检查每个选项是否存在某个编码是另一个编码的前缀。

选项A:01,0000,0001,001,1 01, 0000, 0001, 001, 1

  • 检查所有编码两两之间:01 01 不是其他编码的前缀,0000 0000 和 0001 0001 的前缀是 001 001 的前缀 00 00 ,但 00 00 本身不是编码,001 001 不是其他编码的前缀,1 1 不是其他编码的前缀。
  • 因此,选项A是前缀编码。

选项B:011,000,001,010,1 011, 000, 001, 010, 1

  • 检查所有编码两两之间:011 011 的前缀 01 01 不是其他编码,000 000 的前缀 00 00 不是其他编码,001 001 的前缀 00 00 不是其他编码,010 010 的前缀 01 01 不是其他编码,1 1 不是其他编码的前缀。
  • 因此,选项B是前缀编码。

选项C:000,001,010,011,100 000, 001, 010, 011, 100

  • 检查所有编码两两之间:所有编码长度相同,不可能互为前缀。
  • 因此,选项C是前缀编码。

选项D:0,100,110,1110,1100 0, 100, 110, 1110, 1100

  • 检查所有编码两两之间:110 110 是 1100 1100 的前缀。
  • 因此,选项D不是前缀编码。

正确答案:D

进入练习

第 7 题

数据结构
2 分

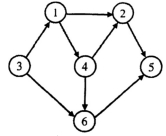
对如下所示的有向图进行拓扑排序,得到的拓扑序列可能是( )。

2014-7

A. 3, 1, 2, 4, 5, 6

B. 3, 1, 2, 4, 6, 5

C. 3, 1, 4, 2, 5, 6

D. 3, 1, 4, 2, 6, 5

查看答案与解析收起答案与解析

参考答案:D

题目详解:
按照拓扑排的算法,每次都选择入度为 0 的结点从图中删去,此图中一开始只有结点 3 的入度为 0;删掉结点 3 后,只有结点 1 的入度为 0; 删掉结点 1 后,只有结点 4 的入度为 0;删掉结点 4 后,结点 2 和结点 6 的入度都为 0,此时选择删去不同的结点,会得出不同的拓扑序列,分别处理完毕后可知可能的拓扑序列为 3,1 4,2,6,5 和 3,1,4,6,2,5, 选 D。

正确答案:D

进入练习

第 8 题

数据结构
2 分

用哈希(散列)方法处理冲突(碰撞)时可能出现堆积(聚集)现象。下列选项中,会受堆积现象直接影响的是( )。

A. 存储效率

B. 散列函数

C. 装填(装载)因子

D. 平均查找长度

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在哈希表中,堆积(聚集)现象是指不同的关键字通过散列函数映射到同一个地址时,为了解决冲突而形成较长的探测序列。这种现象会直接影响哈希表的查找性能,具体表现为:

  1. 平均查找长度(ASL):堆积会导致冲突的关键字在探测序列中分布不均匀,使得查找时需要更多的探测次数,从而增加平均查找长度。ASL的计算公式为:

    ASL=1n∑i=1nCi ASL = \frac{1}{n} \sum_{i=1}^{n} C_i

    其中,n n 是关键字数量,Ci C_i 是查找第 i i 个关键字所需的探测次数。

  2. 其他选项分析:

    • A. 存储效率:存储效率主要与哈希表的空间利用率有关,堆积现象不会直接影响存储效率。
    • B. 散列函数:散列函数的设计影响冲突的概率,但堆积现象是冲突处理的结果,不会直接影响散列函数本身。
    • C. 装填因子:装填因子 α=nm \alpha = \frac{n}{m} (n n 为关键字数量,m m 为哈希表长度)是哈希表满程度的度量,堆积现象不会直接影响装填因子。

因此,堆积现象会直接影响 平均查找长度(D)。

正确答案:D

进入练习

第 9 题

数据结构
2 分

在一棵具有 15 个关键字的 4 阶B 树中,含关键字的结点个数最多是( )。

A. 5

B. 6

C. 10

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在4阶B树中,每个结点最多可以包含 3 3 个关键字(因为阶数为 m m 的B树,每个结点最多有 m−1 m-1 个关键字)。为了最大化含关键字的结点个数,我们需要让每个结点包含尽可能少的关键字。在4阶B树中,每个非根结点至少需要包含 ⌈m/2⌉−1=1 \lceil m/2 \rceil - 1 = 1 个关键字(根结点最少可以包含 1 1 个关键字)。

为了使含关键字的结点个数最多,我们假设每个结点只包含 1 1 个关键字。那么,15个关键字需要分布在 15 15 个结点中。然而,B树的结构要求关键字按一定规则分布,因此我们需要考虑B树的层级关系。

  1. 根结点包含 1 1 个关键字,此时剩余 14 14 个关键字。
  2. 第二层可以有 2 2 个结点(因为根结点的 1 1 个关键字可以分出 2 2 个子树),每个结点包含 1 1 个关键字,此时剩余 12 12 个关键字。
  3. 第三层可以有 4 4 个结点(第二层的 2 2 个结点各分出 2 2 个子树),每个结点包含 1 1 个关键字,此时剩余 8 8 个关键字。
  4. 第四层可以有 8 8 个结点(第三层的 4 4 个结点各分出 2 2 个子树),每个结点包含 1 1 个关键字,此时剩余 0 0 个关键字。

总结:总共有 1 1 (根)+2 + 2 (第二层)+4 + 4 (第三层)+8 + 8 (第四层)=15 = 15 个结点,每个结点包含 1 1 个关键字,正好分配完 15 15 个关键字。因此,含关键字的结点个数最多是 15 15 。

正确答案:D

进入练习

第 10 题

数据结构
2 分

用希尔排序方法对一个数据序列进行排序时,若第 1 趟排序结果为 9, 1, 4, 13, 7, 8, 20, 23, 15,则该趟排序采用的增量(间隔)可能是( )。

A. 2

B. 3

C. 4

D. 5

查看答案与解析收起答案与解析

参考答案:B

题目详解:
首先,第二个元素为 1,是整个序列中的最小元素,所以可知该希尔排序为从小到大排序然后考虑增量问题,若增量为 2,第 1+2 个元素 4 明显比第 1 个元素 9 要大,A 排除;若增量为 3,第 i、i+3、i+6 个元素都为有序序列 (i=1,2,3),符合希尔排序的定义;若增量为 4,第 1 个元素 9 比第 1+4 个元素 7 要大,C 排除;若增量为 5,第 1 个元素 9 比第 1+5 个元素 8 要大,D 排除,选 B。

正确答案:B

进入练习

第 11 题

数据结构
2 分

下列选项中,不可能是快速排序第 2 趟排序结果的是( )。

A. 2, 3, 5, 4, 6, 7, 9

B. 2, 7, 5, 6, 4, 3, 9

C. 3, 2, 5, 4, 7, 6, 9

D. 4, 2, 3, 5, 7, 6, 9

查看答案与解析收起答案与解析

参考答案:C

题目详解:
快速排序每一趟排序后,会确定一个基准元素的最终位置,且基准左边的元素都小于基准,右边的元素都大于基准。我们需要检查每个选项是否符合快速排序第 2 趟排序后的特征。

  1. 选项 A:2, 3, 5, 4, 6, 7, 9

    • 第一趟可能以 5 5 为基准,得到 2,3,4,5,6,7,9 2, 3, 4, 5, 6, 7, 9 。
    • 第二趟对左右子序列分别处理,可能得到 2,3,5,4,6,7,9 2, 3, 5, 4, 6, 7, 9 。
    • 符合快速排序第 2 趟结果。
  2. 选项 B:2, 7, 5, 6, 4, 3, 9

    • 第一趟可能以 6 6 为基准,得到 2,5,4,3,6,7,9 2, 5, 4, 3, 6, 7, 9 。
    • 第二趟对左右子序列分别处理,可能得到 2,7,5,6,4,3,9 2, 7, 5, 6, 4, 3, 9 。
    • 符合快速排序第 2 趟结果。
  3. 选项 C:3, 2, 5, 4, 7, 6, 9

    • 第一趟可能以 4 4 为基准,得到 3,2,4,5,7,6,9 3, 2, 4, 5, 7, 6, 9 。
    • 第二趟对左右子序列分别处理,可能得到 2,3,4,5,6,7,9 2, 3, 4, 5, 6, 7, 9 ,但无法得到 3,2,5,4,7,6,9 3, 2, 5, 4, 7, 6, 9 。
    • 不符合快速排序第 2 趟结果。
  4. 选项 D:4, 2, 3, 5, 7, 6, 9

    • 第一趟可能以 5 5 为基准,得到 4,2,3,5,7,6,9 4, 2, 3, 5, 7, 6, 9 。
    • 第二趟对左右子序列分别处理,可能保持原序列。
    • 符合快速排序第 2 趟结果。

因此,选项 C 不可能是快速排序第 2 趟排序结果。

正确答案:C

进入练习

第 12 题

计算机组成原理
2 分

程序P 在机器M 上的执行时间是 20 秒,编译优化后,P 执行的指令数减少到原来的 70%,而CPI 增加到原来的 1.2 倍,则P 在M 上的执行时间是( )。

A. 8.4秒

B. 11.7秒

C. 14秒

D. 15

D. 16.8秒

查看答案与解析收起答案与解析

参考答案:D

题目详解:
程序执行时间的计算公式为:
执行时间=指令数×CPI×时钟周期时间 \text{执行时间} = \text{指令数} \times \text{CPI} \times \text{时钟周期时间}

设优化前的指令数为 I I ,CPI 为 C C ,时钟周期时间为 T T ,则优化前的执行时间为:
20=I×C×T 20 = I \times C \times T

优化后的指令数为原来的 70%,即 0.7I 0.7I ,CPI 增加到原来的 1.2 倍,即 1.2C 1.2C 。时钟周期时间 T T 不变。

因此,优化后的执行时间为:
执行时间新=0.7I×1.2C×T=0.84×(I×C×T)=0.84×20=16.8秒 \text{执行时间}_{\text{新}} = 0.7I \times 1.2C \times T = 0.84 \times (I \times C \times T) = 0.84 \times 20 = 16.8 \text{秒}

正确答案:D

进入练习

第 13 题

计算机组成原理
2 分

若x=103, y =-25, 则下列表达式采用 8 位定点补码运算实现时,会发生溢出的是( )。

A. x+y

B. -x+y

C. x-y

D. -x-y

查看答案与解析收起答案与解析

参考答案:C

题目详解:
首先,我们需要将 x=103 x = 103 和 y=−25 y = -25 转换为 8 位定点补码表示。

  1. 转换为补码:

    • x=103 x = 103 的二进制表示为 01100111 01100111 ,其补码与原码相同。
    • y=−25 y = -25 的原码为 10011001 10011001 ,补码为 11100111 11100111 (符号位不变,其余位取反加 1)。
  2. 8 位补码的表示范围:

    • 8 位补码可以表示的范围是 −128 -128 到 127 127 。
    • 任何运算结果超出此范围都会发生溢出。
  3. 逐项分析:

    • A. x+y x + y

      • 103+(−25)=78 103 + (-25) = 78 。
      • 78 78 在 −128 -128 到 127 127 范围内,不会溢出。
    • B. −x+y -x + y

      • −x -x 的补码是 x x 的补码取反加 1,即 10011001 10011001 。
      • −x+y=−103+(−25)=−128 -x + y = -103 + (-25) = -128 。
      • −128 -128 刚好在 8 位补码的表示范围内,不会溢出。
    • C. x−y x - y

      • x−y=103−(−25)=128 x - y = 103 - (-25) = 128 。
      • 128 128 超出了 8 位补码的正数最大值 127 127 ,会发生溢出。
    • D. −x−y -x - y

      • −x−y=−103−(−25)=−78 -x - y = -103 - (-25) = -78 。
      • −78 -78 在 −128 -128 到 127 127 范围内,不会溢出。

综上所述,只有选项 C 会发生溢出。

正确答案:C

进入练习

第 14 题

计算机组成原理
2 分

float 型数据常用IEEE754 单精度浮点格式表示。假设两个float 型变量x 和y 分别存放在 32 位寄存器f1 和f2 中,若(f1 )=CC90 0000H, (f2 )= B0C0 0000H, 则x 和y 之间的关系为( )。

A. x < y 且符号相同

B. x < y 且符号不同

C. x > y 且符号相同

D. x > y 且符号不同

查看答案与解析收起答案与解析

参考答案:A

题目详解:
首先,我们需要将给定的十六进制表示转换为IEEE 754单精度浮点数的二进制形式,然后解析出符号位、指数部分和尾数部分。

  1. 对于 f1=CC90 0000H f1 = \text{CC90 0000H} :

    • 二进制表示:1100 1100 1001 0000 0000 0000 0000 0000 1100\ 1100\ 1001\ 0000\ 0000\ 0000\ 0000\ 0000
    • 符号位 S S :1 1 (表示负数)
    • 指数部分 E E :100 1100 1 100\ 1100\ 1 (即 10011001 10011001 ,十进制为 153 153 )
    • 尾数部分 M M :001 0000 0000 0000 0000 0000 001\ 0000\ 0000\ 0000\ 0000\ 0000
    • 实际指数 e=E−127=153−127=26 e = E - 127 = 153 - 127 = 26
    • 浮点数 x=(−1)S×1.M×2e=−1.001×226≈−1.125×67,108,864≈−75,497,472 x = (-1)^S \times 1.M \times 2^e = -1.001 \times 2^{26} \approx -1.125 \times 67,108,864 \approx -75,497,472
  2. 对于 f2=B0C0 0000H f2 = \text{B0C0 0000H} :

    • 二进制表示:1011 0000 1100 0000 0000 0000 0000 0000 1011\ 0000\ 1100\ 0000\ 0000\ 0000\ 0000\ 0000
    • 符号位 S S :1 1 (表示负数)
    • 指数部分 E E :011 0000 1 011\ 0000\ 1 (即 01100001 01100001 ,十进制为 97 97 )
    • 尾数部分 M M :100 0000 0000 0000 0000 0000 100\ 0000\ 0000\ 0000\ 0000\ 0000
    • 实际指数 e=E−127=97−127=−30 e = E - 127 = 97 - 127 = -30
    • 浮点数 y=(−1)S×1.M×2e=−1.1×2−30≈−1.5×9.31×10−10≈−1.397×10⁻⁹ y = (-1)^S \times 1.M \times 2^e = -1.1 \times 2^{-30} \approx -1.5 \times 9.31 \times 10^{-10} \approx -1.397 \times 10^{-9}
  3. 比较 x x 和 y y :

    • 两者均为负数(符号相同)。
    • x≈−75,497,472 x \approx -75,497,472 ,y≈−1.397×10⁻⁹ y \approx -1.397 \times 10^{-9} ,显然 x<y x < y (负数绝对值越大,值越小)。

因此,正确答案是 x<y x < y 且符号相同。

正确答案:A

进入练习

第 15 题

计算机组成原理
2 分

某容量为 256MB 的存储器由若干 4Mx8位的DRAM 芯片构成,该DRAM 芯片的地址引脚和数据引脚总数是( )。

A. 19

B. 22

C. 30

D. 36

查看答案与解析收起答案与解析

参考答案:A

题目详解:
4Mx8 位的芯片数据线应为 8 根,地址线应为 log24M=22log_24M=22​ 根,而 DRAM 采用地址复用技术,地址线是原来的 1/2,且地址信号分行、列两次传送。地址线数为 22/2 = 11 根,所以地址引脚与数据引脚的总数为 11+ 8=19 根,选 A。

正确答案:A

进入练习

第 16 题

计算机组成原理
2 分

采用指令Cache 与数据Cache 分离的主要目的是( )。

A. 降低Cache 的缺失损失

B. 提高Cache 的命中率

C. 降低CPU 平均访存时间

D. 减少指令流水线资源冲突

查看答案与解析收起答案与解析

参考答案:D

题目详解:
采用指令Cache (I−CacheI-Cache) 与数据Cache (D−CacheD-Cache) 分离的主要目的是为了解决指令流水线中的资源冲突问题。具体分析如下:

  1. 资源冲突问题:在流水线执行过程中,CPU 需要同时访问指令和数据。如果使用统一的Cache,当指令和数据位于同一Cache 块时,会导致访存冲突(即结构冒险),从而阻塞流水线,降低效率。

  2. 分离Cache 的优势:

    • 通过将 I−CacheI-Cache 和 D−CacheD-Cache 分离,可以允许CPU 同时访问指令和数据,避免资源冲突。
    • 这种分离设计能够支持指令预取和数据加载/存储的并行操作,从而提升流水线的吞吐率。
  3. 其他选项分析:

    • A:降低Cache 缺失损失通常通过多级Cache 或预取技术实现,与分离设计无直接关系。
    • B:提高命中率更多依赖于Cache 容量、替换算法等,分离Cache 并不直接提升命中率。
    • C:降低平均访存时间是分离Cache 的间接效果,而非主要目的。

因此,分离 I−CacheI-Cache 和 D−CacheD-Cache 的核心目的是减少指令流水线的资源冲突(选项D)。

正确答案:D

进入练习

第 17 题

计算机组成原理
2 分

某计算机有 16 个通用寄存器,采用 32 位定长指令字,操作码字段(含寻址方式位)为 8 位,Store 指令的源操作数和目的操作数分别采用寄存器直接寻址和基址寻址方式。若基址寄存器可使用任一通用寄存器,且偏移量用补码表示,则Store 指令中偏移量的取值范围是( )。

A. -32768~+32767

B. -32767~+32768

C. -65536~+65535

D. -65535~+65536

查看答案与解析收起答案与解析

参考答案:A

题目详解:
首先,我们分析题目给出的信息:

  1. 计算机有 16 16 个通用寄存器,因此寄存器编号需要 log⁡216=4 \log_2{16} = 4 位表示。
  2. 指令字长度为 32 32 位,操作码字段(含寻址方式位)为 8 8 位。
  3. Store 指令的源操作数采用寄存器直接寻址,目的操作数采用基址寻址。
  4. 基址寄存器可使用任一通用寄存器,偏移量用补码表示。

接下来,我们计算偏移量字段的位数:

  • 指令总长度为 32 32 位。
  • 操作码字段占 8 8 位。
  • 源操作数是寄存器直接寻址,需要 4 4 位表示寄存器编号。
  • 目的操作数是基址寻址,需要 4 4 位表示基址寄存器编号。
  • 剩下的位数用于偏移量:32−8−4−4=16 32 - 8 - 4 - 4 = 16 位。

偏移量用补码表示,16 16 位补码的取值范围是 −215 -2^{15} 到 215−1 2^{15} - 1 ,即 −32768 -32768 到 +32767 +32767 。

因此,Store 指令中偏移量的取值范围是 −32768∼+32767 -32768 \sim +32767 。

正确答案:A

进入练习

第 18 题

计算机组成原理
2 分

某计算机采用微程序控制器,共有 32 条指令,公共的取指令微程序包含 2 条微指令,各指令对应的微程序平均由 4 条微指令组成,采用断定法(下地址字段法)确定下条微指令地址,则微指令中下地址字段的位数至少是( )。

A. 5

B. 6

C. 8

D. 9

查看答案与解析收起答案与解析

参考答案:C

题目详解:
微程序控制器中,微指令的下地址字段位数取决于微程序的总长度。具体计算步骤如下:

  1. 首先计算总的微指令条数:

    • 取指令微程序包含 2 2 条微指令。
    • 每条指令对应的微程序平均由 4 4 条微指令组成,共有 32 32 条指令,因此指令对应的微程序总长度为 32×4=128 32 \times 4 = 128 条微指令。
    • 因此,总的微指令条数为 2+128=130 2 + 128 = 130 条。
  2. 确定下地址字段的位数:

    • 采用断定法(下地址字段法)时,下地址字段需要能够表示所有微指令的地址。
    • 需要满足 2n≥130 2^n \geq 130 ,其中 n n 为下地址字段的位数。
    • 计算 27=128<130 2^7 = 128 < 130 ,28=256≥130 2^8 = 256 \geq 130 ,因此至少需要 8 8 位。

正确答案:C

进入练习

第 19 题

计算机组成原理
2 分

某同步总线采用数据线和地址线复用方式,其中地址/数据线有 32 根,总线时钟频率为 66MHz,每个时钟周期传送两次数据(上升沿和下降沿各传送一次数据),该总线的最大数据传输率(总线带宽)是( )。

A. 132MB/s

B. 264MB/s

C. 528MB/s

D. 1056MB/s

查看答案与解析收起答案与解析

参考答案:C

题目详解:
计算机共有 32 条指令,各个指令对应的微程序平均为 4 条,则指令对应的微指令为 32x4=128 条,而公共微指令还有 2 条,整个系统中微指令的条数一共为 128+ 2 = 130 条,所以需要 log2130=8log2130=8 位才能寻址到 130 条微指令,答案选 C。

正确答案:C

进入练习

第 20 题

计算机组成原理
2 分

一次总线事务中,主设备只需给出一个首地址,从设备就能从首地址开始的若干连续单元读出或写入多个数据。这种总线事务方式称为( )。

A. 并行传输

B. 串行传输

C. 突发传输

D. 同步传输

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在计算机总线事务中,题目描述的场景涉及一种高效的传输方式,具体分析如下:

  1. 关键特征:主设备仅提供起始地址,从设备能够连续读写多个数据单元。这种机制避免了每次传输都重复发送地址的开销。

  2. 传输方式对比:

    • 并行传输(A):同时通过多条线路传输多个比特,与地址连续性无关。
    • 串行传输(B):逐比特顺序传输,不涉及地址连续访问。
    • 突发传输(C):通过首地址+突发长度实现连续数据的批量传输,符合题目描述。
    • 同步传输(D):强调时钟信号协调传输时序,与地址模式无关。
  3. 数学表示:
    突发传输的地址生成可表示为:
    Addressn=BaseAddress+n×DataWidth Address_{n} = BaseAddress + n \times DataWidth
    其中 n n 为增量,DataWidth DataWidth 为数据单元大小。

  4. 效率优势:
    相比单次传输,突发传输的理论带宽利用率提升为:
    Efficiency=BurstLength1+AddressCyclesBurstLength Efficiency = \frac{BurstLength}{1 + \frac{AddressCycles}{BurstLength}}

正确答案:C

进入练习

第 21 题

计算机组成原理
2 分

下列有关I/O 接口的叙述中,错误的是( )。

A. 状态端口和控制端口可以合用同一个寄存器

B. I/O 接口中CPU 可访问的寄存器称为I/O 端口

C. 采用独立编址方式时,I/O 端口地址和主存地址可能相同

D. 采用统一编址方式时,CPU 不能用访存指令访问I/O 端口

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在计算机系统中,I/O 接口是连接CPU 和外部设备的桥梁。关于题目中的选项:

A. 状态端口和控制端口可以合用同一个寄存器:这是正确的。在某些设计中,状态信息和控制信号可以通过同一个寄存器进行双向传输,通过不同的位或访问模式来区分。

B. I/O 接口中CPU 可访问的寄存器称为I/O 端口:这是正确的。I/O 端口就是CPU 能够直接读写的接口寄存器,用于数据传输、状态查询或控制命令发送。

C. 采用独立编址方式时,I/O 端口地址和主存地址可能相同:这是正确的。独立编址(isolated I/O)方式下,I/O 地址空间和内存地址空间是分开的,相同的地址数值在不同地址空间中指向不同的物理设备,不会冲突。

D. 采用统一编址方式时,CPU 不能用访存指令访问I/O 端口:这是错误的。统一编址(memory-mapped I/O)方式的特点就是将I/O 端口映射到内存地址空间,CPU 正是通过访存指令(如 MOV \text{MOV} 、 LOAD \text{LOAD} / STORE \text{STORE} )来访问这些端口。

正确答案:D

进入练习

第 22 题

计算机组成原理
2 分

若某设备中断请求的响应和处理时间为 100ns,每 400ns 发出一次中断请求,中断响应所允许的最长延迟时间为 50ns,则在该设备持续工作过程中,CPU 用于该设备的I/O 时间占整个CPU 时间的百分比至少是( )。

A. 12.5%

B. 25%

C. 37.5%

D. 50%

查看答案与解析收起答案与解析

参考答案:B

题目详解:
根据题目描述,设备每 400ns 400ns 发出一次中断请求,中断请求的响应和处理时间为 100ns 100ns ,中断响应所允许的最长延迟时间为 50ns 50ns 。我们需要计算 CPU 用于该设备 I/O 时间的最小占比。

  1. 计算中断处理时间占比:

    • 每次中断请求的处理时间为 100ns 100ns 。
    • 中断请求的频率为每 400ns 400ns 一次。
    • 因此,CPU 用于中断处理的时间占比为:
      100ns400ns=25% \frac{100ns}{400ns} = 25\%
  2. 考虑中断延迟的影响:

    • 中断响应的最长延迟时间为 50ns 50ns ,但这部分时间已经包含在中断处理时间 100ns 100ns 中,因此不需要额外计算。
    • 题目问的是“至少”占比,因此直接采用中断处理时间占比即可。

综上,CPU 用于该设备 I/O 时间的最小占比为 25% 25\% 。

正确答案:B

进入练习

第 23 题

操作系统
2 分

下列调度算法中,不可能导致饥饿现象的是( )。

A. 时间片轮转

B. 静态优先数调度

C. 非抢占式短作业优先

D. 抢占式短作业优先

查看答案与解析收起答案与解析

参考答案:A

题目详解:
饥饿现象是指某些进程或作业在调度过程中长期得不到资源,无法执行的情况。我们需要分析每个选项的调度算法是否可能导致饥饿:

A. 时间片轮转(RR):每个进程被分配一个固定的时间片 Δt \Delta t ,在一个时间片用完后会被强制切换到下一个进程。这种调度方式保证了所有进程都能在有限时间内获得CPU资源,因此不会导致饥饿。

B. 静态优先数调度:进程的优先级是固定的,高优先级的进程总是优先执行。如果一直有高优先级进程到达,低优先级进程可能永远得不到执行,从而导致饥饿。

C. 非抢占式短作业优先(SJF):短作业优先调度会选择预计执行时间最短的作业运行,且不允许抢占。如果一直有更短的作业到达,长作业可能永远无法执行,从而导致饥饿。

D. 抢占式短作业优先(SJF抢占式):虽然允许抢占,但仍偏向短作业。如果系统不断有更短的作业到达,长作业可能被无限推迟,同样会导致饥饿。

综上所述,只有 时间片轮转 算法能够避免饥饿现象。

正确答案:A

进入练习

第 24 题

操作系统
2 分

某系统有n 台互斥使用的同类设备,三个并发进程分别需要 3、4、5 台设备,可确保系统不发生死锁的设备数n 最小为( )。

A. 9

B. 10

C. 11

D. 12

查看答案与解析收起答案与解析

参考答案:B

题目详解:
要确保系统不发生死锁,需要满足资源分配的最小需求。根据银行家算法,避免死锁的最小资源数可以通过以下公式计算:

n≥∑i=1k(maxi−1)+1 n \geq \sum_{i=1}^{k} (max_i - 1) + 1

其中,k k 是进程的数量,maxi max_i 是第 i i 个进程需要的最大资源数。

本题中有三个进程,分别需要 3 3 、4 4 和 5 5 台设备。将这些数值代入公式:

n≥(3−1)+(4−1)+(5−1)+1 n \geq (3 - 1) + (4 - 1) + (5 - 1) + 1

n≥2+3+4+1 n \geq 2 + 3 + 4 + 1

n≥10 n \geq 10

因此,确保系统不发生死锁的最小设备数 n n 为 10 10 。

正确答案:B

进入练习

第 25 题

操作系统
2 分

下列指令中,不能在用户态执行的是( )。

A. trap 指令 B. 跳转指令

C. 压栈指令

D. 关中断指令

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在计算机系统中,用户态和内核态是两种不同的执行权限级别。用户态下的程序只能执行非特权指令,而内核态下的程序可以执行所有指令,包括特权指令。

  • A. trap 指令:可以在用户态执行。trap 指令用于从用户态切换到内核态,例如系统调用就是通过 trap 指令触发的。

  • B. 跳转指令:可以在用户态执行。跳转指令(如 jmp、call、ret 等)用于控制程序流程,不涉及特权操作。

  • C. 压栈指令:可以在用户态执行。压栈指令(如 push)用于操作栈内存,属于非特权指令。

  • D. 关中断指令:不能在用户态执行。关中断指令(如 cli)是特权指令,只有在内核态才能执行,因为它会禁用中断,影响系统的全局状态。

因此,关中断指令是唯一不能在用户态执行的指令。

正确答案:D

进入练习

第 26 题

操作系统
2 分

一个进程的读磁盘操作完成后,操作系统针对该进程必做的是( )。

A. 修改进程状态为就绪态

B. 降低进程优先级

D. 增加进程时间片大小

C. 给进程分配用户内存空间

查看答案与解析收起答案与解析

参考答案:A

题目详解:
当一个进程的读磁盘操作完成后,操作系统需要将该进程从阻塞态(等待I/O操作完成的状态)转变为就绪态(准备被CPU调度的状态)。这是因为:

  1. 进程在等待磁盘I/O时处于 阻塞态(Blocked State \text{Blocked State} ),此时它不占用CPU资源。
  2. 当I/O操作完成后,进程已经具备继续执行的条件,因此操作系统会将其状态修改为 就绪态(Ready State \text{Ready State} ),并将其放入就绪队列,等待CPU调度。

其他选项的分析:

  • B. 降低进程优先级:I/O操作完成并不会直接导致进程优先级降低,优先级调整通常基于调度算法或进程行为。
  • C. 给进程分配用户内存空间:内存分配通常在进程创建时完成,而不是在I/O操作完成后。
  • D. 增加进程时间片大小:时间片大小由调度策略决定,与I/O操作完成无关。

因此,必做的操作是修改进程状态为就绪态。

正确答案:A

进入练习

第 27 题

操作系统
2 分

现有一个容量为 10GB 的磁盘分区, 磁盘空间以簇(Cluster)为单位进行分配,簇的大小为4KB,若采用位图法管理该分区的空闲空间,即用一位(bit)标识一个簇是否被分配,则存放该位图所需簇的个数为( )。

A. 80

B. 320

C. 80K

D. 320K

查看答案与解析收起答案与解析

参考答案:A

题目详解:
首先,我们需要计算该磁盘分区中共有多少个簇。已知磁盘容量为 10GB 10GB ,簇的大小为 4KB 4KB ,因此簇的总数为:

簇的总数=10GB4KB=10×1024×1024KB4KB=2,621,440 个簇 \text{簇的总数} = \frac{10GB}{4KB} = \frac{10 \times 1024 \times 1024 KB}{4KB} = 2,621,440 \text{ 个簇}

接下来,采用位图法管理空闲空间时,每个簇需要用 1 1 位(bit)来标识是否被分配。因此,位图的总大小为:

位图大小(bit)=2,621,440 bit \text{位图大小(bit)} = 2,621,440 \text{ bit}

将位图大小转换为字节(Byte):

位图大小(Byte)=2,621,4408=327,680 Byte \text{位图大小(Byte)} = \frac{2,621,440}{8} = 327,680 \text{ Byte}

由于簇的大小为 4KB 4KB (即 4×1024=4,096 Byte 4 \times 1024 = 4,096 \text{ Byte} ),因此存放位图所需的簇个数为:

所需簇的个数=327,680 Byte4,096 Byte/簇=80 个簇 \text{所需簇的个数} = \frac{327,680 \text{ Byte}}{4,096 \text{ Byte/簇}} = 80 \text{ 个簇}

正确答案:A

进入练习

第 28 题

操作系统
2 分

下列措施中,能加快虚实地址转换的是( )。

I. 增大块表(TLB)容量

II. 让页表常驻内存

III. 增大交换区(swap)

A. 仅 I

B. 仅II

C. 仅I、II

D. 仅II、III

查看答案与解析收起答案与解析

参考答案:C

题目详解:
虚实地址转换是指将逻辑地址(虚拟地址)转换为物理地址的过程,其速度主要受以下因素影响:

  1. 增大块表(TLB)容量:TLB(Translation Lookaside Buffer)是一种高速缓存,用于存储近期使用的页表项。增大TLB容量可以提高命中率,从而减少访问内存中页表的次数,加快地址转换速度。因此,I是正确的。

  2. 让页表常驻内存:页表通常存储在内存中,如果页表被换出到交换区(swap),访问时需要先将其换入内存,这会显著增加地址转换时间。让页表常驻内存可以避免这种延迟,从而加快地址转换。因此,II是正确的。

  3. 增大交换区(swap):交换区主要用于存储被换出的页面,增大交换区并不能直接影响虚实地址转换的速度,因为它不涉及TLB或页表的访问效率。因此,III是错误的。

综上所述,能加快虚实地址转换的措施是 I 和 II,即选项 C。

正确答案:C

进入练习

第 29 题

操作系统
2 分

在一个文件被用户进程首次打开的过程中,操作系统需要做的是( )。

A. 将文件内容读到内存中

B. 将文件控制块读到内存中

C. 修改文件控制块中的读写权限

D. 将文件的数据缓冲区首指针返回给用户进程

查看答案与解析收起答案与解析

参考答案:B

题目详解:
在一个文件被用户进程首次打开的过程中,操作系统需要执行的关键步骤是将文件的控制信息(即文件控制块,File Control Block,FCB)从磁盘读取到内存中。文件控制块包含了文件的元数据,例如文件大小、创建时间、修改时间、权限、存储位置等信息。这些信息是操作系统管理文件的基础。

具体分析各个选项:

  • 选项A:将文件内容读到内存中。这是不正确的,因为在文件首次打开时,操作系统通常不会立即将文件内容全部读入内存,而是等到实际需要访问文件内容时才进行读取(按需读取)。

  • 选项B:将文件控制块读到内存中。这是正确的,因为操作系统需要文件的元数据信息来管理文件的访问和操作。

  • 选项C:修改文件控制块中的读写权限。这是不正确的,因为文件打开操作通常不会直接修改文件的权限,除非显式调用了权限修改的系统调用。

  • 选项D:将文件的数据缓冲区首指针返回给用户进程。这是不正确的,因为用户进程通常不直接访问文件的数据缓冲区,而是通过文件描述符或句柄来间接访问文件内容。

因此,正确答案是 B。

进入练习

第 30 题

操作系统
2 分

在页式虚拟存储管理系统中,采用某些页面置换算法,会出现Belady 异常现象,即进程的缺页次数会随着分配给该进程的页框个数的增加而增加。下列算法中,可能出现Belady 异常现象的是( )。

I. LRU 算法

II. FIFO 算法

III. OPT 算法

A. 仅II

B. 仅I、II

C. 仅I、III

D. 仅II、III

查看答案与解析收起答案与解析

参考答案:A

题目详解:
在页式虚拟存储管理系统中,Belady 异常是指在某些页面置换算法中,分配给进程的页框数量增加时,缺页次数反而增加的反常现象。以下是各算法的分析:

  1. FIFO 算法(先进先出):可能出现Belady 异常。FIFO 算法按照页面进入内存的顺序进行置换,当页框增加时,可能会导致某些本应保留的页面被置换出去,从而增加缺页次数。例如,对于访问序列 1,2,3,4,1,2,5,1,2,3,4,5 1, 2, 3, 4, 1, 2, 5, 1, 2, 3, 4, 5 ,当页框从 3 3 增加到 4 4 时,缺页次数反而增加。

  2. LRU 算法(最近最少使用):不会出现Belady 异常。LRU 算法基于局部性原理,置换最长时间未被使用的页面,页框增加时缺页次数不会增加。

  3. OPT 算法(最优置换):不会出现Belady 异常。OPT 算法是理论最优算法,总是置换未来最长时间不会被使用的页面,页框增加时缺页次数不会增加。

因此,仅FIFO 算法(II)可能出现Belady 异常。

正确答案:A

进入练习

第 31 题

操作系统
2 分

下列关于管道(Pipe)通信的叙述中,正确的是( )。

A. 一个管道可实现双向数据传输

B. 管道的容量仅受磁盘容量大小限制

C. 进程对管道进行读操作和写操作都可能被阻塞

D. 一个管道只能有一个读进程或一个写进程对其操作

查看答案与解析收起答案与解析

参考答案:C

题目详解:
管道(Pipe)通信是一种半双工的进程间通信机制,其特点和工作原理如下:

  1. 数据传输方向:管道是半双工的,即数据只能在一个方向上流动。因此,一个管道不能实现双向数据传输(选项A错误)。如果需要双向通信,通常需要创建两个管道。

  2. 管道容量限制:管道的容量并不受磁盘容量限制,而是由内核的缓冲区大小决定。管道在内存中分配固定大小的缓冲区(通常为4KB或64KB),当缓冲区满时,写操作会被阻塞。因此,管道的容量并非仅受磁盘容量限制(选项B错误)。

  3. 阻塞操作:进程对管道的读写操作可能会被阻塞:

    • 读操作阻塞:当管道为空时,读进程会被阻塞,直到有数据写入。
    • 写操作阻塞:当管道缓冲区满时,写进程会被阻塞,直到有读进程读取数据。
      因此,进程对管道的读操作和写操作都可能被阻塞(选项C正确)。
  4. 进程数量限制:一个管道可以有多个读进程或多个写进程,但通常不推荐这样使用,因为可能引发数据混乱。一个管道并不限制只能有一个读进程或一个写进程(选项D错误)。

正确答案:C

进入练习

第 32 题

操作系统
2 分

下列选项中,属于多级页表优点的是( )。

A. 加快地址变换速度

B. 减少缺页中断次数

C. 减少页表项所占字节数

D. 减少页表所占的连续内存空间

查看答案与解析收起答案与解析

参考答案:D

题目详解:
多级页表的主要优点在于能够 减少页表所占的连续内存空间 。下面详细分析各选项:

  1. 选项A:多级页表实际上会 减慢地址变换速度 ,因为需要多次访问内存才能完成地址转换,因此A是错误的。

  2. 选项B:缺页中断次数与程序的局部性和内存分配策略相关,与是否使用多级页表无关,因此B是错误的。

  3. 选项C:页表项的大小由地址位数和页表项结构决定,多级页表并不会改变单个页表项所占的字节数,因此C是错误的。

  4. 选项D:多级页表通过只存储活跃部分的页表项,可以 显著减少页表对连续内存空间的占用 ,这是其核心优势之一,因此D是正确的。

正确答案:D

进入练习

第 33 题

计算机网络
2 分

在OSI 参考模型中,直接为会话层提供服务的是( )。

A. 应用层

B. 表示层

C. 传输层

D. 网络层

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在OSI(Open Systems Interconnection)参考模型中,共有7层,从上到下依次为:应用层(第7层 第7层 )、表示层(第6层 第6层 )、会话层(第5层 第5层 )、传输层(第4层 第4层 )、网络层(第3层 第3层 )、数据链路层(第2层 第2层 )和物理层(第1层 第1层 )。每一层为其上一层提供服务,同时接受下一层的服务。

题目问的是“直接为会话层提供服务的是哪一层”,因此需要找到会话层的下一层。根据OSI模型的分层结构,会话层(第5层 第5层 )的下一层是传输层(第4层 第4层 ),所以传输层直接为会话层提供服务。

正确答案:C

进入练习

第 34 题

计算机网络
2 分

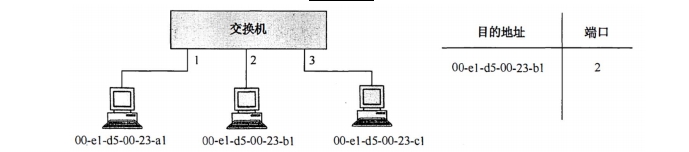
某以太网拓扑及交换机当前转发表如下图所示,主机 00-e1-d5-00-23-a1 向主机 00-e1-d5-00-23-c1发送 1 个数据帧,主机 00-e1-d5-00-23-c1 收到该帧后,向主机 00-e1-d5-00-23-a1发送1个确认帧,交换机对这两个帧的转发端口分别是( )。

2014-34

A. {3}和{1}

B. {2, 3}和{1}

C. {2,3}和{1, 2}

D. {1, 2, 3}和{1}

查看答案与解析收起答案与解析

参考答案:B

题目详解:
主机 00-el-d5-00-23-a1 向 00-el-d5-00-23-c1 发送数据帧时交换机转发表中没有 00-el-d5-00-23-c1 这项,所以向除 1 接口外的所有接口广播这帧,即 2、3 端口会转发这帧,同时因为转发表中并没有 00-e1-d5-00-23-a1 这项,所以转发表会把(目的地址 00-el-d5-00-23-a1,端口 1)这项加入转发表。而当 00-el-d5-00-23-c1 向 00-e1-d5-00-23-a1 发送确认帧时,由于转发表已经有 00-el-d5-00-23-a1 这项,所以交换机只向 1 端口转发,选 B。

正确答案:B

进入练习

第 35 题

计算机网络
2 分

下列因素中,不会影响信道数据传输速率的是( )。

A. 信噪比

B. 频率宽带

C. 调制速率

D. 信号传播速度

查看答案与解析收起答案与解析

参考答案:D

题目详解:
信道数据传输速率主要受以下几个因素影响:

  1. 信噪比(A选项):由香农定理 C=Blog⁡2(1+SN) C = B \log_2(1 + \frac{S}{N}) 可知,信道容量 C C 与信噪比 SN \frac{S}{N} 直接相关,其中 S S 是信号功率,N N 是噪声功率。信噪比越高,数据传输速率越高。

  2. 频率带宽(B选项):同样由香农定理 C=Blog⁡2(1+SN) C = B \log_2(1 + \frac{S}{N}) 可知,信道容量 C C 与带宽 B B 成正比,带宽越大,数据传输速率越高。

  3. 调制速率(C选项):调制速率(即符号速率)决定了单位时间内传输的符号数。数据传输速率 R R 可以表示为 R=Nlog⁡2M R = N \log_2 M ,其中 N N 是调制速率,M M 是调制阶数。因此调制速率越高,数据传输速率越高。

  4. 信号传播速度(D选项):信号传播速度是指信号在介质中传播的快慢(如电磁波在光纤或空气中的速度),它影响的是信号的传输延迟,而不会直接影响信道的数据传输速率。因此,信号传播速度与数据传输速率无关。

综上所述,信号传播速度不会影响信道数据传输速率。

正确答案:D

进入练习

第 36 题

计算机网络
2 分

主机甲与主机乙之间使用后退N 帧协议(GBN)传输数据,甲的发送窗口尺寸为 1000,数据帧长为 1000 字节,信道带宽为 100Mbps,乙每收到一个数据帧立即利用一个短帧(忽略其传输延迟)进行确认,若甲、乙之间的单向传播延迟是 50ms,则甲可以达到的最大平均数据传输速率约为( )。

A. 10Mbps

B. 20Mbps

C. 80Mbps

D. 100Mbps

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在后退 N N 帧协议(GBN)中,发送窗口尺寸为 W=1000 W = 1000 ,数据帧长度为 L=1000 L = 1000 字节 =8000 = 8000 比特,信道带宽为 B=100 B = 100 Mbps,单向传播延迟为 Tp=50 T_p = 50 ms。

  1. 计算发送窗口的总数据量:
    发送窗口的总数据量为 W×L=1000×8000=8×10⁶ W \times L = 1000 \times 8000 = 8 \times 10^6 比特。

  2. 计算传输延迟:
    传输一个数据帧的时间为 Ttx=LB=8000100×106=0.08 T_{tx} = \frac{L}{B} = \frac{8000}{100 \times 10^6} = 0.08 ms。

  3. 计算往返时间(RTT):
    由于乙每收到一个数据帧立即发送确认(忽略短帧的传输延迟),RTT 主要由单向传播延迟的两倍决定,即 RTT=2×Tp=100 RTT = 2 \times T_p = 100 ms。

  4. 计算最大平均数据传输速率:
    发送窗口的总数据量需要在 RTT+Ttx RTT + T_{tx} 时间内传输完成。由于 Ttx T_{tx} 远小于 RTT RTT ,可以近似忽略。因此,最大平均数据传输速率为:
    速率=W×LRTT=8×106100×10−3=80×106 bps=80 Mbps \text{速率} = \frac{W \times L}{RTT} = \frac{8 \times 10^6}{100 \times 10^{-3}} = 80 \times 10^6 \text{ bps} = 80 \text{ Mbps}

正确答案:C

进入练习

第 37 题

计算机网络
2 分

站点A、B、C 通过CDMA 共享链路,A、B、C 的码片序列(chipping sequence)分别是(1, 1, 1,1)、(1,-1, 1, -1)和(1, 1, -1, -1)。若C 从链路上收到的序列是(2, 0, 2, 0, 0, -2, 0, -2, 0, 2,0, 2), 则C 收到A 发送的数据是( )。

A. 000

B. 101

C. 110

D. 111

查看答案与解析收起答案与解析

参考答案:B

题目详解:
CDMA解码过程需要将接收到的序列与接收站点的码片序列进行内积运算,然后归一化得到发送的数据。具体步骤如下:

  1. 接收到的序列为 S=(2,0,2,0,0,−2,0,−2,0,2,0,2) S = (2, 0, 2, 0, 0, -2, 0, -2, 0, 2, 0, 2) ,这是一个长度为12的序列。由于C的码片序列长度为4,因此需要将 S S 分成3个长度为4的片段:

    • S1=(2,0,2,0) S_1 = (2, 0, 2, 0)
    • S2=(0,−2,0,−2) S_2 = (0, -2, 0, -2)
    • S3=(0,2,0,2) S_3 = (0, 2, 0, 2)
  2. C的码片序列为 C=(1,1,−1,−1) C = (1, 1, -1, -1) 。为了解码A发送的数据,我们需要使用A的码片序列 A=(1,1,1,1) A = (1, 1, 1, 1) 与每个片段进行内积运算,然后除以码片序列长度4。

  3. 对每个片段计算内积:

    • 对于 S1 S_1 :
      S1⋅A=2×1+0×1+2×1+0×1=2+0+2+0=4 S_1 \cdot A = 2 \times 1 + 0 \times 1 + 2 \times 1 + 0 \times 1 = 2 + 0 + 2 + 0 = 4
      归一化结果为 44=1 \frac{4}{4} = 1 。
    • 对于 S2 S_2 :
      S2⋅A=0×1+(−2)×1+0×1+(−2)×1=0−2+0−2=−4 S_2 \cdot A = 0 \times 1 + (-2) \times 1 + 0 \times 1 + (-2) \times 1 = 0 - 2 + 0 - 2 = -4
      归一化结果为 −44=−1 \frac{-4}{4} = -1 。
    • 对于 S3 S_3 :
      S3⋅A=0×1+2×1+0×1+2×1=0+2+0+2=4 S_3 \cdot A = 0 \times 1 + 2 \times 1 + 0 \times 1 + 2 \times 1 = 0 + 2 + 0 + 2 = 4
      归一化结果为 44=1 \frac{4}{4} = 1 。
  4. 将归一化结果转换为二进制数据:

    • 1 1 对应二进制 1 1 ;
    • −1 -1 对应二进制 0 0 ;
    • 1 1 对应二进制 1 1 。
      因此,C收到A发送的数据是 101 101 。

正确答案:B

进入练习

第 38 题

计算机网络
2 分

主机甲和主机乙已建立了TCP 连接,甲始终以MSS = 1KB 大小的段发送数据,并一直有数据发送;乙每收到一个数据段都会发出一个接收窗口为 10KB 的确认段。若甲在t 时刻发生超时时拥塞窗口为 8KB,则从t 时刻起,不再发生超时的情况下,经过 10 个RTT 后,甲的发送窗口是( )。

A. 10KB

B. 12KB

C. 14KB

D. 15KB

查看答案与解析收起答案与解析

参考答案:A

题目详解:
在TCP拥塞控制机制中,当发生超时时,拥塞窗口(cwnd cwnd )会重置为1个MSS(这里是1KB 1KB ),然后进入慢启动阶段。慢启动阶段cwnd cwnd 按指数增长,直到达到慢启动阈值(ssthresh ssthresh ),之后进入拥塞避免阶段,cwnd cwnd 按线性增长。

题目中给出:

  • MSS=1KB MSS = 1KB
  • 超时时刻t t 的cwnd=8KB cwnd = 8KB ,因此ssthresh ssthresh 会被设置为cwnd2=4KB \frac{cwnd}{2} = 4KB 。
  • 接收窗口(rwnd rwnd )始终为10KB 10KB 。

从t t 时刻起,cwnd cwnd 的变化如下(假设每个RTT增长一次):

  1. cwnd=1KB cwnd = 1KB (慢启动)
  2. cwnd=2KB cwnd = 2KB (慢启动)
  3. cwnd=4KB cwnd = 4KB (达到ssthresh ssthresh ,进入拥塞避免)
  4. cwnd=5KB cwnd = 5KB (拥塞避免)
  5. cwnd=6KB cwnd = 6KB (拥塞避免)
  6. cwnd=7KB cwnd = 7KB (拥塞避免)
  7. cwnd=8KB cwnd = 8KB (拥塞避免)
  8. cwnd=9KB cwnd = 9KB (拥塞避免)
  9. cwnd=10KB cwnd = 10KB (拥塞避免)
  10. cwnd=11KB cwnd = 11KB (拥塞避免)

发送窗口(swnd swnd )是min(cwnd,rwnd) min(cwnd, rwnd) ,因此在第10个RTT时,cwnd=11KB cwnd = 11KB ,但rwnd=10KB rwnd = 10KB ,所以swnd=10KB swnd = 10KB 。

正确答案:A

进入练习

第 39 题

计算机网络
2 分

下列关于UDP 协议的叙述中,正确的是( )。

I. 提供无连接服务

II. 提供复用/分用服务

III. 通过差错校验,保障可靠数据传输

A. 仅 I

B. 仅I、II

C. 仅II、III

D. I、II、III

查看答案与解析收起答案与解析

参考答案:B

题目详解:
UDP(User Datagram Protocol,用户数据报协议)是一种无连接的传输层协议,其特点如下:

  1. 提供无连接服务(I):UDP 在传输数据之前不需要建立连接,直接发送数据报,因此具有较低的延迟。这一点是正确的。

  2. 提供复用/分用服务(II):UDP 通过端口号实现复用(多个应用共享同一个传输层协议)和分用(将数据正确交付给目标应用)。这一点也是正确的。

  3. 通过差错校验,保障可靠数据传输(III):UDP 虽然提供了差错校验(通过校验和字段检测数据是否出错),但一旦检测到错误,UDP 会直接丢弃数据报,而不会重传或修复,因此 不能 保障可靠数据传输。这一点是错误的。

综上所述,正确的叙述是 I 和 II。

正确答案:B

进入练习

第 40 题

计算机网络
2 分

使用浏览器访问某大学Web 网站主页时, 不可能使用到的协议是( )。

A. PPP

B. ARP

C. UDP

D. SMTP

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在访问某大学Web网站主页时,会涉及以下协议:

  1. PPP(Point-to-Point Protocol):如果用户通过拨号或DSL等方式连接到互联网,可能会使用PPP协议建立连接。因此,PPP可能被使用。

  2. ARP(Address Resolution Protocol):ARP用于将IP地址解析为MAC地址。在数据传输过程中,ARP可能会在本地网络中被使用。因此,ARP可能被使用。

  3. UDP(User Datagram Protocol):DNS查询通常使用UDP协议,而访问Web网站时需要DNS解析域名。因此,UDP可能被使用。

  4. SMTP(Simple Mail Transfer Protocol):SMTP是用于发送电子邮件的协议,与访问Web网站无关。因此,SMTP不可能被使用。

综上所述,访问Web网站时不可能使用到的协议是SMTP。

正确答案:D

进入练习

综合应用题

7 题 · 共 73 分

第 41 题

数据结构
13 分

(13 分)二叉树的带权路径长度(WPL)是二叉树中所有叶结点的带权路径长度之和。给定一棵

二叉树T ,采用二叉链表存储, 结点结构如下:

2014-41

其中叶结点的weight 域保存该结点的非负权值。设root 为指向T 的根结点的指针,请设计求T的WPL 的算法,要求:

(1)给出算法的基本设计思想。

(2)使用C 或C++语言,给出二叉树结点的数据类型定义。

(3)根据设计思想,采用C 或C++语言描述算法,关键之处给出注释。

查看答案与解析收起答案与解析

题目详解:
1、算法的基本设计思想:

①基于先序递归遍历的算法思想是用一个 static 变量记录 wpl,把每个结点的深度作为递归函数的一个参数传递,算法步骤如下:

若该结点是叶子结点,则变量 wpl 加上该结点的深度与权值之积;

若该结点非叶子结点,则若左子树不为空,对左子树调用递归算法,若右子树不为空,对右子树调用递归算法,深度参数均为本结点的深度参数加 1;

最后返回计算出的 wpl 即可。

②基于层次遍历的算法思想是使用队列进行层次遍历,并记录当前的层数,

当遍历到叶子结点时,累计 wpl;

当遍历到非叶子结点时,把该结点的子树加入队列;

当某结点为该层的最后一个结点时,层数自增 1;

队列空时遍历结束,返回 wpl。

2、二叉树结点的数据类型定义如下:

c 复制代码
typedef struct BiTNode(
    int weight;
    struct BiTNode *lchild,*rchild;
}BiTNode,*BiTree;
  1. 算法代码如下:
c 复制代码
int _wpl(Node *root, int depth) {
  if (!root) {
    return 0;
  }
  int sum = 0;
  if (root->lchild == NULL && root->rchild == NULL) {
    sum += (depth * root->weight);
  }
  sum += _wpl(root->left, depth+1);
  sum += _wpl(root->right, depth+1);
  return sum;
}

int wpl(Node *root) {
  return _wpl(root, 0);
}

【评分说明】

①若考生给出能够满足题目要求的其他算法且正确,可同样给分。

②考生答案无论使用 C 或者 C++ 语言,只要答案正确同样给分。

③若对算法的基本设计思想和主要数据结构描述不十分准确,但在算法实现中能够清晰反映出算法思想且正确,参照①的标准给分。

④若考生给出的二叉树结点的数据类型定义和算法实现中,使用的是除整型之外的其他数值,可视同使用整型类型。

⑤若考生给出的答案中算法主要设计思想或算法中部分正确,可酌情给分。

进入练习

第 42 题

数据结构
10 分

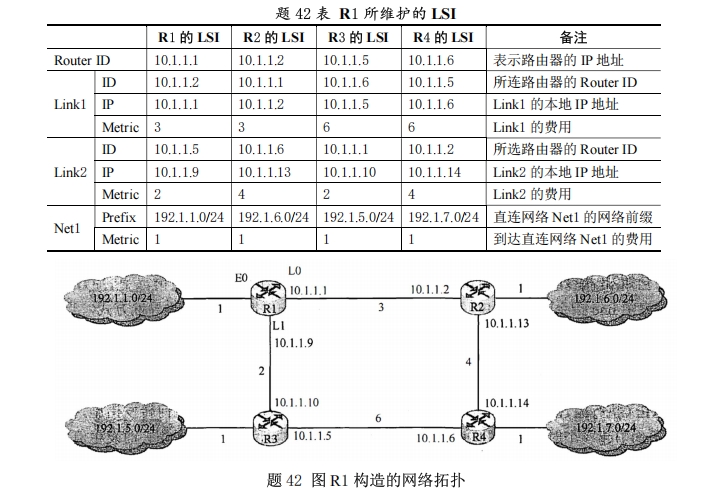
(10 分)某网络中的路由器运行OSPF 路由协议,题 42 表是路由器R1 维护的主要链路状态信息(LSI),题 42 图是根据题 42 表及R1 的接口名构造出来的网络拓扑。请回答下列问题。

2014-42

1)本题中的网络可抽象为数据结构中的哪种逻辑结构?

2)针对题 42 表中的内容,设计合理的链式存储结构,以保存题 42 表中的链路状态信息(LSI)。要求给出链式存储结构的数据类型定义,并画出对应题 42 表的链式存储结构示意图(示意图中可仅以ID 标识结点)。

3)按照迪杰斯特拉(Dijkstra)算法的策略,依次给出R1 到达题 42 图中子网 192.1.x.x 的最短路径及费用。

查看答案与解析收起答案与解析

题目详解:
很多考生乍看之下以为是网络的题目,其实该题本身并没有涉及太多的网络知识点,只是 应用了网络的模型,实际上考查的还是数据结构的内容。

1)图(1 分)

题中给出的是一个简单的网络拓扑图,可以抽象为无向图。

【评分说明】只要考生的答案中给出与图含义相似的描述,例如,“网状结构”“非线性结构”等,同样 给分。

2)链式存储结构的如下图所示。

c 复制代码
struct Arc {
  uint32_t id;
  uint32_t ip;
  int metric;
};

struct Net {
  uint32_t prefix;
  uint32_t mask;
  int metric;
};

struct LNode {
  LNode *next;
  // flag == 1:链路连接到路由器
  // flag == 2:链路连接到子网
  int flag;
  union NetOrArc {
    Net net;
    Arc arc;
  };
};

struct HNode {
  uint32_t router_id;
  LNode *next;
  HNode *next_hnode;
};

【评分说明】

① 若考生给出的答案是将链表中的表头结点保存在一个一维数组中(即采用邻接表形 式),同样给分。

② 若考生给出的答案中,弧结点没有使用 union 定义,而是采用两种不同的结构分别表示 Link 和 Net,同时在表头结点中定义了两个指针,分别指向由这两种类型的结点构成的两个链 表,同样给分。

③考生所给答案的弧结点中,可以在单独定义的域中保存各直连网络 P 地址的前缀长度, 也可以与网络地址保存在同一个域中。

④数据类型定义中,只要采用了可行的链式存储结构,并保存了题目中所给的 LS 信息, 如将网络抽象为一类结点,写出含 8 个表头结点的链式存储结构,均可参照①③的标准给分。

⑤若考生给出的答案中,图示部分与其数据类型定义部分一致,图示只要能够体现链式 存储结构和网络连接关系(可以不给出结点内细节信息),即可给分。

⑥若解答不完全正确,酌情给分。

3)计算结果如下表所示:

目的网络 路径 代价(费用)
步骤 1 192.1.1.0/24 直接到达 1
步骤 2 192.1.5.0/24 R1→R3→192.1.5.0/24 3
步骤 3 192.1.6.0/24 R1→R2→192.1.6.0/24 4
步骤 4 192.1.7.0/24 R1→R2→R4→192.1.7.0/24 8

【评分说明】

①若考生给出的各条最短路径的结果部分正确,可酌情给分。

②若考生给出的从 R1 到达子网 192.1.x.x 的最短路径及代价正确,但不完全符合代价不减 的次序,可酌情给分。

进入练习

第 43 题

计算机网络
9 分

(9 分)请根据题 42 描述的网络, 继续回答下列问题。

(1)假设路由表结构如下表所示, 请给出题 42 图中R1 的路由表, 要求包括到达题 42 图中子网 192.1.x.x 的路由,且路由表中的路由项尽可能少。

2014-43

(2)当主机 192.1.1.130 向主机 192.1.7.211 发送一个TTL = 64的IP 分组时,R1 通过哪个接口转发该IP 分组?主机 192.1.7.211 收到的IP 分组TTL 是多少?

(3)若 R1 增加一条 Metric 为 10 的链路连接 Internet, 则题 42 表中 R1 的 LSI 需要增加哪些信息?

查看答案与解析收起答案与解析

题目详解:
(1) R1 的路由表(尽可能减少路由项,使用路由聚合):

目的网络 下一跳 接口
192.1.1.0/24 – E0
192.1.5.0/24 10.1.1.10 L1
192.1.6.0/23 10.1.1.2 L0
  • 192.1.1.0/24 是直连网络,通过接口 E0 直接转发。
  • 192.1.5.0/24 经由 R3(下一跳 10.1.1.10),通过接口 L1 转发。
  • 192.1.6.0/24 和 192.1.7.0/24 可聚合为 192.1.6.0/23,经由 R2(下一跳 10.1.1.2),通过接口 L0 转发。

(2) R1 通过接口 L0 转发该 IP 分组。主机 192.1.7.211 收到的 IP 分组的 TTL 是 61。

数据包路径:192.1.1.130 → R1 → R2 → R4 → 192.1.7.211,共经过 3 个路由器,TTL 减少 3,故为 64 – 3 = 61。

(3) R1 的 LSI 需增加以下信息:

网络前缀 度量值
0.0.0.0/0 10
  • 增加一条默认路由(0.0.0.0/0),指向 Internet,其 Metric 为 10。

附:路由聚合说明

子网 192.1.6.0/24 和 192.1.7.0/24 的二进制形式为:

  • 192.1.6.0 → 11000000.00000001.00000110.00000000
  • 192.1.7.0 → 11000000.00000001.00000111.00000000

最长公共前缀为 23 位,故聚合为 192.1.6.0/23。

进入练习

第 44 题

计算机组成原理
13 分

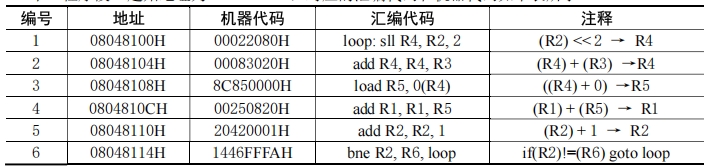
(12 分)某程序中有如下循环代码段P:“for(int i = 0; i < N; i++) sum+=A[i];”。假设编译时变量sum 和i 分别分配在寄存器R1和R2 中。常量N 在寄存器R6 中,数组A 的首地址在寄存器R3中。程序段P 起始地址为 0804 8100H,对应的汇编代码和机器代码如下表所示。

2014-44

执行上述代码的计算机M 采用 32 位定长指令字,其中分支指令bne 采用如下格式

2014-44a

OP 为操作码;Rs 和Rd 为寄存器编号;OFFSET 为偏移量,用补码表示。请回答下列问题,并说明理由。

(1)M 的存储器编址单位是什么?

(2)已知sll 指令实现左移功能,数组A 中每个元素占多少位?

(3)表中bne 指令的OFFSET 字段的值是多少?已知bne 指令采用相对寻址方式,当前PC 内容为 bne 指令地址,通过分析表中指令地址和bne 指令内容,推断出bne 指令的转移目标地址计算公式。

(4)若M 采用如下“按序发射、按序完成”的 5 级指令流水线:IF(取值)、ID(译码及取数)、EXE(执行)、MEM(访存)、WB(写回寄存器),且硬件不采取任何转发措施,分支指令的执行均引起 3 个时钟周期的阻塞,则P 中哪些指令的执行会由于数据相关而发生流水线阻塞?哪条指令的执行会发生控制冒险?为什么指令 1 的执行不会因为与指令 5 的数据相关而发生阻塞?

查看答案与解析收起答案与解析

题目详解:
该题涉及指令系统、存储管理以及 CPU 三个部分内容,考生应注意各章节内容之间的联系。

1)已知计算机 M 采用 32 位定长指令字,即一条指令占 4B,观察表中各指令的地址可知,每条指令的地址差为 4 个地址单位,即 4 个地址单位代表 4B,一个地址单位就代表了 1B,所以该计算机是按字节编址的。(2 分)

2)在二进制中某数左移两位相当于乘以 4,由该条件可知,数组间的数据间隔为 4 个地址单位,而计算机按字节编址,所以数组 A 中每个元素占 4B。(2 分)

3)由表可知,bne 指令的机器代码为 1446 FFFAH,根据题目给出的指令格式,后 2B 的内容为 OFFSET 字段,所以该指令的 OFFSET 字段为 FFFAH,用补码表示,值为 -6(1 分)。当系统执行到 bne 指令时,PC 自动加 4,PC 的内容就为 08048118H,而跳转的目标是 08048100H,两者相差了 18H,即 24 个单位的地址间隔,所以偏移址的一位即是真实跳转地址的 -24/-6=4 位(1 分)。可知 bne 指令的转移目标地址计算公式为 (PC)+4+OFFSETx4(1 分)。

4)由于数据相关而发生阻塞的指令为第 2、3、4、6 条,因为第 2、3、4、6 条指令都与各自前一条指令发生数据相关。(3 分)

第 6 条指令会发生控制冒险。(1 分)

当前循环的第五条指令与下次循环的第一条指令虽然有数据相关,但由于第 6 条指令后有 3 个时钟周期的阻塞,因而消除了该数据相关。(1 分)

【评分说明】对于第 1 问,若考生回答:因为指令 1 和 2、2 和 3、3 和 4、5 和 6 发生数据相关,因而发生阻塞的指令为第 2、3、4、6 条,同样给 3 分。答对 3 个以上给 3 分,部分正确酌情给分。

进入练习

第 45 题

计算机组成原理
12 分

(11 分)假设对于 44 题中的计算机M 和程序P 的机器代码, M 采用页式虚拟存储管理; P 开始执行时,(R1)=(R2)=0,(R6)=1000,其机器代码已调入主存但不在Cache 中;数组A 未调入主存,且所有数组元素在同一页,并存储在磁盘同一个扇区。请回答下列问题并说明理由。

(1)P 执行结束时,R2 的内容是多少?

(2)M 的指令Cache 和数据Cache 分离。若指令Cache 共有 16 行,Cache 和主存交换的块大小为32 字节,则其数据区的容量是多少?若仅考虑程序段P 的执行,则指令Cache 的命中率为多少?

(3)P 在执行过程中,哪条指令的执行可能发生溢出异常?哪条指令的执行可能产生缺页异常?对于数组A 的访问,需要读磁盘和TLB 至少各多少次?

查看答案与解析收起答案与解析

题目详解:
1)R2 里装的是 i 的值,循环条件是 i < N (1000),即当 i 自增到不满足这个条件时跳出循环,程序结束,所以此时 i 的值为 1000。(1 分)

2)Cache 共有 16 块,每块 32 字节,所以 Cache 数据区的容量为 16x32B=512B。(1 分)

P 共有 6 条指令,占 24 字节,小于主存块大小 (32B),其起始地址为 08048100H,对应一块的开始位置,由此可知所有指令都在一个主存块内。读取第一条指令时会发生 Cache 缺失,故将 P 所在的主存块调入 Cache 某一块,以后每次读取指令时,都能在指令 Cache 中命中。因此在 1000 次循环中,只会发生 1 次指令访问缺失,所以指令 Cache 的命中率为 (1000x6-1)/(1000×6)=99.98%。(2 分)

【评分说明】若考生给出正确的命中率,而未说明原因和过程,给 1 分。若命中率计算错误,但解题思路正确,可酌情给分。

3)指令 4 为加法指令,即对应 sum+=Aii,当数组 A 中元素的值过大时,则会导致这条加法指令发生溢出异常;而指令 2、5 虽然都是加法指令,但它们分别为数组地址的计算指令和存储变量 i 的寄存器进行自增的指令,而 i 最大到达 1000,所以它们都不会产生溢出异常。(2 分)

只有访存指令可能产生缺页异常,即指令 3 可能产生缺页异常。(1 分)

因为数组 A 在磁盘的一页上,而一开始数组并不在主存中,第一次访问数组时会导致访盘,把 A 调入内存,而以后数组 A 的元素都在内存中,则不会导致访盘,所以该程序一共访盘一次。(2 分)

每访问一次内存数据就会查 TLB 一次,共访问数组 1000 次,所以此时又访问 TLB 1000 次,还要考虑到第一次访问数组 A,即访问 A00 时,会多访问一次 TLB(第一次访问 A00 会先查一次 TLB,然后产生缺页,处理完缺页中断后,会重新访问 A00,此时又查 TLB),所以访问 TLB 的次数一共是 1001 次。(2 分)

【评分说明】

①对于第 1 问,若答案中除指令 4 外还包含其他运算类指令(即指令 1、2、5),则给 1 分,其他情况,则给 0 分。

②对于第 2 问,只要回答“1oad 指令”,即可得分。

③对于第 3 问,若答案中给出的读 TLB 的次数为 1002,同样给分。若直接给出正确的 TLB 及磁盘的访问次数,而未说明原因,给 3 分。若给出的 TLB 及磁盘访问次数不正确,但解题思路正确,可酌情给分。

进入练习

第 46 题

操作系统
8 分

(7 分)文件F 由 200 条记录组成,记录从 1 开始编号。用户打开文件后,欲将内存中的一条记录插入到文件F 中,作为其第 30 条记录。请回答下列问题,并说明理由。

(1)若文件系统采用连续分配方式,每个磁盘块存放一条记录,文件F 存储区域前后均有足够的空闲磁盘空间,则完成上述插入操作最少需要访问多少次磁盘块? F 的文件控制块内容会发生哪些改变?

(2)若文件系统采用链接分配方式,每个磁盘块存放一条记录和一个链接指针,则完成上述插入操作需要访问多少次磁盘块?若每个存储块大小为 1KB,其中 4 字节存放链接指针,则该文件系统支持的文件最大长度是多少?

查看答案与解析收起答案与解析

题目详解:
1)系统采用顺序分配方式时,插入记录需要移动其他的记录块,整个文件共有 200 条记录,要插入新记录作为第 30 条,而存储区前后均有足够的磁盘空间,且要求最少的访问存储块数,则要把文件前 29 条记录前移,若算访盘次数移动一条记录读出和存回磁盘各是一次访盘,29 条记录共访盘 58 次,存回第 30 条记录访盘 1 次,共访盘 59 次。(1 分)

F 的文件控制区的起始块号和文件长度的内容会因此改变。(1 分)

2)文件系统采用链接分配方式时,插入记录并不用移动其他记录,只需找到相应的记录,修改指针即可。插入的记录为其第 30 条记录,那么 需要找到文件系统的第 29 块,一共需要访盘 29 次,然后把第 29 块的下块地址部分赋给新块,把新块存回内存会访盘 1 次,然后修改内存中第 29 块的下块地址字段,再存回磁盘(1 分),一共访盘 31 次。(1 分)

4 字节共 32 位,可以寻址 232=4G 块存储块,每块的大小为 1KB,即 1024B,其中下块地址部分占 4B,数据部分占 1020B,那么该系统的文件最大长度是 4G×1020B=4080GB。(2 分)

【评分说明】

①第 1 小题的第 2 小问,若答案中不包含文件的起始地址和文件大小,则不给分。

②若按 1024×232B=4096GB 计算最大长度,给 1 分。

进入练习

第 47 题

操作系统
8 分

(8 分)系统中有多个生产者进程和多个消费者进程,共享一个能存放 1000 件产品的环形缓冲区(初始为空)。当缓冲区未满时,生产者进程可以放入其生产的一件产品,否则等待;当缓冲区未空时,消费者进程可以从缓冲区取走一件产品,否则等待。要求一个消费者进程从缓冲区连续取出 10 件产品后,其他消费者进程才可以取产品。请使用信号量P,V(或wait(), signal())操作实现进程间的互斥与同步,要求写出完整的过程,并说明所用信号量的含义和初值。

查看答案与解析收起答案与解析

题目详解:
这是典型的生产者和消费者问题,只对典型问题加了一个条件,只需在标准模型上新加一 个信号量,即可完成指定要求。

设置四个变量 consumer_mutex、buffer_mutex、empty 和 full, consumer_mutex 用于一个控制一个消费者进程一个 周期(10 次)内对于缓冲区的控制,初值为 1;buffer_mutex 用于进程单次互斥的访问缓冲区,初值 为 1;empty 代表缓冲区的空位数,初值为 0;full 代表缓冲区的产品数,初值为 1000,具体进 程的描述如下:

c 复制代码
semaphore consumer_mutex = 1;
semaphore buffer_mutex = 1;
semaphore full = 0;
semaphore empty = 1000;

Consumer() {
  while (1) {
    P(consumer_mutex);
    for (int i = 0; i < 10; i++) {
      P(full);
      P(buffer_mutex);
      从缓冲区取出产品;
      V(buffer_mutex);
      V(empty);
      消费产品;
    }
    V(consumer_mutex);
  }
}

Producer() {
  while (1) {
    P(empty);
    生产产品;
    P(buffer_mutex);
    将产品放入缓冲区;
    V(buffer_mutex);
    V(full);
  }
}

【评分说明】

①信号量的初值和含义都正确给 2 分。

②生产者之间的互斥操作正确给 1 分;生产者与消费者之间的同步操作正确给 2 分;消费者之间互斥操作正确给 1 分。

③控制消费者连续取产品数量正确给 2 分。

④仅给出经典生产者 - 消费者问题的信号量定义和伪代码描述最多给 3 分。

⑤若考生将题意理解成缓冲区至少有 10 件产品,消费者才能开始取,其他均正确,得 6 分。

⑥部分完全正确,酌情给分。

进入练习