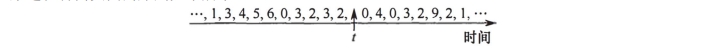2016计算机学科专业基础综合全卷预览

2016年408真题

2016年408真题完整试卷,包含 40 道选择题和 7 道综合应用题,共 47 题,题目分值合计 152 分。可按目录阅读全卷,展开参考答案解析,或进入对应题目练习。

返回年度练习
47题全卷题目
152分题目分值合计
40题选择题 · 80分
7题综合应用题 · 72分

选择题

40 题 · 共 80 分

第 1 题

数据结构
2 分

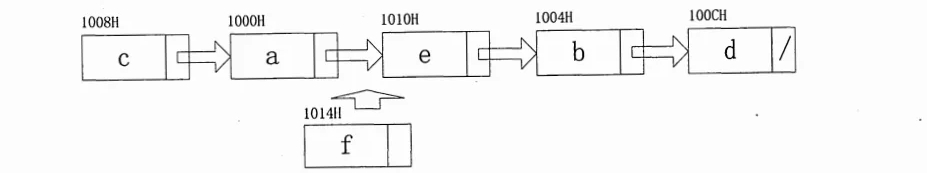
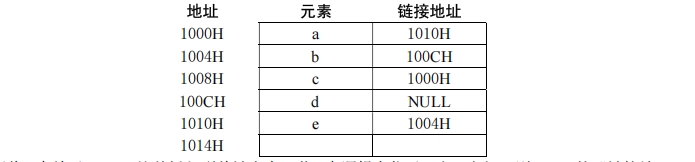
已知表头元素为 c 的单链表在内存中的存储状态如下表所示。现将 f 存放于 1014H 处并插入到单链表中,若 f 在逻辑上位于 a 和 e 之间,则 a, e, f 的“链接地址”依次是( )。
2016-1

A. 1010H,1014H,1004H

B. 1010H,1004H,1014H

C. 1014H,1010H,1004H

D. 1014H,1004H,1010H

查看答案与解析收起答案与解析

参考答案:D

题目详解:
根据存储状态,单链表的结构如下图所示。

image

其中“链接地址”是指结点 next 所指的内存地址。当结点 f 插入后,a 指向 f, f 指向 e, e 指向 b。显然 a、e 和 f 的“链接地址”分别是 f、b 和 e 的内存地址,即 1014H、1004H 和 1010H。
进入练习

第 2 题

数据结构
2 分

已知一个带有表头结点的双向循环链表 L,结点结构为 prev data next ,其中,prev 和 next分别是指向其直接前驱和直接后继结点的指针。现要删除指针 p 所指的结点,正确的语句序列是( )。

A. p->next->prev=p->prev; p->prev->next=p->prev; free(p);

B. p->next->prev=p->next; p->prev->next=p->next; free(p);

C. p->next->prev=p->next; p->prev->next=p->prev; free(p);

D. p->next->prev=p->prev;p->prev->next=p->next; free(p);

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在双向循环链表中,删除指针 p p 所指的结点需要调整其前驱结点和后继结点的指针。具体步骤如下:

  1. 将 p p 的后继结点的 prev prev 指针指向 p p 的前驱结点:
    p→next→prev=p→prev p \rightarrow next \rightarrow prev = p \rightarrow prev 。

  2. 将 p p 的前驱结点的 next next 指针指向 p p 的后继结点:
    p→prev→next=p→next p \rightarrow prev \rightarrow next = p \rightarrow next 。

  3. 最后释放 p p 所指结点的内存:
    free(p) free(p) 。

选项 D 正确地执行了上述操作:
p→next→prev=p→prev p \rightarrow next \rightarrow prev = p \rightarrow prev ;
p→prev→next=p→next p \rightarrow prev \rightarrow next = p \rightarrow next ;
free(p) free(p) 。

其他选项的调整方式不正确,可能导致链表断裂或指针错误。

正确答案:D

进入练习

第 3 题

数据结构
2 分

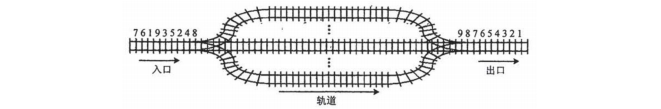
设有下图所示的火车车轨,入口到出口之间有 n 条轨道,列车的行进方向均为从左至右,列车可驶入任意一条轨道。现有编号为 1~9 的 9 列列车,驶入的次序依次是 8,4,2,5,3,9,1,6,7。若期望驶出的次序依次为 1~9,则 n 至少是( )。

2016-3

A. 2

B. 3

C. 4

D. 5

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在确保队列先进先出原则的前提下。根据题意具体分析:入队顺序为 8, 4, 2, 5, 3, 9, 1, 6, 7,出队顺序为 1~9。入口和出口之间有多个队列(n 条轨道),且每个队列(轨道)可容纳多个元素(多列列车)。如此分析:显然先入队的元素必须小千后入队的元素(如果 8 和 4 入同一队列,8 在前 4 在后,那么出队时只能是 8 在前 4 在后),这样 8 入队列 1,4 入队列 2, 2 入队列 3,5 入队列 2(按照前面的原则“大的元素在小的元素后面”也可以将 5 入队列 3,但这时剩下的元素 3 就必须放到一个新的队列里面,无法确保”至少“,本应该是将 5 入队列 2,再将 3 入队列 3,不增加新队列的情况下,可以满足题意“至少”的要求),3 入队列 3,9 入队列 1,这时共占了 3 个队列,后面还有元素 1,直接再占用一个新的队列 4,1 从队列 4 出队后,剩下的元素 6 和 7 或者入队到队列 2 或者入队到队列 3(为简单起见我们不妨设 n 个队列的序号分别为 1, 2, …, n),这样就可以满足题目的要求。综上,共占用了 4 个队列。当然还有其他的入队出队的情况,请考生们自己推演。但要确保满足:O 队列中后面的元素大千前面的元素;@确保占用最少(即 满足题目中的“至少") 的队列。

正确答案:C

进入练习

第 4 题

数据结构
2 分

有一个 100 阶的三对角矩阵 M,其元素 mij,(1≤i≤100,1≤j≤100)按行优先依次压缩存入下标从 0 开始的一维数组 N 中。元素 m30, 30 在 N 中的下标是( )。

A. 86

B. 87

C. 88

D. 89

查看答案与解析收起答案与解析

参考答案:B

题目详解:
一个 n n 阶三对角矩阵只有主对角线及其相邻的两条对角线有非零元素,其余元素均为零。对于这样的矩阵,按行优先压缩存储时,非零元素的排列顺序如下:

  • 第 1 1 行:m1,1 m_{1,1} , m1,2 m_{1,2}
  • 第 2 2 行:m2,1 m_{2,1} , m2,2 m_{2,2} , m2,3 m_{2,3}
  • ...
  • 第 i i 行(1<i<n 1 < i < n ):mi,i−1 m_{i,i-1} , mi,i m_{i,i} , mi,i+1 m_{i,i+1}
  • 第 n n 行:mn,n−1 m_{n,n-1} , mn,n m_{n,n}

每一行最多有 3 3 个非零元素(除了第一行和最后一行)。对于元素 mi,j m_{i,j} ,其在压缩数组 N N 中的下标可以通过以下公式计算:

  1. 前 i−1 i-1 行的非零元素总数:

    • 第 1 1 行有 2 2 个元素。
    • 第 2 2 行到第 i−1 i-1 行,每行有 3 3 个元素。
    • 因此,前 i−1 i-1 行的非零元素总数为 2+3×(i−2) 2 + 3 \times (i-2) 。
  2. 当前行 i i 中,mi,j m_{i,j} 的位置偏移:

    • 如果 j=i−1 j = i-1 ,偏移为 0 0 。
    • 如果 j=i j = i ,偏移为 1 1 。
    • 如果 j=i+1 j = i+1 ,偏移为 2 2 。

综合以上两点,mi,j m_{i,j} 在 N N 中的下标为:

index=2+3×(i−2)+(j−i+1)−1\text{index} = 2 + 3 \times (i-2) + (j - i + 1) - 1

对于题目中的 m30,30 m_{30,30} :

  • i=30 i = 30 , j=30 j = 30 。
  • 前 29 29 行的非零元素总数为 2+3×(29−1)=2+84=86 2 + 3 \times (29 - 1) = 2 + 84 = 86 。
  • 当前行 30 30 中,j=i j = i ,因此偏移为 1 1 。
  • 所以 m30,30 m_{30,30} 的下标为 86+1=87 86 + 1 = 87 。

正确答案:B

进入练习

第 5 题

数据结构
2 分

若森林 F 有 15 条边、25 个结点,则 F 包含树的个数是( )。

A. 8

B. 9

C. 10

D. 11

查看答案与解析收起答案与解析

参考答案:C

题目详解:
森林 F F 由若干棵树组成,设森林中有 k k 棵树。对于一棵具有 n n 个结点和 m m 条边的树,满足 m=n−1 m = n - 1 。因此,对于整个森林 F F ,有以下关系:

  1. 森林的总边数为所有树的边数之和:
    ∑i=1kmi=15 \sum_{i=1}^{k} m_i = 15
  2. 森林的总结点数为所有树的结点数之和:
    ∑i=1kni=25 \sum_{i=1}^{k} n_i = 25
  3. 对于每棵树,满足 mi=ni−1 m_i = n_i - 1 ,因此:
    ∑i=1k(ni−1)=15 \sum_{i=1}^{k} (n_i - 1) = 15
    展开后得到:
    ∑i=1kni−∑i=1k1=25−k=15 \sum_{i=1}^{k} n_i - \sum_{i=1}^{k} 1 = 25 - k = 15
  4. 解方程:
    25−k=15  ⟹  k=10 25 - k = 15 \implies k = 10

因此,森林 F F 包含的树的个数是 10 10 。

正确答案:C

进入练习

第 6 题

数据结构
2 分

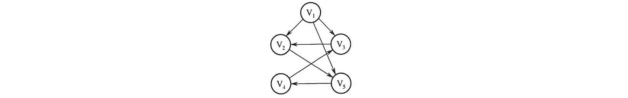
下列选项中,不是下图深度优先搜索序列的是( )。

2016-6

A. V1 , V2 , V4 , V3 , V2

B. V1 , V3 , V2 , V5 , V4

C. V1 , V2 , V 5, V4 , V3

D. V1 , V2 , V3 ,V4 , V5

查看答案与解析收起答案与解析

参考答案:D

题目详解:
对于本题,只需按深度优先遍历的策略进行遍历即可。对于选项A:先访问V1V_1,然后访问与V1V_1邻接且未被访问的任一顶点(满足的有V2V_2、V3V_3和V5V_5),此时访问V5V_5,然后从V5V_5出发,访问与V5V_5邻接且未被访问的任一顶点(满足的只有V4V_4),然后从V4V_4出发,访问与V4V_4邻接且未被访问的任一顶点(满足的只有V3V_3),然后从V3V_3出发,访问与V3V_3邻接且未被访问的任一顶点(满足的只有V2V_2),结束遍历。

选项B和C的分析方法与选项A相同,不再赘述。对于选项D,首先访问V1V_1,然后从V1V_1出发,访问与V1V_1邻接且未被访问的任一顶点(满足的有V2V_2、V3V_3和V5V_5),然后从V2V_2出发,访问与V2V_2邻接且未被访问的任一顶点(满足的只有V5V_5),按规则本应该访问V5V_5,但选项D却访问V3V_3,因此D错误。

进入练习

第 7 题

数据结构
2 分

若将 n 个顶点 e 条弧的有向图采用邻接表存储,则拓扑排序算法的时间复杂度是( )。

A. O(n)

B. O(n + e)

C. O(n2)

D. O(ne)

查看答案与解析收起答案与解析

参考答案:B

题目详解:
拓扑排序算法的时间复杂度主要取决于两个步骤:

  1. 计算每个顶点的入度:需要遍历所有顶点和所有弧。对于有 n n 个顶点和 e e 条弧的有向图,计算入度的时间复杂度为 O(n+e) O(n + e) 。

  2. 拓扑排序过程:使用队列(或栈)来管理入度为0的顶点。每个顶点和每条弧都会被处理一次。具体来说:

    • 每个顶点入队和出队一次,时间复杂度为 O(n) O(n) 。
    • 对于每条弧,需要将其指向的顶点的入度减1,并在入度减为0时入队,时间复杂度为 O(e) O(e) 。
    • 因此,拓扑排序过程的总时间复杂度为 O(n+e) O(n + e) 。

综上,整个拓扑排序算法的时间复杂度为 O(n+e) O(n + e) 。

正确答案:B

进入练习

第 8 题

数据结构
2 分

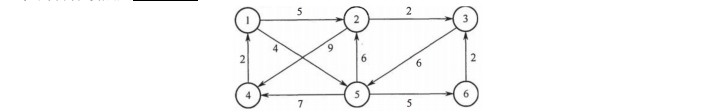
使用迪杰斯特拉(Dijkstra)算法求下图中从顶点 1 到其他各顶点的最短路径,依次得到的各最短路径的目标顶点是( )。

2016-8

A. 5, 2, 3, 4, 6

B. 5, 2, 3, 6, 4

C. 5, 2, 4, 3, 6

D. 5, 2, 6, 3, 4

查看答案与解析收起答案与解析

参考答案:B

题目详解:
根据 Dijkstra 算法,从顶点 v1v_1 到其余各顶点的最短路径如下表所示。

顶点 第1趟 第2趟 第3趟 第4趟 第5趟
v2v_2 5 (v1→v2v_1→v_2) 5 (v1→v2v_1→v_2) 5 (v1→v2v_1→v_2) 5 (v1→v2v_1→v_2) 5 (v1→v2v_1→v_2)
v3v_3 ∞\infty ∞\infty 7 (v1→v2→v3v_1→v_2→v_3) 7 (v1→v2→v3v_1→v_2→v_3) 7 (v1→v2→v3v_1→v_2→v_3)
v4v_4 ∞\infty 11 (v1→v5→v4v_1→v_5→v_4) 11 (v1→v5→v4v_1→v_5→v_4) 11 (v1→v5→v4v_1→v_5→v_4) 11 (v1→v5→v4v_1→v_5→v_4)
v5v_5 4 (v1→v5v_1→v_5) 4 (v1→v5v_1→v_5) 4 (v1→v5v_1→v_5) 4 (v1→v5v_1→v_5) 4 (v1→v5v_1→v_5)
v6v_6 ∞\infty 9 (v1→v5→v6v_1→v_5→v_6) 9 (v1→v5→v6v_1→v_5→v_6) 9 (v1→v5→v6v_1→v_5→v_6) 9 (v1→v5→v6v_1→v_5→v_6)
集合S {1,5} {1,5,2} {1,5,2,3} {1,5,2,3,6} {1,5,2,3,6,4}

【说明】

  1. 表中每个单元格包含路径长度和对应的最短路径
  2. ∞\infty 表示初始时不可达
  3. 集合S表示每趟处理后已确定最短路径的顶点集合

正确答案:B

进入练习

第 9 题

数据结构
2 分

在有 n(n>1000)个元素的升序数组 A 中查找关键字 x。查找算法的伪代码如下所示。本算法与折半查找算法相比,有可能具有更少比较次数的情形是

cpp
k=0;
while(k<n且 A[k]<x) k=k+3;
if(k<n且 A[k]==x) 查找成功;
else if (k-1<n且 A[k-1]==x) 查找成功;
	else if(k-2<n且 A[k-2]==x) 查找成功;
		else查找失败;

A. 当 x 不在数组中

B. 当 x 接近数组开头处

D. 当 x 位于数组中间位置

C. 当 x 接近数组结尾处

查看答案与解析收起答案与解析

参考答案:B

题目详解:
此题为送分题。该程序采用跳跃式的顺利查找法查找升序数组中的 X, 显然是 x 越靠前,比较次数才会越少。

正确答案:B

进入练习

第 10 题

数据结构
2 分

B+树不同于 B 树的特点之一是( )。

A. 能支持顺序查找

B. 结点中含有关键字

C. 根结点至少有两个分支

D. 所有叶结点都在同一层上

查看答案与解析收起答案与解析

参考答案:A

题目详解:
B+树和 B 树的主要区别在于数据存储和查找方式:

  1. B+树的非叶子结点不存储数据,只作为索引使用,而 B 树的非叶子结点既存储关键字也存储数据。

  2. B+树的所有叶子结点通过指针链接形成一个有序链表,因此支持高效的顺序查找(范围查询),而 B 树的叶子结点是独立的,不支持顺序查找。这是选项 A 正确的原因。

  3. 选项 B(结点中含有关键字)是 B 树和 B+树的共同特点,两者都包含关键字。

  4. 选项 C(根结点至少有两个分支)也是 B 树和 B+树的共同性质。

  5. 选项 D(所有叶结点都在同一层上)是 B 树和 B+树的平衡特性,并非区别。

因此,B+树不同于 B 树的特点之一是 能支持顺序查找。

正确答案:A

进入练习

第 11 题

数据结构
2 分

对 10TB 的数据文件进行排序,应使用的方法是( )。

A. 希尔排序 B. 堆排序

C. 快速排序

D. 归并排序

查看答案与解析收起答案与解析

参考答案:D

题目详解:
对于大规模数据(如 10TB)的排序,需要考虑以下几个关键因素:

  1. 外部排序:由于数据量远超过内存容量,必须使用外部排序算法,即能够处理存储在外部存储设备(如硬盘)上的数据的算法。归并排序是典型的外部排序算法,因为它可以高效地将多个已排序的子文件合并成一个有序文件。

  2. 时间复杂度:归并排序的时间复杂度为 O(nlog⁡n) O(n \log n) ,且其性能稳定,适合大规模数据。

  3. I/O 操作:归并排序通过分块读取数据、排序并合并的方式,减少了磁盘 I/O 操作的次数,从而提高了效率。

  4. 其他选项分析:

    • 希尔排序(A):是插入排序的改进版,但仅适用于内存中的排序,无法处理外部数据。
    • 堆排序(B):虽然时间复杂度为 O(nlog⁡n) O(n \log n) ,但同样需要全部数据加载到内存中,不适合外部排序。
    • 快速排序(C):平均时间复杂度为 O(nlog⁡n) O(n \log n) ,但最坏情况下为 O(n2) O(n^2) ,且不适合外部数据。

因此,归并排序(D)是唯一适合 10TB 数据排序的方法。

正确答案:D

进入练习

第 12 题

计算机组成原理
2 分

将高级语言源程序转换为机器级目标代码文件的程序是( )。

A. 汇编程序

B. 链接程序

C. 编译程序

D. 解释程序

查看答案与解析收起答案与解析

参考答案:C

题目详解:
将高级语言源程序转换为机器级目标代码文件的程序是 编译程序。以下是详细解释:

  1. 高级语言源程序:这是由程序员编写的、使用高级编程语言(如C、Java等)的代码,人类可读但计算机无法直接执行。

  2. 机器级目标代码:这是计算机可以直接执行的二进制代码,通常以目标文件(如 .obj 或 .o 文件)的形式存在。

  3. 转换过程:

    • 编译程序(Compiler):将高级语言源程序 整体 翻译成机器级目标代码,生成目标文件。这是题目描述的转换过程。
    • 解释程序(Interpreter):逐行翻译并执行高级语言代码,不生成目标文件。
    • 汇编程序(Assembler):将汇编语言程序转换为机器代码,不处理高级语言。
    • 链接程序(Linker):将多个目标文件合并为可执行文件,不参与源代码到目标代码的转换。

因此,正确答案是 C. 编译程序。

进入练习

第 13 题

计算机组成原理
2 分

有如下 C 语言程序段,执行上述两条语句后,usi 的值为( )。

cpp
short si = -32767;
unsigned short usi = si;

A. -32767

B. 32767

C. 32768

D. 32769

查看答案与解析收起答案与解析

参考答案:D

题目详解:
在C语言中,当将一个有符号短整型(short)变量赋值给一个无符号短整型(unsigned short)变量时,会发生二进制表示的重新解释。具体步骤如下:

  1. short si = -32767; 的二进制表示:

    • short 是16位有符号整数,范围是 −32768 -32768 到 32767 32767 。
    • −32767-32767 的二进制补码表示为 1000 0000 0000 0001 1000\ 0000\ 0000\ 0001 (最高位为符号位,1表示负数)。
  2. 将 si 赋值给 usi 时,二进制表示保持不变,但会被解释为无符号整数:

    • 无符号整数的解释方式是直接计算二进制对应的十进制值。
    • 1000 0000 0000 0001 1000\ 0000\ 0000\ 0001 的无符号值为:
      1×215+0×214+⋯+0×21+1×20=32768+1=32769 1 \times 2^{15} + 0 \times 2^{14} + \cdots + 0 \times 2^{1} + 1 \times 2^{0} = 32768 + 1 = 32769

因此,usi 的值为 32769 32769 。

正确答案:D

进入练习

第 14 题

计算机组成原理
2 分

计算机字长为 32 位,按字节编址,采用小端(Little Endian)方式存放数据。假定有一个 double型变量,其机器数表示为 1122 3344 5566 7788H,存放在 0000 8040H 开始的连续存储单元中,则存储单元 0000 8046H 中存放的是( )。

A. 22H

B. 33H

C. 77H

D. 66H

查看答案与解析收起答案与解析

参考答案:A

题目详解:
在计算机系统中,小端(Little Endian)方式是指数据的低字节存放在低地址,高字节存放在高地址。double 型变量占用 8 个字节(64 位),其机器数表示为 1122 3344 5566 7788H 1122\ 3344\ 5566\ 7788H ,按字节从低到高排列为 88H, 77H, 66H, 55H, 44H, 33H, 22H, 11H 88H,\ 77H,\ 66H,\ 55H,\ 44H,\ 33H,\ 22H,\ 11H 。

存储单元 0000 8040H 0000\ 8040H 开始的连续 8 个字节存放的数据如下:

  • 0000 8040H 0000\ 8040H :88H 88H
  • 0000 8041H 0000\ 8041H :77H 77H
  • 0000 8042H 0000\ 8042H :66H 66H
  • 0000 8043H 0000\ 8043H :55H 55H
  • 0000 8044H 0000\ 8044H :44H 44H
  • 0000 8045H 0000\ 8045H :33H 33H
  • 0000 8046H 0000\ 8046H :22H 22H
  • 0000 8047H 0000\ 8047H :11H 11H

题目问的是存储单元 0000 8046H 0000\ 8046H 中存放的数据,根据上述排列,该地址存放的是 22H 22H 。

正确答案:A

进入练习

第 15 题

计算机组成原理
2 分

有如下 C 语言程序段:

cpp
for(k=0; k<1000; k++)
	a[k] = a[k]+32

若数组 a 及变量 k 均为 int 型,int 型数据占 4B,数据 Cache 采用直接映射方式,数据区大小为1KB、块大小为 16B,该程序段执行前 Cache 为空,则该程序段执行过程中访问数组 a 的 Cache缺失率约为( )。

A. 1.25%

B. 2.5%

C. 12.5%

D. 25%

查看答案与解析收起答案与解析

参考答案:C

题目详解:
分析语句 a[k] = a[k] + 32 的 Cache 访问情况:

  1. 该语句需要两次访问 a[k]:第一次读取 a[k] 的值,第二次写入修改后的值。

  2. 假设 Cache 块大小为 4 个整数(16字节),则每次缺失会载入包含 a[k] 的整块数据(a[k] 及其后 3 个元素)。

  3. 访问模式:

    • 第一次访问 a[k] 时发生 Cache 缺失,载入整个块
    • 后续 7 次访问(包括当前块的 3 个相邻元素和第二次写回)都会命中
  4. 缺失率计算:

    • 总访问次数:8 次(4 个元素 × 2 次访问)
    • 缺失次数:1 次
    • 缺失率 = 1/8 = 12.5%

【关键点】

  • 空间局部性得到充分利用
  • 块大小直接影响缺失率
  • 写操作也遵循相同缓存规则

正确答案:C

进入练习

第 16 题

计算机组成原理
2 分

某存储器容量为 64KB,按字节编址,地址 4000H~5FFFH 为 ROM 区,其余为 RAM 区。若采用 8K×4 位的 SRAM 芯片进行设计,则需要该芯片的数量是( )。

A. 7

B. 8 C. 14

D. 16

查看答案与解析收起答案与解析

参考答案:C

题目详解:
存储器总容量为 64KB 64KB ,按字节编址,地址范围为 0000H∼FFFFH 0000H \sim FFFFH 。

  1. 计算 ROM 区的容量:

    • ROM 区的地址范围为 4000H∼5FFFH 4000H \sim 5FFFH 。
    • 计算地址范围的大小:
      5FFFH−4000H+1=1FFFH+1=2000H 5FFFH - 4000H + 1 = 1FFFH + 1 = 2000H
    • 将 2000H 2000H 转换为十进制:
      2000H=2×163=8192字节=8KB 2000H = 2 \times 16^3 = 8192 \text{字节} = 8KB
  2. 计算 RAM 区的容量:

    • RAM 区的容量为总容量减去 ROM 区的容量:
      64KB−8KB=56KB 64KB - 8KB = 56KB
  3. 计算所需的 SRAM 芯片数量:

    • 每个 SRAM 芯片的容量为 8K×4 8K \times 4 位,即 8K×0.5 8K \times 0.5 字节 = 4KB 4KB 。
    • 需要的芯片数量为 RAM 区容量除以单个芯片容量:
      56KB4KB=14 \frac{56KB}{4KB} = 14

正确答案:C

进入练习

第 17 题

计算机组成原理
2 分

某指令格式如下所示。其中 M 为寻址方式,I 为变址寄存器编号,D 为形式地址。若采用先变址后间址的寻址方式,则操作数的有效地址是( )。

2016-17

A. I + D

B. (I) + D

C. ((I) + D)

D. ((I)) + D

查看答案与解析收起答案与解析

参考答案:C

题目详解:
在变址寻址方式中,有效地址 EAEA 等于指令字中的形式地址 DD 与变址寄存器 II 的内容相加之和,即 EA=(I)+DEA = (I) + D。间接寻址是相对于直接寻址而言的,指令的地址字段给出的形式地址不是操作数的真正地址,而是操作数地址的地址,即 EA=(D)EA = (D)。因此该操作数的有效地址是 ((I)+D)((I) + D)​。

正确答案:C

进入练习

第 18 题

计算机组成原理
2 分

某计算机主存空间为 4GB,字长为 32 位,按字节编址,采用 32 位字长指令字格式。若指令按字边界对齐存放,则程序计数器(PC)和指令寄存器(IR)的位数至少分别是( )。

A. 30、30

B. 30、32

C. 32、30

D. 32、32

查看答案与解析收起答案与解析

参考答案:B

题目详解:
主存空间为 4GB,按字节编址,因此地址总位数为 log⁡2(4×230)=32 \log_2(4 \times 2^{30}) = 32 位。由于字长为 32 位(即 4 字节),且指令按字边界对齐存放,因此指令地址的最低 2 位恒为 0(因为每个字占 4 字节,地址为 4 的倍数)。因此,程序计数器(PC)只需表示高 30 位地址即可,最低 2 位无需存储,故 PC 的位数至少为 30 位。

指令寄存器(IR)用于存储指令字,指令字长为 32 位,因此 IR 的位数至少为 32 位。

综上所述,PC 和 IR 的位数至少分别为 30 位和 32 位。

正确答案:B

进入练习

第 19 题

计算机组成原理
2 分

在无转发机制的五段基本流水线(取指、译码/读寄存器、运算、访写回寄存器)中,下列指令序列存在数据冒险的指令对是( )。

I1:add R1, R2, R3; (R2) + (R3)→R1

I2:add R5, R2, R4; (R2) + (R4)→R5

I3:add R4, R5, R3; (R5) + (R3)→R4

I4:add R5, R2, R6; (R2) + (R6)→R5

A. I1 和 12

B. I2 和 I3

C. I2 和 I4

D. I3 和 I4

查看答案与解析收起答案与解析

参考答案:B

题目详解:
在五段基本流水线中,数据冒险(Data Hazard)指的是由于指令之间的数据依赖关系,导致后续指令无法在正确的时钟周期内获取到所需的数据。具体来说,数据冒险可以分为以下三种类型:

  1. RAW(Read After Write):后续指令需要读取前一条指令写入的数据。
  2. WAR(Write After Read):后续指令写入前一条指令需要读取的数据。
  3. WAW(Write After Write):后续指令写入前一条指令也写入的数据。

在无转发机制的流水线中,RAW 冒险是最常见的问题。我们需要分析指令之间的数据依赖关系,判断是否存在 RAW 冒险。

给定的指令序列如下:

  • I1:add R1, R2, R3 \text{add R1, R2, R3} // (R2) + (R3) → R1 \text{(R2) + (R3) → R1}
  • I2:add R5, R2, R4 \text{add R5, R2, R4} // (R2) + (R4) → R5 \text{(R2) + (R4) → R5}
  • I3:add R4, R5, R3 \text{add R4, R5, R3} // (R5) + (R3) → R4 \text{(R5) + (R3) → R4}
  • I4:add R5, R2, R6 \text{add R5, R2, R6} // (R2) + (R6) → R5 \text{(R2) + (R6) → R5}

我们逐一分析选项中的指令对:

选项 B:I2 和 I3

  • I2 写入寄存器 R5 \text{R5} ,而 I3 需要读取 R5 \text{R5} 。
  • I2 的写回阶段在时钟周期 5,而 I3 的译码/读寄存器阶段在时钟周期 2(假设 I3 紧接 I2)。
  • 由于无转发机制,I3 无法及时获取 I2 写入的 R5 \text{R5} 值,因此存在 RAW 冒险。

其他选项分析:

  • 选项 A:I1 和 I2
    • I1 写入 R1 \text{R1} ,但 I2 不读取 R1 \text{R1} ,因此不存在数据冒险。
  • 选项 C:I2 和 I4
    • I2 写入 R5 \text{R5} ,但 I4 不读取 R5 \text{R5} ,因此不存在数据冒险。
  • 选项 D:I3 和 I4
    • I3 写入 R4 \text{R4} ,但 I4 不读取 R4 \text{R4} ,因此不存在数据冒险。

综上所述,存在数据冒险的指令对是 I2 和 I3。

正确答案:B

进入练习

第 20 题

计算机组成原理
2 分

单周期处理器中所有指令的指令周期为一个时钟周期。下列关于单周期处理器的叙述中,错误的是( )。

A. 可以采用单总线结构数据通路

B. 处理器时钟频率较低

C. 在指令执行过程中控制信号不变

D. 每条指令的 CPI 为 1

查看答案与解析收起答案与解析

参考答案:A

题目详解:
单周期处理器是指所有指令的执行都在一个时钟周期内完成的设计。下面逐一分析各选项:

A. 单周期处理器通常采用 多总线结构 数据通路,因为需要在同一个时钟周期内完成指令的取指、译码、执行、访存和写回等多个操作。单总线结构无法满足这种并行操作的需求,会导致严重的结构冒险。因此该叙述是错误的。

B. 由于所有指令必须在一个时钟周期内完成,时钟周期长度由 最慢指令 的执行时间决定,因此时钟频率较低。该叙述正确。

C. 在单周期处理器中,控制信号在指令执行过程中是 固定不变 的,因为所有操作都在一个时钟周期内完成。该叙述正确。

D. CPI (Clock cycles Per Instruction) 是指令执行所需的时钟周期数。在单周期处理器中,每条指令的 CPI 确实为 1 1 。该叙述正确。

正确答案:A

进入练习

第 21 题

计算机组成原理
2 分

下列关于总线设计的叙述中,错误的是( )。

A. 并行总线传输比串行总线传输速度快

B. 采用信号线复用技术可减少信号线数量

C. 采用突发传输方式可提高总线数据传输率

D. 采用分离事务通信方式可提高总线利用率

查看答案与解析收起答案与解析

参考答案:A

题目详解:
并行总线传输和串行总线传输的速度不能简单比较,原因如下:

  1. 并行总线虽然可以同时传输多位数据(如 n n 位),但由于存在信号间干扰(串扰)和时钟偏移等问题,其时钟频率 fparallel f_{parallel} 往往较低。因此实际带宽为 n×fparallel n \times f_{parallel} 。

  2. 串行总线采用差分信号等技术,时钟频率 fserial f_{serial} 可以做到很高(如 USB 3.0 达到 5 GHz),虽然每次只传输 1 位数据,但总带宽 1×fserial 1 \times f_{serial} 可能超过并行总线。

其他选项分析:

  • B 正确:信号线复用(如地址/数据线复用)通过分时复用确实能减少物理信号线数量。
  • C 正确:突发传输(Burst Transfer)通过连续传输多个数据单元,减少了地址传输开销,提高了有效数据传输率。
  • D 正确:分离事务(Split Transaction)将请求和响应分离,避免总线空闲等待,提高了利用率。

正确答案:A

进入练习

第 22 题

计算机组成原理
2 分

异常是指令执行过程中在处理器内部发生的特殊事件,中断是来自处理器外部的请求事件。下列关于中断或异常情况的叙述中,错误的是( )。

A. “访存时缺页”属于中断

B. “整数除以 0”属于异常

C. “DMA 传送结束”属于中断

D. “存储保护错”属于异常

查看答案与解析收起答案与解析

参考答案:A

题目详解:
中断和异常是计算机系统中两种不同的事件类型:

  1. 中断(Interrupt)是由外部设备发出的请求,例如 I/O 完成、定时器到期等。中断是异步的,与当前执行的指令无关。常见的例子包括:

    • DMA 传送结束 \text{DMA 传送结束} (选项 C 正确)
    • 键盘输入 \text{键盘输入}
    • 网络数据到达 \text{网络数据到达}
  2. 异常(Exception)是由指令执行过程中在处理器内部检测到的特殊事件,通常是同步的,与当前执行的指令直接相关。常见的例子包括:

    • 整数除以 0 \text{整数除以 0} (选项 B 正确)
    • 存储保护错 \text{存储保护错} (选项 D 正确)
    • 缺页异常 \text{缺页异常}

选项 A 的错误在于:

  • “访存时缺页” \text{“访存时缺页”} 是由 CPU 执行访存指令时触发的异常(缺页异常),而不是由外部设备引发的中断。因此,它属于异常而非中断。

正确答案:A

进入练习

第 23 题

操作系统
2 分

下列关于批处理系统的叙述中,正确的是( )。

I. 批处理系统允许多个用户与计算机直接交互

II. 批处理系统分为单道批处理系统和多道批处理系统

III. 中断技术使得多道批处理系统和 I/O 设备可与 CPU 并行工作

A. 仅 II、III

B. 仅 II

C. 仅 I、II

D. 仅 I、III

查看答案与解析收起答案与解析

参考答案:A

题目详解:
批处理系统是一种计算机操作方式,用户将作业提交给系统后,由系统自动依次执行,期间无需用户干预。下面逐项分析:

I. 错误。批处理系统不允许用户与计算机直接交互,用户提交作业后,需等待作业完成才能获取结果。交互性是分时系统的特点。

II. 正确。批处理系统可分为:

  • 单道批处理系统:内存中仅有一道作业运行
  • 多道批处理系统:内存中同时存放多道作业,通过作业调度选择运行

III. 正确。中断技术是多道批处理系统的关键技术,它使得:

  • 当 I/OI/O 设备完成操作时,通过中断通知 CPUCPU
  • CPUCPU 可在 I/OI/O 操作期间执行其他任务
  • 实现了 CPUCPU 与 I/OI/O 设备的并行工作

因此,正确的叙述是 II 和 III。

正确答案:A

进入练习

第 24 题

操作系统
2 分

某单 CPU 系统中有输入和输出设备各 1 台,现有 3 个并发执行的作业,每个作业的输入、计算和输出时间均分别为 2ms、3ms 和 4ms,且都按输入、计算和输出的顺序执行,则执行完 3 个作业需要的时间最少是( )。

A. 15ms

B. 17ms

C. 22ms

D. 27ms

查看答案与解析收起答案与解析

参考答案:B

题目详解:
为了求解三个作业在单 CPU 系统中的最短完成时间,我们需要考虑作业的并发执行以及输入、计算和输出阶段的资源占用情况。系统中有以下资源限制:

  • 1 个 CPU(用于计算)
  • 1 台输入设备
  • 1 台输出设备

每个作业的执行顺序为:输入(2ms)→ 计算(3ms)→ 输出(4ms)。我们需要合理安排三个作业的执行顺序,以最小化总完成时间。

以下是三个作业的最优调度方案:

  1. 时间 0-2ms:

    • 作业 1 使用输入设备进行输入,占用 2ms。
    • 其他作业等待。
  2. 时间 2-4ms:

    • 作业 1 开始计算,占用 CPU 3ms(完成时间:5ms)。
    • 作业 2 开始输入,占用输入设备 2ms(完成时间:4ms)。
  3. 时间 4-5ms:

    • 作业 2 完成输入,等待 CPU。
    • 作业 3 开始输入,占用输入设备 2ms(完成时间:6ms)。
    • 作业 1 仍在计算(完成时间:5ms)。
  4. 时间 5-6ms:

    • 作业 1 完成计算,开始输出,占用输出设备 4ms(完成时间:9ms)。
    • 作业 2 开始计算,占用 CPU 3ms(完成时间:8ms)。
    • 作业 3 仍在输入(完成时间:6ms)。
  5. 时间 6-8ms:

    • 作业 3 完成输入,等待 CPU。
    • 作业 2 仍在计算(完成时间:8ms)。
    • 作业 1 仍在输出(完成时间:9ms)。
  6. 时间 8-9ms:

    • 作业 2 完成计算,等待输出设备(被作业 1 占用)。
    • 作业 3 开始计算,占用 CPU 3ms(完成时间:11ms)。
    • 作业 1 完成输出(时间 9ms)。
  7. 时间 9-11ms:

    • 作业 2 开始输出,占用输出设备 4ms(完成时间:13ms)。
    • 作业 3 仍在计算(完成时间:11ms)。
  8. 时间 11-13ms:

    • 作业 3 完成计算,等待输出设备(被作业 2 占用)。
    • 作业 2 仍在输出(完成时间:13ms)。
  9. 时间 13-17ms:

    • 作业 3 开始输出,占用输出设备 4ms(完成时间:17ms)。

最终,三个作业的总完成时间为 17ms 17ms 。

正确答案:B

进入练习

第 25 题

操作系统
2 分

系统中有 3 个不同的临界资源 R1 , R2 和 R3 ,被 4 个进程 p1 , p2 , p3 及 p4 共享。各进程对资源的需求为:p1 申请 R1 和 R2 ,p2 申请 R2 和 R3 ,p3 申请 R1 和 R3 ,p4 申请 R2 。若系统出现死锁,则处于死锁状态的进程数至少是( )。

A. 1

B. 2

C. 3

D. 4

查看答案与解析收起答案与解析

参考答案:C

题目详解:
要判断系统出现死锁时至少有多少个进程处于死锁状态,我们需要分析进程对资源的申请和占有情况。死锁的四个必要条件是:互斥条件、占有并等待、非抢占条件和循环等待条件。这里重点关注循环等待条件。

系统有 3 个临界资源 R1 R1 , R2 R2 和 R3 R3 ,被 4 个进程 p1 p1 , p2 p2 , p3 p3 及 p4 p4 共享。各进程对资源的需求如下:

  • p1 p1 申请 R1 R1 和 R2 R2
  • p2 p2 申请 R2 R2 和 R3 R3
  • p3 p3 申请 R1 R1 和 R3 R3
  • p4 p4 申请 R2 R2

为了形成死锁,必须存在一个进程循环等待链。我们需要找到最小的进程集合,使得这些进程的资源请求形成循环依赖。

考虑以下情况:

  1. 假设 p1 p1 占有 R1 R1 并请求 R2 R2 ,同时 p2 p2 占有 R2 R2 并请求 R3 R3 , p3 p3 占有 R3 R3 并请求 R1 R1 。此时 p1 p1 , p2 p2 , p3 p3 形成了一个循环等待链:p1→p2→p3→p1 p1 \rightarrow p2 \rightarrow p3 \rightarrow p1 。这种情况下,3 个进程处于死锁状态。
  2. 如果尝试只用 2 个进程形成死锁,比如 p1 p1 和 p2 p2 , p1 p1 需要 R2 R2 , p2 p2 需要 R3 R3 ,但 p2 p2 并不持有 R1 R1 ,因此无法形成循环等待链。类似地,其他两进程组合也无法满足循环等待条件。

因此,最少需要 3 个进程才能形成死锁。

正确答案:C

进入练习

第 26 题

操作系统
2 分

某系统采用改进型 CLOCK 置换算法,页表项中字段 A 为访问位,M 为修改位。A = 0 表示页最近没有被访问,A = 1 表示页最近被访问过。M=0 表示页没有被修改过,M=1 表示页被修改过。按(A, M)所有可能的取值,将页分为四类:(0, 0), (1, 0), (0, 1)和(1, 1),则该算法淘汰页的次序为( )。

A. (0, 0), (0, 1), (1, 0), (1, 1)

B. (0, 0), (1, 0), (0, 1), (1, 1)

C. (0, 0), (0, 1), (1, 1), (1, 0)

D. (0, 0), (1, 1), (1, 0), (0, 1)

查看答案与解析收起答案与解析

参考答案:A

题目详解:
改进型 CLOCK 置换算法(也称为二次机会算法)结合了访问位 A A 和修改位 M M 来决定页面置换的优先级。其核心思想是优先淘汰既未被访问又未被修改的页面,因为这类页面置换的开销最小。具体淘汰次序如下:

  1. 首先查找 (0,0) (0, 0) 类页面:这类页面最近未被访问且未被修改,是置换的最佳选择。
  2. 若没有 (0,0) (0, 0) 类页面,则查找 (0,1) (0, 1) 类页面:这类页面最近未被访问但被修改过,置换时需要写回磁盘,开销稍大。
  3. 若前两类均不存在,则查找 (1,0) (1, 0) 类页面:这类页面最近被访问过但未被修改,可能很快会被再次访问。
  4. 最后考虑 (1,1) (1, 1) 类页面:这类页面最近被访问且被修改过,置换开销最大。

因此,淘汰页的次序为: (0,0)→(0,1)→(1,0)→(1,1) (0, 0) \rightarrow (0, 1) \rightarrow (1, 0) \rightarrow (1, 1) 。

正确答案:A

进入练习

第 27 题

操作系统
2 分

使用 TSL(Test and Set Lock)指令实现进程互斥的伪代码如下所示。

cpp
do{
	…
	while(TSL(&lock));
    critical section;
    lock=FALSE
    …
}while(TRUE)

下列与该实现机制相关的叙述中,正确的是( )。

A. 退出临界区的进程负责唤醒阻塞态进程

B. 等待进入临界区的进程不会主动放弃 CPU

C. 上述伪代码满足“让权等待”的同步准则

D. while(TSL(&lock))语句应在关中断状态下执行

查看答案与解析收起答案与解析

参考答案:B

题目详解:
该题目考察的是使用 TSL(Test and Set Lock)指令实现进程互斥的原理及相关概念。下面逐项分析:

  1. TSL 指令的作用:
    TSL 是原子操作,它会测试并设置锁变量 $ lock $ 的值。如果 $ lock $ 为 $ FALSE $(表示锁可用),TSL 会将其设置为 $ TRUE $(表示锁被占用)并返回 $ FALSE $;如果 $ lock $ 为 $ TRUE $(表示锁被占用),TSL 会直接返回 $ TRUE $。

  2. 代码执行流程:

    • 进程通过 $ while(TSL(\&lock)) $ 循环忙等待,直到锁可用(即 $ TSL(\&lock) $ 返回 $ FALSE $)。
    • 进入临界区后执行代码,退出时将 $ lock $ 设为 $ FALSE $。
    • 由于是忙等待,等待的进程不会主动放弃 CPU,而是持续占用 CPU 轮询锁状态。
  3. 选项分析:

    • A:错误。退出临界区的进程只是将 $ lock $ 设为 $ FALSE $,并未显式唤醒其他进程,其他进程是通过忙等待检测到锁可用。
    • B:正确。忙等待的进程会一直占用 CPU 轮询,不会主动放弃 CPU(即不会进入阻塞态)。
    • C:错误。“让权等待”指进程在等待时应释放 CPU,但这里是忙等待,不满足该准则。
    • D:错误。$ while(TSL(\&lock)) $ 不需要关中断,因为 TSL 本身是原子操作。

正确答案:B

进入练习

第 28 题

操作系统
2 分

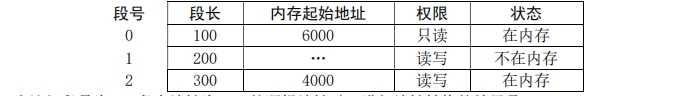
某进程的段表内容如下所示。当访问段号为 2、段内地址为 400 的逻辑地址时,进行地址转换的结果是( )。

2016-28

A. 段缺失异常

B. 得到内存地址 4400 C. 越权异常

D. 越界异常

查看答案与解析收起答案与解析

参考答案:D

题目详解:

  1. 理解段表的作用:

    • 段表用于将逻辑地址(段号 + 段内偏移)转换为物理地址。
    • 每个表项包含段长、内存起始地址、权限和状态等信息。
  2. 分析给定的逻辑地址:

    • 段号:2
    • 段内地址(偏移量):400
  3. 查找段号为2的表项:

    • 段长:300
    • 内存起始地址:4000
    • 权限:读写
    • 状态:在内存
  4. 检查段内地址是否合法:

    • 段内地址(偏移量)必须小于段长,否则会触发“越界异常”。
    • 本题中,段内地址为400,段长为300。
    • 400 > 300,因此偏移量超出了段的范围,属于“越界异常”。
  5. 排除其他选项:

    • A. 段缺失异常:状态为“在内存”,不会触发段缺失。
    • B. 得到内存地址4400:偏移量合法时,物理地址 = 内存起始地址 + 偏移量 = 4000 + 400 = 4400,但偏移量不合法。
    • C. 越权异常:权限为“读写”,题目未说明访问类型(读或写),但即使访问类型不匹配,也是先检查越界,再检查权限。
    • D. 越界异常:偏移量超出段长,直接触发越界异常。
  6. 优先级问题:

    • 地址转换时,先检查段是否在内存(状态),再检查偏移量是否越界,最后检查权限。
    • 因此越界异常的优先级高于越权异常。

正确答案:D

进入练习

第 29 题

操作系统
2 分

某进程访问页面的序列如下所示。若工作集的窗口大小为 6,则在 t 时刻的工作集为( )。

2016-29

A. {6, 0, 3, 2}

B. {2, 3, 0, 4}

C. {0, 4, 3, 2, 9}

D. {4, 5, 6, 0, 3, 2}

查看答案与解析收起答案与解析

参考答案:A

题目详解:
在任一时刻 tt,都存在一个集合 w(k,t)w(k,t) 包含最近 kk 次(本题窗口大小为 6)内存访问所访问过的页面,这个集合称为工作集。根据题目给出的最近 6 次页面访问序列 6、0、3、2、3、2,去除重复页面后得到的工作集为 {6,0,3,2}\{6, 0, 3, 2\}。

进入练习

第 30 题

操作系统
2 分

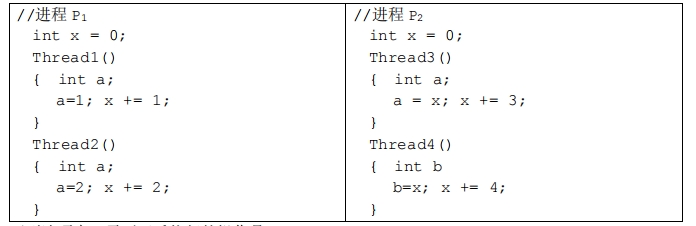
进程 P 和 P 均包含并发执行的线程,部分伪代码描述如下所示。下列选项中,需要互斥执行的操作是( )。

2016-30

A. a = 1 与 a = 2

B. a = x 与 b = x

C. x += 1 与 x += 2 D. x +=1 与 x+=3

查看答案与解析收起答案与解析

参考答案:C

题目详解:
P1 中对 a 进行赋值,并不影响最终的结果,故 a = l 与 a = 2 不需要互斥执行;a = x 与 b = x 执行先后不影响 a 与 b 的结果,无须互斥执行;x+=1 与 x+=2 执行先后会影响 x 的结果,需要互斥执行;P1 中的 x 和 P2 中的 x 是不同范围中的 X,互不影响,不需要互斥执行。

进入练习

第 31 题

操作系统
2 分

下列关于 SPOOLing 技术的叙述中,错误的是( )。

A. 需要外存的支持

B. 需要多道程序设计技术的支持

C. 可以让多个作业共享一台独占设备

D. 由用户作业控制设备与输入/输出井之间的数据传送

查看答案与解析收起答案与解析

参考答案:D

题目详解:
SPOOLing(Simultaneous Peripheral Operations On-Line)技术是一种通过外存和多道程序设计技术实现设备虚拟化的方法。其核心思想是将独占设备改造为共享设备,从而提高系统资源利用率。以下是各选项的分析:

  1. 选项A:SPOOLing 需要外存(如磁盘)作为输入井和输出井,用于缓存待处理的数据。因此,该叙述是正确的。

  2. 选项B:SPOOLing 依赖于多道程序设计技术,通过后台进程(如守护进程)管理设备的输入/输出操作,实现设备与作业的并行执行。因此,该叙述是正确的。

  3. 选项C:SPOOLing 的核心目标是通过虚拟化技术让多个作业共享一台独占设备(如打印机),从而避免设备空闲。因此,该叙述是正确的。

  4. 选项D:SPOOLing 的数据传送是由操作系统(而非用户作业)控制的。操作系统负责管理输入/输出井与设备之间的数据流动,用户作业无需直接参与。因此,该叙述是错误的。

正确答案:D

进入练习

第 32 题

操作系统
2 分

下列关于管程的叙述中,错误的是( )。

A. 管程只能用于实现进程的互斥

B. 管程是由编程语言支持的进程同步机制

D. 管程中定义的变量只能被管程内的过程访问

C. 任何时候只能有一个进程在管程中执行

查看答案与解析收起答案与解析

参考答案:A

题目详解:
管程(Monitor)是一种高级同步机制,用于实现进程间的互斥与同步。下面逐项分析:

  1. 选项A:错误。管程不仅可以实现进程互斥,还可以实现进程同步。管程内部的条件变量(condition variables)提供了同步机制,例如通过 wait 和 signal 操作。

  2. 选项B:正确。管程通常由编程语言(如Java、Pascal等)直接支持,编译器会负责实现管程的互斥访问机制。

  3. 选项D:正确。管程中定义的变量是局部变量,只能被管程内的过程(函数)访问,这体现了封装性。

  4. 选项C:正确。管程的特性决定了任何时候最多只有一个进程能在管程中执行,这是通过编译器自动插入的互斥锁实现的。

正确答案:A

进入练习

第 33 题

计算机网络
2 分

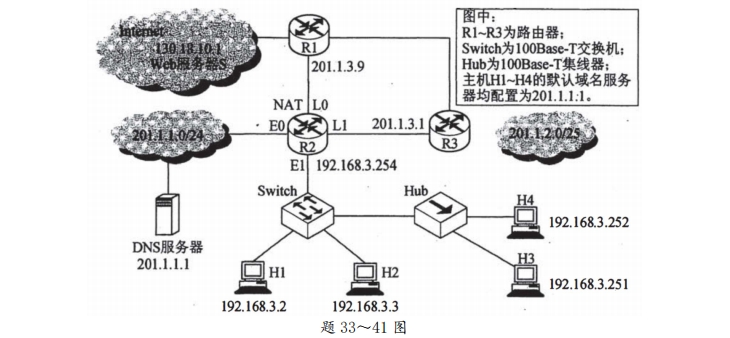
在 OSI 参考模型中,RI、Switch、Hub 实现的最高功能层分别是( )。

2016-33-41

A. 2、2、1

B. 2、2、2

C. 3、2、1

D. 3、2、2

查看答案与解析收起答案与解析

参考答案:C

题目详解:
本题考计算机网络设备,集线器是一个多端口的中继器,工作在物理层。以太网交换机是一个多端口的网桥,工作在数据链路层。路由器是网络层设备,它实现了网络模型的下三层,即物理层、数据链路层和网络层。题中 R1、Switch 和 Hub 分别是路由器、交换机和集线器,实现的最高层功能分别是网络层(即 3)、数据链路层(即 2)和物理层(即 1)。

正确答案:C

进入练习

第 34 题

计算机网络
2 分

若连接和 R3 链路的频率带宽为 8kHz,信噪比为 30dB,该链路实际数据传输速率约为理论最大数据传输速率的 50%。则该链路的实际数据传输速率约是( )。

2016-33-41

A. 8kbps

B. 20Kbps

C. 40kbps

D. 80kbps

查看答案与解析收起答案与解析

参考答案:C

题目详解:
根据香农定理,带宽受限且有高斯白噪声干扰的信道的极限数据传输速率定义为:
C=Wlog⁡2(1+SN)C = W \log_2(1 + \frac{S}{N})(单位:bps)

其中:

  • WW 为信道带宽(单位:Hz)
  • SN\frac{S}{N} 为信噪比(信号功率与噪声功率之比)
  • 信噪比(dB)表示为:10log⁡10(SN)10\log_{10}(\frac{S}{N})

当 SN=1000\frac{S}{N} = 1000 时:

  • 信噪比 = 10log⁡10(1000)=3010\log_{10}(1000) = 30 dB
  • 实际数据传输速率约为 50%×Wlog⁡2(1+SN)=50%×8k×log⁡2(1+1000)≈4050\% \times W\log_2(1 + \frac{S}{N}) = 50\% \times 8k \times \log_2(1 + 1000) \approx 40​ kbps

正确答案:C

进入练习

第 35 题

计算机网络
2 分

若主机 H2 向主机 H4 发送 1 个数据帧,主机 H4 向主机 H2 立即发送一个确认帧,则除 H4 外,从物理层上能够收到该确认帧的主机还有( )。

2016-33-41

A. 仅 H2 B. 仅 H3

C. 仅 H1、H2

D. 仅 H2、H3

查看答案与解析收起答案与解析

参考答案:D

题目详解:
交换机可以隔离冲突域,但集线器无法隔离冲突域,因此从物理层上能够收到该确认帧的主机仅 H2、H3, 选项 D 正确。

正确答案:D

进入练习

第 36 题

计算机网络
2 分

若 Hub 再生比特流过程中,会产生 1.535μs 延时,信号传播速度为 200m/μs,不考虑以太网帧的前导码,则 H3 与 H4 之间理论上可以相距的最远距离是( )。

2016-33-41

A. 200m

B. 205m

C. 359m

D. 512m

查看答案与解析收起答案与解析

参考答案:B

题目详解:
在计算H3与H4之间理论上可相距的最远距离时,需要考虑以下关键参数:

  1. 网络参数:
  • 采用100Base-T集线器(Hub),传输速率为100Mbps
  • 以太网规定最短帧长为64字节
  • 信号传播速度约为200m/μs
  1. 时延计算:
  • 帧传输时延:64B/100Mbps=5.12μs64B/100Mbps = 5.12μs
  • 为保证碰撞检测,往返时延应不超过帧传输时延,故单程时延上限为5.12μs/2=2.56μs5.12μs/2 = 2.56μs
  • Hub处理时延为1.535μs
  • 实际允许的传播时延:2.56μs−1.535μs=1.025μs2.56μs - 1.535μs = 1.025μs
  1. 最远距离计算:
  • 最大距离 = 传播速度 × 传播时延
  • 200m/μs×1.025μs=205m200m/μs × 1.025μs = 205m

因此,H3与H4之间理论上可以相距的最远距离为205米。这个计算确保了当两个站点同时发送数据时,能够在帧传输完成前检测到可能发生的碰撞。

正确答案:B

进入练习

第 37 题

计算机网络
2 分

假设 R1、R2、R3 采用 RIP 协议交换路由信息,且均己收敛。若 R3 检测到网络 201.1.2.0/25 不可达,并向通告一次新的距离向量,则 R2 更新后,其到达该网络的距离是( )。

2016-33-41

A. 2

B. 3

C. 16

D. 17

查看答案与解析收起答案与解析

参考答案:B

题目详解:
当R3检测到网络201.1.2.0/25不可达时,会将该网络的距离设置为16(距离16表示不可达)。R2从R3收到该路由信息后,由于R3到该网络的距离为16,R2理论上也应将该网络标记为不可达。但由于RIP协议"坏消息传得慢"的特性,此时R1尚未收到R3的路由更新,R1仍认为该网络可达(距离为2)。因此R2会记录通过R1的路径可达,计算距离为R1到该网络的距离2加上R2到R1的距离1,最终R2到该网络的距离为3。

[注] RIP协议的"坏消息传得慢"现象是指:当某条路由变为不可达时,该信息在网络中的传播速度较慢,导致路由器在一段时间内仍可能保持旧的、已失效的路由信息。

正确答案:B

进入练习

第 38 题

计算机网络
2 分

假设连接 R1、R2 和 R3 之间的点对点链路使用 201.1.3.x/30 地址,当 H3 访问 Web 服务器 S时,R2 转发出去的封装 HTTP 请求报文的 IP 分组的源 IP 地址和目的 IP 地址分别是( )。

2016-33-41

A. 192.168.3.251, 130.18.10.1

B. 192.168.3.251, 201.1.3.9

C. 201.1.3.8, 130.18.10.1

D. 201.1.3.10, 130.18.10.1

查看答案与解析收起答案与解析

参考答案:D

题目详解:
根据题目描述,连接R1、R2和R3之间的点对点链路使用201.1.3.x/30地址,其子网掩码为255.255.255.252。已知R1的一个接口IP地址为201.1.3.9,其二进制后8位为00001001(其中最后2位为主机号)。在/30子网中:

  1. 有效IP地址范围分析:
  • 主机号全0(00)表示网络地址(201.1.3.8)
  • 主机号01对应201.1.3.9(R1接口)
  • 主机号10对应201.1.3.10(可作为源IP地址)
  • 主机号全1(11)表示广播地址(201.1.3.11)
  1. 因此,除201.1.3.9外,只有201.1.3.10可作为源IP地址使用。题目中Web服务器的IP地址130.18.10.1作为目的IP地址。综上,选项D(源IP地址201.1.3.10,目的IP地址130.18.10.1)是正确的配置。

正确答案:D

进入练习

第 39 题

计算机网络
2 分

若 H1 与 H2 的默认网关和子网掩码均分别配置为 192.168.3.1 和 255.255.255.128,H3 和 H4 的默认网关和子网掩码均分别配置为 192.168.3.254 和 255.255.255.128,则下列现象中可能发生的是( )。

2016-33-41

A. H1 不能与 H2 进行正常 IP 通信

B. H2 与 H4 均不能访问 Internet

C. H1 不能与 H3 进行正常 IP 通信

D. H3 不能与 H4 进行正常 IP 通信

查看答案与解析收起答案与解析

参考答案:C

题目详解:
从子网掩码可知 H1 和 H2 处于同一网段,H3 和 H4 处于同一网段,分别可以进行正常的 IP 通信,A 和 D 错误。因为 R2 的 E1 接口的 IP 地址为 192.168.3.254192.168.3.254,而 H2 的默认网关为 192.168.3.1192.168.3.1,所以 H2 不能访问 Internet,而 H4 的默认网关为 192.168.3.254192.168.3.254,所以 H4 可以正常访问 Internet,B 错误。由 H1、H2、H3 和 H4 的子网掩码可知 H1、H2 和 H3、H4 处于不同的网段,需通过路由器才能进行正常的 IP 通信,而这时 H1 和 H2 的默认网关为 192.168.3.1192.168.3.1,但 R2 的 E1 接口的 IP 地址为 192.168.3.254192.168.3.254​,无法进行通信,从而 H1 不能与 H3 进行正常的 IP 通信。C 正确。

正确答案:C

进入练习

第 40 题

计算机网络
2 分

假设所有域名服务器均采用迭代查询方式进行域名解析。当 H4 访问规范域名为www.abc.xyz.com 的网站时,域名服务器 201.1.1.1 完成该域名解析过程中,可能发出 DNS 查询的最少和最多次数分别是( )。

2016-33-41

A. 0,3

B. 1,3

C. 0,4

D. 1,4

查看答案与解析收起答案与解析

参考答案:C

题目详解:
最少情况下:当本机DNS 缓存中存有该域名的 DNS 信息时,则不需要查询任何域名服务器,这样最少发出 00 次 DNS 查询。

最多情况下:因为均采用迭代查询的方式,在最坏的情况下,需要依次迭代地向本地域名服务器、根域名服务器 (.com)(.com)、顶级域名服务器 (xyz.com)(xyz.com)、权限域名服务器 (abc.xyz.com)(abc.xyz.com) 发出 DNS 查询请求,因此最多发出 44 次 DNS 查询。

进入练习

综合应用题

7 题 · 共 72 分

第 41 题

计算机网络
9 分

(9 分)假设图中的 H3 访问 Web 服务器 S 时,S 为新建的 TCP 连接分配了 20KB(K= 1024)的接收缓存,最大段长 MSS=1KB,平均往返时间 RTT = 200ms。H3 建立连接时的初始序号为 100,且持续以 MSS 大小的段向 S 发送数据,拥塞窗口初始阈值为 32KB;S 对收到的每个段进行确认,并通告新的接收窗口。假定 TCP 连接建立完成后,S 端的 TCP 接收缓存仅有数据存入而无数据取出。请回答下列问题。

2016-33-41

(1)在 TCP 连接建立过程中,H3 收到的 S 发送过来的第二次握手 TCP 段的 SYN 和 ACK 标志位的值分别是多少?确认序号是多少?

(2)H3 收到的第 8 个确认段所通告的接收窗口是多少?此时 H3 的拥塞窗口变为多少?H3 的发送窗口变为多少?

(3)当 H3 的发送窗口等于 0 时,下一个待发送的数据段序号是多少?H3 从发送第 1 个数据段到发送窗口等于 0 时刻为止,平均数据传输速率是多少(忽略段的传输延时)?

(4)若 H3 与 S 之间通信己经结束,在 t 时刻 H3 请求断开该连接,则从 t 时刻起,S 释放该连接的最短时间是多少?

查看答案与解析收起答案与解析

题目详解:
TCP 连接的建立过程为 三次握手:首先,H3 向 Wb 服务器 S 发出连接请求报文段,这时首部中的同步位 SYN=1SYN=1,ACK=0ACK=0,同时选择一个初始序号 seq=100seq=100。TCP 规定,SYNSYN 报文段(即 SYN=1SYN=1 的报文段)不能携带数据,但是要消耗一个序号。接着,S 收到连接请求报文段,为自己选择一个初始序号 seq=yseq=y,向 A 发送确认。这个报文段 SYN=1SYN=1、ACK=1ACK=1、seq=yseq=y,确认号 ackack 是 100+1=101100+1=101。它不能携带数据,但是也要消耗一个序号。最后,H3 收到 S 的确认报文段后,还要向 S 给出确认。这份确认报文段 SYN=0SYN=0、ACK=1ACK=1,确认号 ack=y+1ack=y+1,自己的序号 seq=101seq=101。因此,第二次握手 TCP 段的 SYN=1SYN=1、ACK=1ACK=1;确认序号是 101101。

题目规定 S 对收到的每个段(MSS 大小的段)进行确认,并通告新的接收窗口,而且 TCP 接收缓存仅有数据存入而无数据取出。H3 收到的第 8 个确认段所通告的接收窗口是 20−8=12KB20-8=12KB;在慢开始算法里,发送方 H3 先设置拥塞窗口 cwnd=1KBcwnd=1KB,接下来每收到一个对新报文段的确认就使发送方的拥塞窗口加 1KB1KB。H3 共收到 8 个确认段,所以此时 H3 的拥塞窗口变为 1+8=9KB1+8=9KB;发送窗口 =min⁡{拥塞窗口,接收窗口}= \min\{拥塞窗口, 接收窗口\},所以 H3 的发送窗口变为 min⁡{9,12}=9KB\min\{9,12\}=9KB。

TCP 是用字节作为窗口 和 序号 的单位。当 H3 的发送窗口等于 0KB0KB 时,也就是接收窗口等于 0KB0KB 时,下一个待发送段的序号是 20K+101=20×1024+101=2058120K+101=20×1024+101=20581;H3 从发送第 1 个段到发送窗口等于 0KB0KB 时刻为止,经过五个传输轮次,每个传输轮次的时间就是往返 RTTRTT,因此平均数据传输速率是 20KB/(5×200ms)=20KB/s=20∗1024∗8bit/s=163.84kbps20KB/(5×200ms)=20KB/s = 20 * 1024 * 8 bit / s =163.84 kbps。

通信结束后,H3 向 S 发送连接释放报文段。S 收到 H3 的连接释放报文段后,马上发出确认报文段。此时 S 已经没有数据需要传输,于是它也马上发出连接释放报文段。H3 在收到 S 的连接释放报文段后,发出确认报文段。S 在收到这份确认后就释放 TCP 连接。因此从 tt 时刻起,S 释放该连接的最短时间是:H3 的连接释放报文段传送到 S 的时间 + S 的连接释放报文段传送到 H3 的时间 + H3 的确认报文段传送到 S 的时间 =1.5×200ms=300ms= 1.5×200ms = 300ms。

进入练习

第 42 题

数据结构
8 分

(8 分)如果一棵非空 k(k≥2)叉树 T 中每个非叶结点都有 k 个孩子,则称 T 为正则 k 叉树。请回答下列问题并给出推导过程。

(1)若 T 有 m 个非叶结点,则 T 中的叶结点有多少个?

(2)若 T 的高度为 h(单结点的树 h = 1),则 T 的结点数最多为多少个?最少为多少个?

查看答案与解析收起答案与解析

题目详解:
根据定义,正则 kk 叉树中仅含有两类结点:叶结点(个数记为 n0n_0)和度为 kk 的分支结点(个数记为 n1n_1)。树 TT 中的结点总数 n=n0+nk=n0+mn = n_0 + n_k = n_0 + m。树中所含的边数 e=n−1e = n - 1,这些边均为 mm 个度为 kk 的结点发出的,即 e=mke = mk。整理得 n0+m=mk+1n_0 + m = mk + 1,故 n0=(k−1)m+1n_0 = (k-1)m + 1。

高度为 hh 的正则 kk 叉树 TT 中,含最多结点的树形为:除第 hh 层外,第 11 层到第 h−1h-1 层的结点都是度为 kk 的分支结点;而第 hh 层均为叶结点,即树是“满”树。此时第 jj(1≤j≤h1 \le j \le h)层结点数为 kj−1k^{j-1},结点总数 M1M_1 为

M1=∑i=0hkj−1=kh−1k−1M_1 = \sum_{i=0}^{h} k^{j-1} = \frac{k^h - 1}{k - 1}

含最少结点的正则 KK 叉树的树形为:第 11 层只有根结点,第 22 层到第 h−1h-1 层仅含 11 个分支结点和 k−1k-1 个叶结点,第 hh 层有 KK 个叶结点。即除根外第 22 层到第 hh 层中每层的结点数均为 kk,故 TT 中所含结点总数 M2M_2 为

M2=1+(h−1)kM_2 = 1 + (h-1)k

【评分说明】①参考答案仅给出一种推导过程,若考生采用其他推导方法且正确,同样给分。②若考生仅给出结果,但没有推导过程,则 (1)、(2) 的最高得分分别是 22 分和 33 分。若推导过程或答案不完全正确,酌情给分。

进入练习

第 43 题

数据结构
15 分

(15 分)已知由 n(n≥2)个正整数构成的集合 A = {ak | 0≤k<n},将其划分为两个不相交的子集 A1 和 A2 ,元素个数分别是 n1 和 n2 ,A1 和 A2 中元素之和分别为 S1 和 S2 。设计一个尽可能高效的划分算法,满足|n1 – n2 |最小且|S1 – S2|最大。要求:

(1)给出算法的基本设计思想。

(2)根据设计思想,采用 C 或 C++语言描述算法,关键之处给出注释。

(3)说明你所设计算法的平均时间复杂度和空间复杂度。

查看答案与解析收起答案与解析

题目详解:
由题意知,将最小的 ⌊n/2⌋\lfloor n/2 \rfloor个元素放在 A1A_1 中,其余的元素放在 A2A_2 中,分组结果即可满足题目要求。仿照快速排序的思想,基于枢轴将个整数划分为两个子集。根据划分后枢轴所处的位置 ii 分别处理:

  • 若 i=⌊n/2⌋i = \lfloor n/2 \rfloor,则分组完成,算法结束;
  • 若 i<⌊n/2⌋i < \lfloor n/2 \rfloor,则枢轴及之前的所有元素均属于 A1A_1,继续对 ii 之后的元素进行划分;
  • 若 i>⌊n/2⌋i > \lfloor n/2 \rfloor,则枢轴及之后的所有元素均属于 A2A_2,继续对 ii 之前的元素进行划分;

基于该设计思想实现的算法,无须对全部元素进行全排序,其平均时间复杂度是 O(n)O(n),空间复杂度是 O(1)O(1)。

实现参考快速排序的单向递归算法。

c
int partition(int a[], int low, int high) {
  int l = low;
  int r = high;
  int pivot = a[l];
  while (l < r) {
    while (l < r && a[r] >= pivot) {
      r--;
    }
    a[l] = a[r];
    while (l < r && a[l] <= pivot) {
      l++;
    }
    a[r] = a[l];
  }
  a[l] = pivot;
  return l;
}

// 按照第 k 个元素进行分区
void quickSelect(int a[], int low, int high, int k) {
  if (low < high) {
    int pivotIndex = partition(a, low, high);
    if (pivotIndex == k) {
      return
    } else if (pivotIndex < k) {
      quickSelect(a, pivotIndex+1, high, k);
    } else {
      quickSelect(a, low, pivotIndex-1, k);
    }
  }
}

// 空间复杂度:O(1)
// 时间复杂度:O(n)
int solve(int a[], int n) {
  quickSelect(a, 0, n-1, n/2);
  int S1 = 0;
  int S2 = 0;
  for (int i = 0; i < n/2; i++) {
    S1 += a[i];
  }
  for (int i = n/2; i < n; i++) {
    S2 += a[i];
  }
  return S2 - S1;
}

本参考答案给出的算法平均时间复杂度是O(n)O(n), 空间复杂度是 O(1)O(1)。

进入练习

第 44 题

计算机组成原理
12 分

(9 分)假定 CPU 主频为 50MHz,CPI 为 4。设备 D 采用异步串行通信方式向主机传送 7 位ASCII 字符,通信规程中有 1 位奇校验位和 1 位停止位,从 D 接收启动命令到字符送入 I/O 端口需要 0.5ms。请回答下列问题,要求说明理由。

2016-44

(1)每传送一个字符,在异步串行通信线上共需传输多少位?在设备 D 持续工作过程中,每秒钟最多可向 I/O 端口送入多少个字符?

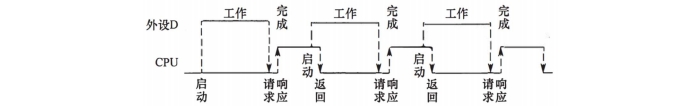
(2)设备 D 采用中断方式进行输入/输出,示意图如下。I/O 端口每收到一个字符申请一次中断,中断响应需 10 个时钟周期,中断服务程序共有 20 条指令,其中第 15 条指令启动 D 工作。若 CPU 需从 D 读取 1000 个字符,则完成这一任务所需时间大约是多少个时钟周期?CPU 用于完成这一任务的时间大约是多少个时钟周期?在中断响应阶段 CPU 进行了哪些操作?

查看答案与解析收起答案与解析

题目详解:
每传送一个 ASCII 字符,需要传输的位数有 1 位起始位、7 位数据位(ASCII 字符占 7 位)、1 位奇校验位和 1 位停止位,故总位数为 1+7+1+1=101 + 7 + 1 + 1 = 10。(2 分)I/O 端口每秒钟最多可接收 1000/0.5=20001000/0.5 = 2000 个字符。(1 分)

一个字符传送时间包括:设备 D 将字符送 I/O 端口的时间、中断响应时间和中断服务程序前 15 条指令的执行时间。时钟周期为 1/(50MHz)=20ns1/(50MHz)=20ns,设备 D 将字符送 I/O 端口的时间为 0.5ms/20ns=2.5×1040.5ms/20ns=2.5×10^4 个时钟周期。一个字符的传送时间大约为 2.5×10⁴+10+15×4=250702.5×10^4+10+15×4=25070 个时钟周期。完成 1000 个字符传送所需时间大约为 1000×25070=250700001000×25070=25070000 个时钟周期。(3 分)

CPU 用于该任务的时间大约为 1000×(10+20×4)=9×1041000×(10+20×4)=9×10^4 个时钟周期。(1 分)

在中断响应阶段,CPU 主要进行以下操作:关中断、保护断点和程序状态、识别中断源。(2 分)

【评分说明】

①位于第一问,若答案是 25070020,则同样给分;若答案是 25000000 或 25000020,则给 2 分。如果没有给出分布计算步骤,但算式和结果正确,同样给分。

②对于第三问,只要回答关中断和保护断点,就给 2 分,其他答案酌情给分。

进入练习

第 45 题

计算机组成原理
13 分

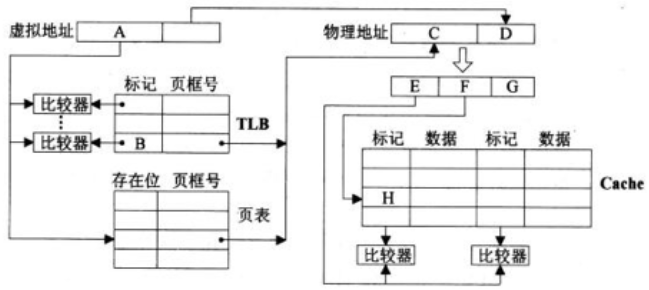
(14 分)某计算机采用页式虚拟存储管理方式,按字节编址,虚拟地址为 32 位,物理地址为 24位,页大小为 8KB;TLB 采用全相联映射:Cache 数据区大小为 64KB,按 2 路组相联方式组织,主存块大小为 64B。存储访问过程的示意图如下。请回答下列问题。

2016-45

(1)图中字段 A~G 的位数各是多少?TLB 标记字段 B 中存放的是什么信息?

(2)将块号为 4099 的主存块装入到 Cache 中时,所映射的 Cache 组号是多少?对应的 H字段内容是什么?

(3)Cache 缺失处理的时间开销大还是缺页处理的时间开销大?为什么?

(4)为什么 cache 可以采用直写(Write Through)策略,而修改页面内容时总是采用回写(Write Back)策略。

查看答案与解析收起答案与解析

题目详解:
页大小为 8KB,页内偏移地址为 13 位,故 A=B=32−13=19A = B = 32 - 13 = 19;D=13D = 13;C=24−13=11C = 24 - 13 = 11;主存块大小为 64B,故 G=6G = 6。2 路组相联,每组数据区容量有 64B×2=128B64B \times 2 = 128B,共有 64KB/128B=51264KB / 128B = 512 组,故 F=9F = 9;E=24−G−F=24−6−9=9E = 24 - G - F = 24 - 6 - 9 = 9。

因而 A=19A=19,B=19B=19,C=11C=11,D=13D=13,E=9E=9,F=9F=9,G=6G=6。(各 1 分,共 7 分)

TLB 中标记字段 BB 的内容是虚页号,表示该 TLB 项对应哪个虚页的页表项。(1 分)

块号 4099=000001000000000011B4099=000001000000000011B,因此,所映射的 Cache 组号为 000000011B=3000000011B=3,(1 分)对应的 HH 字段内容为 000001000B000001000B。(1 分)

Cache 缺失带来的开销小,而处理缺页的开销大。(1 分)因为缺页处理需要访问磁盘,而 Cache 缺失只要访问主存。(1 分)

因为采用直写法时需要同时写快速存储器和慢速存储器,而写磁盘比写主存慢很多,所以,在 Cache-主存层次,Cache 可以采用直写策略,而在主存 - 外存(磁盘)层次,修改页面内容时总是采用回写法。(2 分)

进入练习

第 46 题

操作系统
6 分

(6 分)某进程调度程序采用基于优先数(priority)的调度策略,即选择优先数最小的进程运行,进程创建时由用户指定一个 nice 作为静态优先数。为了动态调整优先数,引入运行时间cpuTime 和等待时间 waitTime,初值均为 0。进程处于执行态时,cpuTime 定时加 1,且waitTime 置 0;进程处于就绪态时,cpuTime 置 0,waitTime 定时加 1。请回答下列问题。

(1)若调度程序只将 nice 的值作为进程的优先数,即 priority = nice,则可能会出现饥饿现象,为什么?

(2)使用 nice、cpuTime 和 waitTime 设计一种动态优先数计算方法,以避免产生饥饿现象,并说明 waitTime 的作用。

查看答案与解析收起答案与解析

题目详解:
由于采用了静态优先数,当就绪队列中总有优先数较小的进程时,优先数较大的进程一直没有机会运行,因而会出现饥饿现象。

优先数 prioritypriority 的计算公式为 priority=nice+k1×cpuTime−k2×waitTimepriority = nice + k1 \times cpuTime - k2 \times waitTime,其中 k1>0k1 > 0,k2>0k2 > 0,用来分别调整 cpuTimecpuTime 和 waitTimewaitTime 在 prioritypriority 中所占的比例。waitTimewaitTime 可使长时间等待的进程优先数减少,从而避免出现饥饿现象。

公式中包含 nicenice,利用 cpuTimecpuTime 增大优先数,利用 waitTimewaitTime 减少优先数;部分正确,酌情给分。若给出包含 nicenice、cpuTimecpuTime 和 waitTimewaitTime 的其他合理的优先数计算方法,同样给分。

进入练习

第 47 题

操作系统
9 分

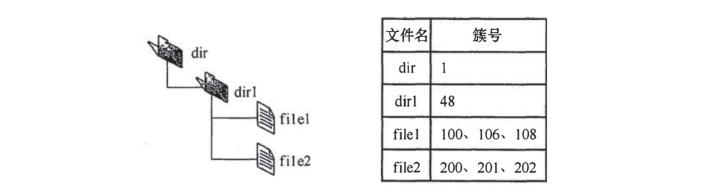
(9 分)某磁盘文件系统使用链接分配方式组织文件,簇大小为 4KB。目录文件的每个目录项包括文件名和文件的第一个簇号,其他簇号存放在文件分配表 FAT 中。

(1)假定目录树如下图所示,各文件占用的簇号及顺序如下表所示,其中 dir、dir1 是目录,file1、file2 是用户文件。请给出所有目录文件的内容。

2016-47

(2)若 FAT 的每个表项仅存放簇号,占 2 字节,则 FAT 的最大长度为多少字节?该文件系统支持的文件长度最大是多少?

(3)系统通过目录文件和 FAT 实现对文件的按名存取,说明 file1 的 106、108 两个簇号分别存放在 FAT 的哪个表项中。

(4)假设仅 FAT 和 dir 目录文件己读入内存,若需将文件 dir/dir1/file1 的第 5000 个字节读入内存,则要访问哪几个簇?

查看答案与解析收起答案与解析

题目详解:
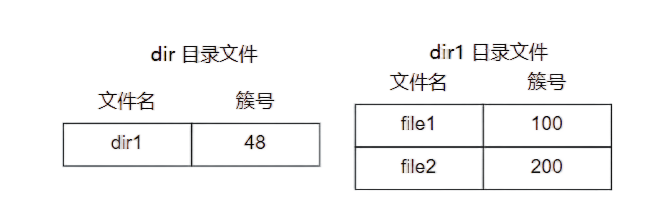
两个目录文件 dir 和 dir1 的内容如下表所示。

由于 FAT 的簇号为 2 个字节,即 16 比特,因此在 FAT 表中最多允许 2162^{16}(65536)个表项,一个 FAT 文件最多包含 2162^{16}(65536)个簇。FAT 的最大长度为 216×2B=128KB2^{16} \times 2B = 128KB。文件的最大长度是 216×4B=256MB2^{16} \times 4B = 256MB。

在 FAT 的每个表项中存放下一个簇号。file1 的簇号 106 存放在 FAT 的 100 号表项中,簇号 108 存放在 FAT 的 106 号表项中。

先在 dir 目录文件里找到 dir1 的簇号,然后读取 48 号簇,得到 dir1 目录文件,接着找到 file1 的第一个簇号,据此在 FAT 里查找 file1 的第 5000 个字节所在的簇号,最后访问磁盘中的该簇。因此,需要访问目录文件 dir1 所在的 48 号簇,及文件 file1 的 106 号簇。

进入练习